GitHub เปิดตัว Copilot Fusion? GitHub ประกาศเปิดตัว Copilot Fusion อย่างเป็นทางการเมื่อวันที่ 28 ตุลาคม 2026 โดยแนะนำตัวกำหนดเส้นทางและจัดระเบียบโมเดลแบบรันไทม์ที่ประสานการทำงานของโมเดลปัญญาประดิษฐ์หลายตัวสำหรับงานวิศวกรรมซอฟต์แวร์ ระบบนี้เปิดตัวในงานประชุมประจำปี GitHub Universe ที่ซานฟรานซิสโก โดยเปลี่ยนการเลือกโมเดลจากการตัดสินใจของนักพัฒนาแต่ละคนมาเป็นการให้แพลตฟอร์มวิเคราะห์ข้อกำหนดของงานและมอบหมายงานไปยังโมเดลพื้นฐานต่างๆ แบบไดนามิก เนื่องจากทีมวิศวกรรมซอฟต์แวร์ต้องเผชิญกับต้นทุน API ที่เพิ่มขึ้นและความเหนื่อยล้าทางความคิดจากการสลับไปมาระหว่างโมเดลแนวหน้าต่างๆ การจัดระเบียบโมเดลแบบอัตโนมัติจึงกลายเป็นรูปแบบสถาปัตยกรรมการดำเนินงานมาตรฐาน
การปรับโครงสร้างอุตสาหกรรมครั้งสำคัญ: GitHub เปิดตัว Copilot Fusion ในงาน Universe
สรุปสาระสำคัญ
- GitHub เปิดตัว Copilot Fusion สู่การใช้งานทั่วไปเมื่อวันที่ 28 ตุลาคม 2026 บน Visual Studio Code, Copilot CLI, JetBrains IDE และแอปพลิเคชันเดสก์ท็อป GitHub Copilot
- ระบบผสมผสานการประสานงานหลายโมเดลแบบรันไทม์ที่พัฒนามาจาก Project HydraFusion เข้ากับอัลกอริทึมการเลือกโมเดลอัตโนมัติที่ได้รับการปรับแต่งอย่างละเอียด
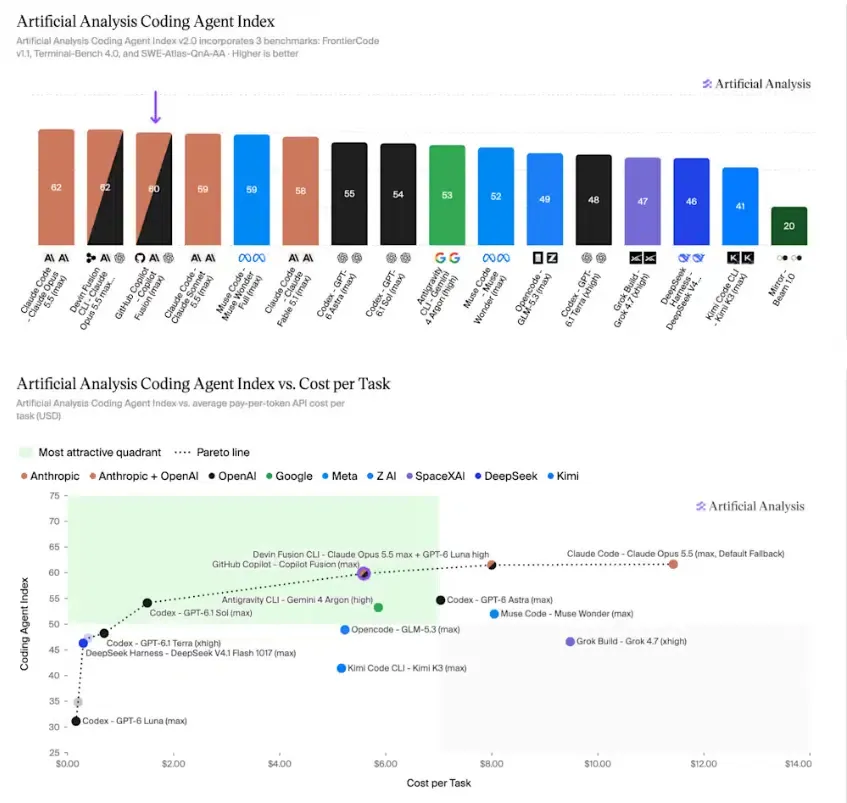
- จากการประเมินอิสระโดย Artificial Analysis พบว่า Fusion Max ทำคะแนนรวมได้ 60 บน Coding Agent Index v2.0 ซึ่งตามหลัง Claude Code ด้วย Opus 5.5 Max อยู่ 2 คะแนน แต่ช่วยลดต้นทุนของงานลงได้ประมาณ 51%
ทีมพัฒนาซอฟต์แวร์ที่ใช้ผู้ช่วยเขียนโค้ด AI ในอดีตมักทำงานภายใต้รูปแบบการเลือกด้วยตนเอง โปรแกรมเมอร์จะเลือกโมเดลเดี่ยว เช่น GPT-4o, Claude Sonnet หรือโมเดลการใช้เหตุผลในตระกูล o1 จากเมนูดรอปดาวน์ใน IDE และคงการเลือกนั้นไว้ตลอดทั้งเซสชันการเขียนโค้ด แม้จะมีประสิทธิภาพสำหรับการทำงานแบบเดี่ยว แต่รูปแบบนี้ก็นำมาซึ่งข้อแลกเปลี่ยนในการดำเนินงาน นักพัฒนามักเลือกโมเดลแนวหน้าระดับพรีเมียมที่มีความหน่วงสูงสำหรับการวางแผนสถาปัตยกรรมที่ซับซ้อน จากนั้นจึงลืมสลับกลับมาใช้โมเดลน้ำหนักเบาเมื่อต้องทำกิจวัตรประจำวัน เช่น การสร้างชุดทดสอบหน่วย (unit tests) หรือการเขียนเอกสารที่เป็นโครงสร้างมาตรฐาน
แนวทางแบบแมนนวลนี้อาจทำให้ค่าใช้จ่ายด้าน API ขององค์กรพุ่งสูงขึ้นและใช้โทเค็นบริบทได้อย่างไม่คุ้มค่า เพื่อแก้ปัญหาข้อแลกเปลี่ยนในเวิร์กโฟลว์เหล่านี้ GitHub จึงได้พัฒนา Copilot Fusion ดังที่ระบุไว้ใน ประกาศอย่างเป็นทางการของ GitHub แทนที่จะปฏิบัติกับการเขียนโค้ด AI เสมือนเป็นการโต้ตอบกับโมเดลคงที่ตัวเดียว แต่ Fusion ทำหน้าที่เป็นตัวประสานงานในระดับรันไทม์ นักพัฒนาจะกำหนดระดับความพยายามในการใช้เหตุผลภาพรวม และระบบจะเลือกโมเดลพื้นฐานหรือชุดโมเดลที่เหมาะสมที่สุดสำหรับแต่ละขั้นตอนของงานโดยอัตโนมัติ

การปรับเปลี่ยนกลยุทธ์ที่สะท้อนผ่านการเปิดตัว GitHub Copilot Fusion มุ่งเน้นไปที่เศรษฐศาสตร์ในระดับงาน มากกว่าการขยายขนาดพารามิเตอร์ดิบ จากการประเมินผลการเปรียบเทียบที่เผยแพร่โดย Artificial Analysis พบว่า Copilot Fusion Max ซึ่งทดสอบผ่าน Copilot CLI บน Coding Agent Index v2.0 สามารถทำงานเขียนโค้ดตามเกณฑ์มาตรฐานให้เสร็จสิ้นได้ด้วยต้นทุนเฉลี่ย $5.59 ต่อหนึ่งงาน เทียบกับ $11.42 ของ Claude Code ที่ใช้งาน Claude Opus 5.5 ของ Anthropic ที่การตั้งค่าสูงสุด การกำหนดค่าที่ได้รับการประเมินนี้ใช้โทเค็นประมาณ 7.2 ล้านโทเค็นต่อหนึ่งงาน ซึ่งคิดเป็นประมาณครึ่งหนึ่งของปริมาณโทเค็นของการกำหนดค่า Opus แบบสแตนด์อโลน ขณะที่ทำงานเสร็จเร็วขึ้นประมาณ 40%
ประสิทธิภาพมีความแตกต่างกันไปตามองค์ประกอบเกณฑ์มาตรฐานแต่ละรายการ โดย Fusion Max เป็นผู้นำบน Terminal-Bench 4.0 ด้วยคะแนน 71 แต่ได้ 51 คะแนนบน FrontierCode (ตามหลัง 56 คะแนนของ Claude Code) และ 57 คะแนนบน SWE-Atlas-QnA-AA นอกจากนี้ แม้ว่าผู้บริหารของ Microsoft จะอ้างถึงการประเมิน DeepSWE ภายในองค์กรที่แสดงให้เห็นถึงศักยภาพในการลดต้นทุนได้มากถึง 77% แต่ตัวเลขดังกล่าวเป็นเพียงสถานการณ์จำกัดสูงสุดตามรายงานของบริษัทแยกต่างหาก ไม่ใช่ค่าเฉลี่ยจากเกณฑ์มาตรฐานอิสระ ผลลัพธ์เหล่านี้ยืนยันว่าการจัดระเบียบโมเดลแบบหลายโมเดลแบบไดนามิกสามารถลดค่าใช้จ่ายในการพัฒนาสำหรับเวิร์กโฟลว์ที่รองรับได้อย่างมาก แม้ว่าการประหยัดที่แท้จริงจะขึ้นอยู่กับสัดส่วนของงาน ข้อกำหนดในการตรวจสอบ และรูปแบบการใช้งานขององค์กรก็ตาม
รูปแบบสถาปัตยกรรม: โทโพโลยีการประมวลผลแบบเดี่ยว แบบเรียงซ้อน และแบบวิจารณ์
Copilot Fusion ไม่ได้ทำงานเป็นโมเดลพื้นฐานอิสระ แต่ทำหน้าที่เป็นระนาบควบคุมอัจฉริยะที่ฝังอยู่ในฝั่งไคลเอนต์ของนักพัฒนา เมื่อผู้ใช้ส่งคำสั่งที่เกี่ยวข้องกับการใช้เหตุผล การสร้างโค้ด การดีบัก หรือการใช้งานเครื่องมือ Fusion จะประเมินสัญญาณความตั้งใจที่เข้ามาเทียบกับความสมบูรณ์ของระบบแบบเรียลไทม์ ความพร้อมใช้งาน และความซับซ้อนทางความหมาย
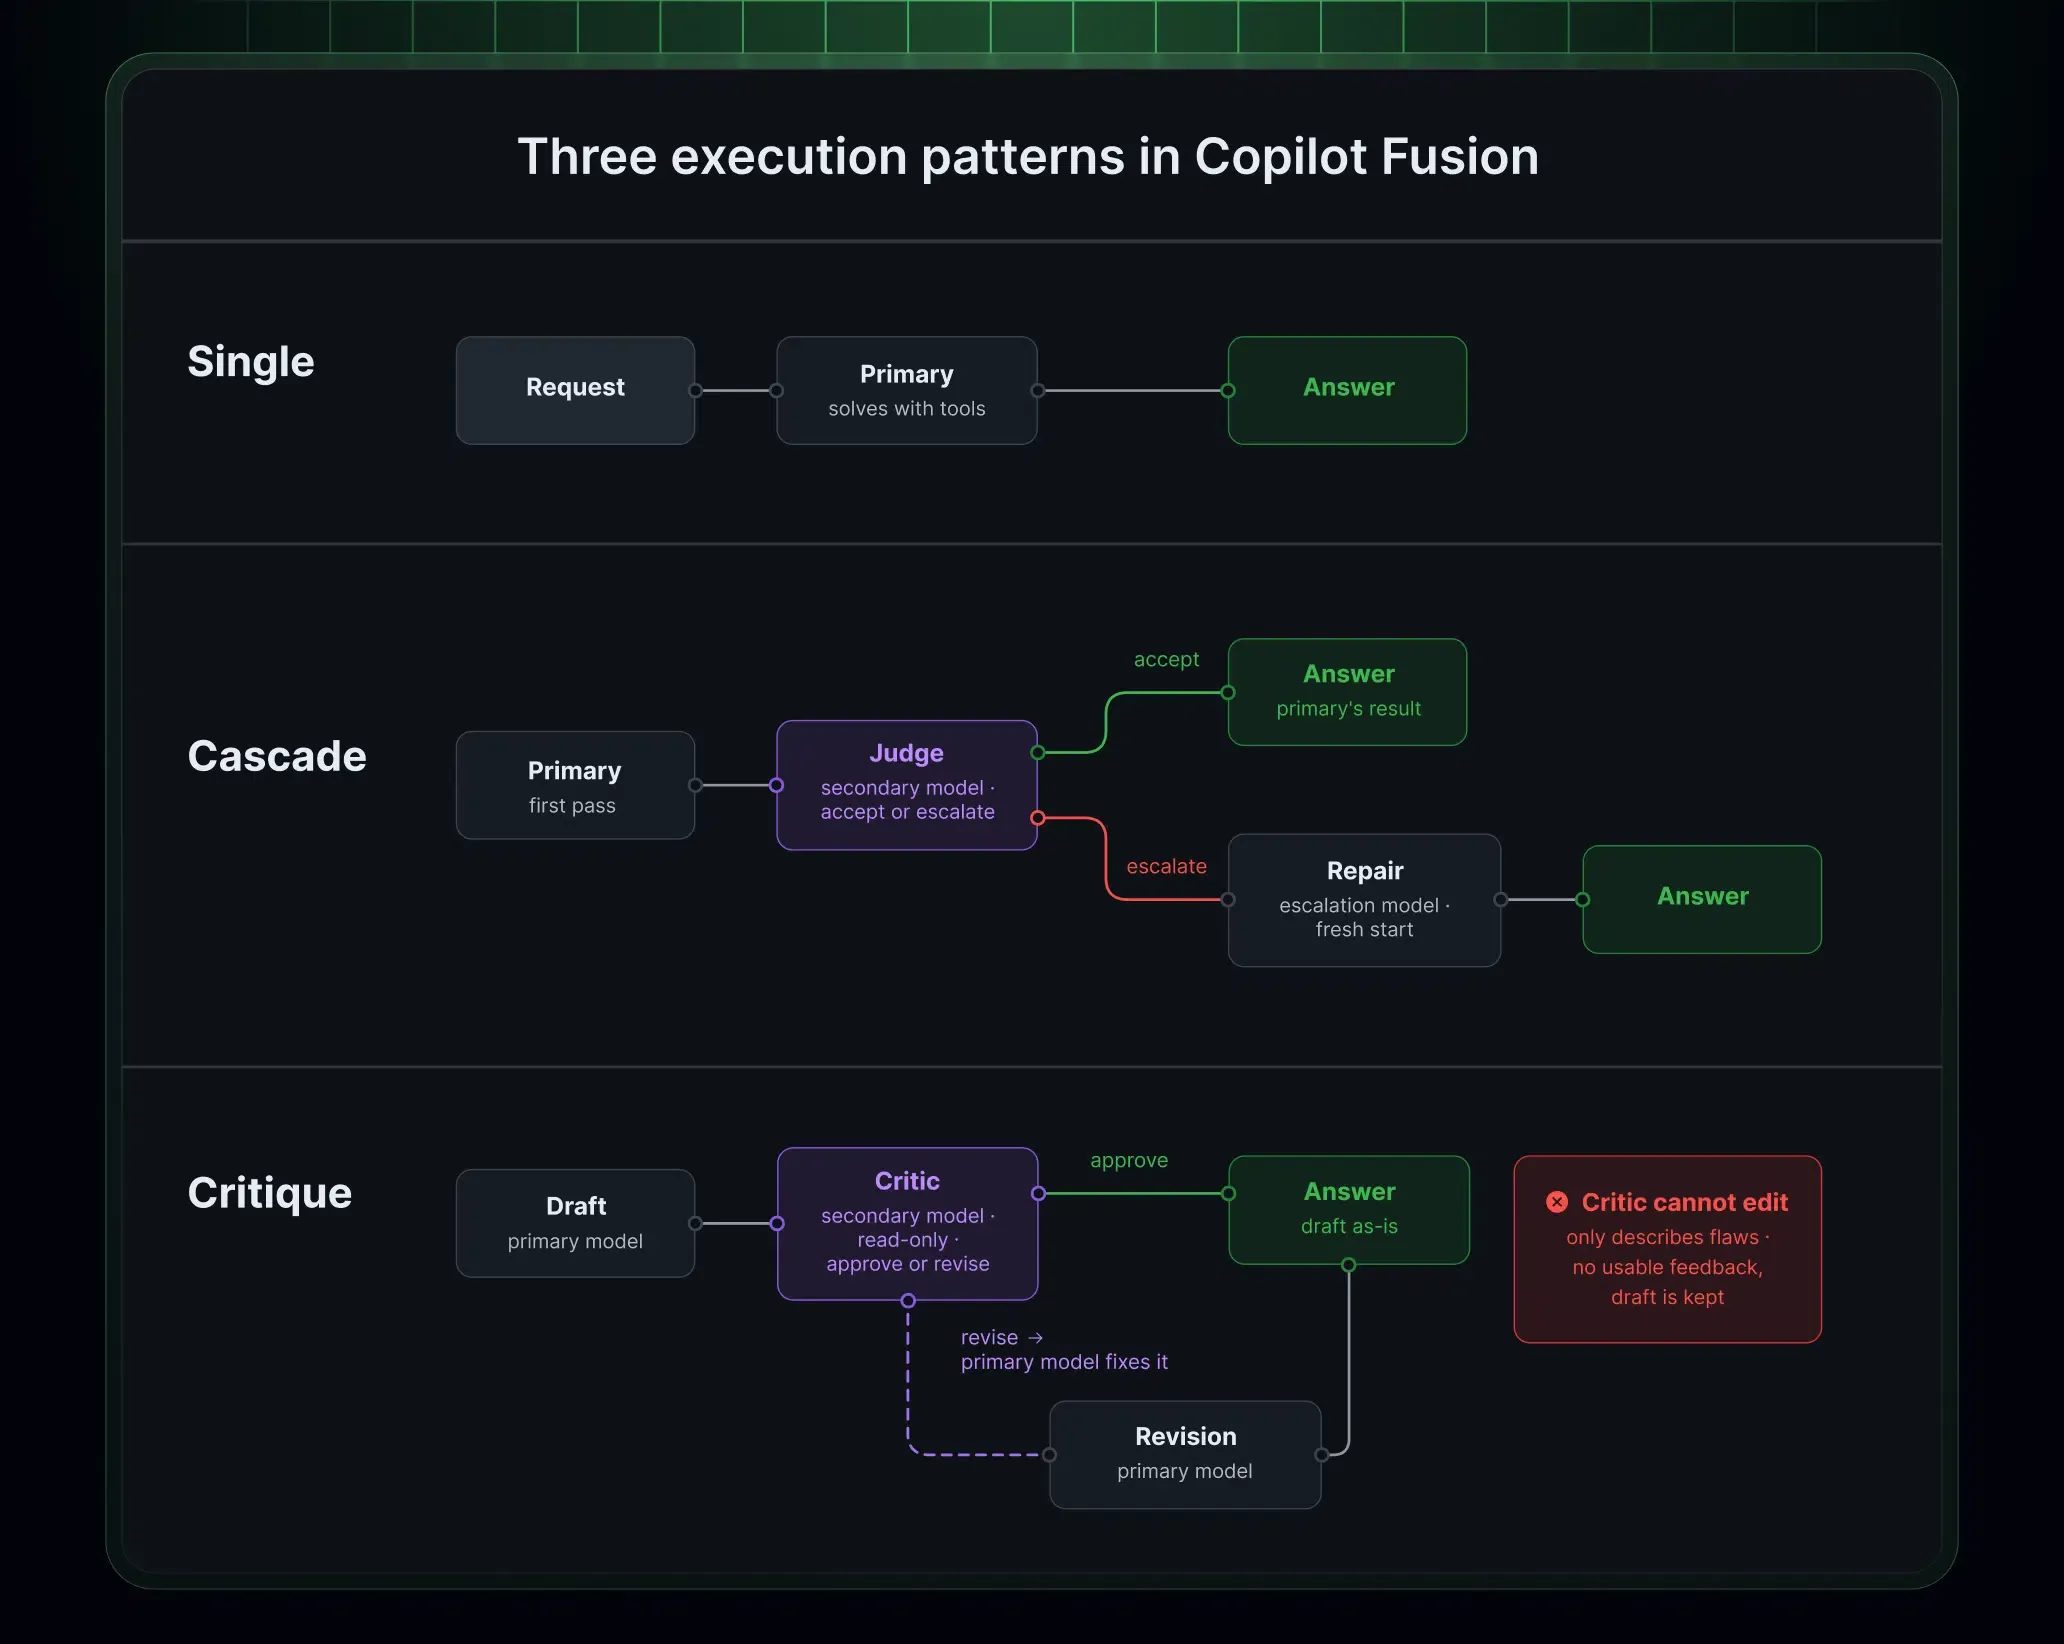
ขึ้นอยู่กับลักษณะของงานและระดับความพยายามที่เลือก ระบบจะเลือกหนึ่งในสามรูปแบบการประมวลผลแบบไดนามิก:
- รูปแบบเดี่ยว (Single Pattern): โมเดลตัวเดียวจะรับข้อความแจ้ง (prompt) และทำงานให้เสร็จสิ้นโดยตรง โดยไม่มีค่าใช้จ่ายเพิ่มเติมในการตรวจสอบ รูปแบบนี้เหมาะสำหรับการสร้างโค้ดที่ไม่ซับซ้อน การสอบถามทางไวยากรณ์ และการรีแฟกเตอร์พื้นฐาน
- รูปแบบเรียงซ้อน (Cascade Pattern): โมเดลน้ำหนักเบาจะร่างโซลูชันเริ่มต้นขึ้นมาก่อน จากนั้นโมเดลผู้ตัดสินทุติยภูมิจะตรวจสอบโค้ดที่เสนอและตัดสินใจว่าจะยอมรับผลลัพธ์หรือยกระดับงานไปยังโมเดลที่มีความสามารถสูงกว่าเพื่อให้การประมวลผลมีความละเมียดละไมยิ่งขึ้น
- รูปแบบวิจารณ์ (Critique Pattern): โมเดลหลักจะร่างคำตอบเริ่มต้นขึ้นมา ในขณะที่โมเดลผู้ตรวจสอบหนึ่งตัวหรือมากกว่าจะประเมินโค้ดอย่างเป็นอิสระควบคู่กันไป ตัวจัดระเบียบจะรวบรวมฟีดแบ็กของพวกเขา และโมเดลหลักจะทำการแก้ไขโค้ดตามความเหมาะสมก่อนที่จะส่งผลลัพธ์สุดท้ายกลับไปยังผู้ใช้
[Single Pattern]
  Prompt ──> Primary Model ──> Single Execution ──> Final Code Output

[Cascade Pattern]
  Prompt ──> Lightweight Model ──> Initial Draft ──> Judge Model ──[Accept]──> Final Code Output
                                                         └──[Escalate]──> Stronger Model ──> Final Output

[Critique Pattern]
  Prompt ──> Drafting Model ──> Initial Draft ──┬─> Reviewer Model A ──┐
                                                └─> Reviewer Model B ──┴─> Feedback Aggregator ──> Final Revision
โทโพโลยีการประมวลผลเหล่านี้แสดงให้เห็นถึงข้อแลกเปลี่ยนที่ชัดเจนระหว่างความเร็วในการประมวลผล ความเข้มงวดในการตรวจสอบ และต้นทุนในการคำนวณ แทนที่จะฮาร์ดโค้ดข้อความแจ้งให้เข้ากับรูปแบบเฉพาะ GitHub กลับทำการแมปเวิร์กโฟลว์เหล่านี้เข้ากับระดับความพยายามที่สามารถเลือกได้:
- Fusion Standard: สร้างความสมดุลระหว่างต้นทุน คุณภาพ และความหน่วงสำหรับการเขียนโค้ดประจำวัน การใช้งานปัจจุบันมักจะเลือกโมเดลหนึ่งตัวต่อหนึ่งงาน
- Fusion High: ให้ความสำคัญกับความสามารถที่แข็งแกร่งขึ้นและการใช้เหตุผลที่ลึกซึ้งยิ่งขึ้นสำหรับงานเขียนโค้ดขนาดใหญ่ พร้อมทั้งคำนึงถึงความคุ้มค่าของโทเค็น อาจมีการใช้การจัดระเบียบแบบหลายโมเดลเมื่อมีความจำเป็น
- Fusion Max: ให้ความสำคัญกับความสามารถระดับแนวหน้าสำหรับงานที่ต้องการความเข้มงวดสูงสุด พร้อมเพิ่มขั้นตอนการตรวจสอบหรือการยกระดับที่เลือกสรรแบบไดนามิกตามความเหมาะสม
- Fusion Fast: ระดับความพยายามพิเศษที่ไม่ใช่ตัวเลือกของผู้ใช้ ซึ่งใช้ในสถานการณ์แชทอินไลน์ของ Visual Studio Code ที่มีความไวต่อความหน่วงและได้รับการสนับสนุน
การจัดการขอบเขตบริบทข้ามเวิร์กโฟลว์แบบไดนามิกจำเป็นต้องมีการจัดการหน่วยความจำพิเศษ Copilot Fusion ไม่มีหน้าต่างบริบทแบบรวมเป็นหนึ่งเดียวในตัวเอง แต่ทุกขั้นตอนการประมวลผลจะทำงานอย่างเคร่งครัดภายใต้ขีดจำกัดบริบทของโมเดลเฉพาะที่กำลังดำเนินการย่อยงานนั้นๆ ความจุของบริบทที่แสดงใน IDE สะท้อนถึงขีดจำกัดที่อนุรักษ์นิยมที่สุดในบรรดาโมเดลที่เข้าร่วม นอกจากนี้ เพื่อเพิ่มประสิทธิภาพการแคชข้อความแจ้งให้สูงสุด Fusion จะรักษาเธรดการสนทนาหลักไว้บนโมเดลหลักตัวเดียวทุกครั้งที่เป็นไปได้ โดยจะส่งเฉพาะหน้าต่างบริบทที่จำเป็นและแยกส่วนไปยังโมเดลผู้ตรวจสอบที่ให้ความช่วยเหลือเท่านั้น
การกำกับดูแลระดับองค์กรและการผสานรวมโมเดลท้องถิ่นทั่วทั้งกลุ่มเครื่องมือนักพัฒนา
การปรับใช้การจัดระเบียบโมเดลแบบอัตโนมัติทั่วทั้งองค์กรวิศวกรรมขนาดใหญ่มาพร้อมกับการพิจารณาในด้านการกำกับดูแล การปฏิบัติตามกฎระเบียบ และงบประมาณ เมื่อระบบ AI ทำการเลือกโมเดลแบบไดนามิกจาก Anthropic, OpenAI และผู้ให้บริการรายอื่นๆ ผู้ดูแลระบบต้องมั่นใจว่ากฎการเก็บรักษาข้อมูลและความปลอดภัยขององค์กรยังคงอยู่ครบถ้วน
ผู้ดูแลระบบระดับองค์กรสามารถจัดการโมเดลที่มีสิทธิ์ใช้งานสำหรับ Copilot Fusion ได้ผ่านนโยบายโมเดลของ GitHub Copilot และการตั้งค่าที่จัดการโดยองค์กร ดังที่บันทึกไว้ใน คู่มือการจัดการ Copilot Fusion ผู้ดูแลระบบสามารถดูรายชื่อโมเดลที่ใช้งานได้สำหรับ Fusion กำหนดระดับความพยายามเริ่มต้นสำหรับที่นั่งของนักพัฒนาแต่ละคน และปิดใช้งานโมเดลเฉพาะสำหรับ Fusion โดยไม่ต้องปิดใช้งานทั่วทั้งบริษัท Fusion เคารพข้อจำกัดที่เกี่ยวข้องกับการสมัครสมาชิก องค์กร การเก็บรักษาข้อมูล ข้อกำหนดที่เกี่ยวข้องกับ FedRAMP และโมเดลการประเมิน การควบคุมเหล่านี้ทำหน้าที่กำกับดูแลสิทธิ์ของโมเดลภายในระบบ แต่ไม่ได้มาแทนที่กระบวนการตรวจสอบการปฏิบัติตามกฎระเบียบ การกำกับดูแลข้อมูล หรือการตรวจสอบความปลอดภัยขององค์กรเอง
ตารางด้านล่างแสดงให้เห็นว่าสถาปัตยกรรมการประมวลผลที่แตกต่างกันสร้างความสมดุลระหว่างพื้นผิวการประมวลผล กลไกการตรวจสอบ และโปรไฟล์ค่าใช้จ่ายด้านโทเค็นอย่างไร:
| รูปแบบการประมวลผล | การเรียกใช้งานหลัก | กลไกการตรวจสอบ | โปรไฟล์ต้นทุนโทเค็น | ดีที่สุดสำหรับ |
|---|---|---|---|---|
| โหมดเดี่ยว (Single Mode) | โมเดลเฉพาะตัวเดียว | ไม่มี | ราคารุ่นมาตรฐานพื้นฐาน | การแก้ไขโค้ดที่ไม่ซับซ้อนและคำถามเกี่ยวกับไวยากรณ์ |
| โหมดเรียงซ้อน (Cascade Mode) | โมเดลร่างที่มีประสิทธิภาพ | การตรวจสอบโดยโมเดลผู้ตัดสินและการยกระดับ | ต่ำถึงปานกลาง (การยกระดับแบบมีเงื่อนไข) | การแก้ไขบั๊กที่มีขอบเขตชัดเจนและการปรับเปลี่ยนที่มีโครงสร้าง |
| โหมดวิจารณ์ (Critique Mode) | เครื่องมือสร้างหลัก | โมเดลผู้ตรวจสอบอิสระแบบขนาน | สูง (การเรียกใช้งานโมเดลหลายตัวพร้อมกัน) | ตรรกะสถาปัตยกรรมที่ซับซ้อนและโค้ดที่ละเอียดอ่อนด้านความปลอดภัย |
| ไฮบริดโมเดลท้องถิ่น (Local Model Hybrid) | โมเดลบนอุปกรณ์ที่รองรับ | การเลือกโมเดลที่ประสานงานผ่านคลาวด์ | การใช้โทเค็นบนคลาวด์ลดลงในขั้นตอนภายในเครื่อง | การอนุมานบนอุปกรณ์ที่มีสิทธิ์ร่วมกับการกำหนดเส้นทางที่ประสานงานผ่านคลาวด์ |
GitHub ได้แนะนำการกำหนดเส้นทางที่รับรู้โมเดลท้องถิ่นเป็นพรีวิวทดลองแบบเลือกเข้าร่วม (opt-in) ดังที่ประกาศไว้ใน GitHub Changelog เกี่ยวกับการเลือกโมเดลท้องถิ่น เมื่อกำหนดค่าโมเดลท้องถิ่นที่รองรับแล้ว Copilot Fusion Standard อาจเลือกการอนุมานบนอุปกรณ์สำหรับงานที่มีสิทธิ์ ซึ่งช่วยลดการใช้โมเดลคลาวด์สำหรับขั้นตอนเหล่านั้น บนระบบ Windows ที่มีฮาร์ดแวร์ที่เข้ากันได้ นักพัฒนาสามารถติดตั้งและรัน MAI Code 1.1 Flash ผ่านการจัดการ Windows ML ภายในแอป Copilot, Copilot CLI หรือ Visual Studio Code ผู้ใช้แบบข้ามแพลตฟอร์มบน Windows, macOS และ Linux สามารถกำหนดค่าโมเดลท้องถิ่น เช่น Qwen3.8 Flash Next ใน Copilot CLI โดยใช้ผู้ให้บริการโมเดลท้องถิ่นอย่าง Ollama และเปิดใช้งาน CLI ด้วยแฟล็ก --experimental
อย่างไรก็ตาม Copilot Fusion ยังคงต้องอาศัยการตัดสินใจกำหนดเส้นทางบนคลาวด์ และงานต่างๆ อาจใช้โมเดลคลาวด์เมื่อมีความเหมาะสม ดังนั้นการสนับสนุนโมเดลท้องถิ่นจึงไม่ได้ทำให้ Copilot Fusion กลายเป็นสภาพแวดล้อมการเขียนโค้ดแบบออฟไลน์เต็มรูปแบบ นักพัฒนาที่ต้องการความปลอดภัยแบบตัดขาดจากอินเทอร์เน็ต (air-gapped) ควรพิจารณาใช้เครื่องมือออฟไลน์โดยเฉพาะแทน
เช็คลิสต์ทางวิศวกรรม: การนำการจัดระเบียบโมเดลแบบหลายโมเดลไปใช้ในการผลิตจริง
การผสานรวมการจัดระเบียบโมเดลแบบหลายโมเดลในระดับรันไทม์เข้ากับเวิร์กโฟลว์การพัฒนาซอฟต์แวร์จำเป็นต้องมีการปรับเปลี่ยนทั้งในส่วนของพฤติกรรมของนักพัฒนา การกำหนดค่า IDE และการดำเนินงานทางการเงินขององค์กร ผู้นำทางวิศวกรรมต้องกำหนดระเบียบปฏิบัติด้านการดำเนินงานที่ชัดเจนเพื่อให้ได้รับประโยชน์สูงสุดจากความคุ้มค่าของโทเค็น พร้อมทั้งหลีกเลี่ยงข้อผิดพลาดในเวิร์กโฟลว์
เช็คลิสต์การใช้งานสำหรับนักพัฒนา
- ตรวจสอบผลต่างของพื้นที่ทำงานก่อนทำการคอมมิต: การปฏิเสธร่างโค้ด AI จะไม่ทำการย้อนกลับการแก้ไขไฟล์ในพื้นที่ทำงานโดยอัตโนมัติ นักพัฒนาต้องตรวจสอบการแก้ไขไฟล์ทั้งหมดที่ยังไม่ได้คอมมิตก่อนที่จะส่งโค้ด
- จับคู่ระดับความพยายามให้เข้ากับความซับซ้อนของงาน: สงวน Fusion Max ไว้สำหรับตรรกะอัลกอริทึมที่ซับซ้อนและการตรวจสอบความปลอดภัย และใช้ Fusion Standard สำหรับการเขียนโค้ดประจำวันเพื่อป้องกันการใช้เครดิต AI โดยไม่จำเป็น
- ตรวจสอบสตรีมความคืบหน้าของหลายโมเดล: สังเกตตัวบ่งชี้ความคืบหน้าของ IDE เพื่อตรวจสอบว่าโมเดลเฉพาะตัวใดที่มีส่วนร่วมในการสร้างบล็อกโค้ด เพื่อความโปร่งใสในแต่ละขั้นตอนการประมวลผล
- กำหนดค่าโมเดลท้องถิ่นที่รองรับ: สำหรับงานที่มีสิทธิ์บน Fusion Standard ให้ตั้งค่าโมเดลท้องถิ่นที่รองรับ เช่น MAI Code 1.1 Flash บน Windows หรือ Qwen3.8 Flash Next ผ่าน Ollama และเปิดใช้งานการตั้งค่าทดลองตามความจำเป็น
เช็คลิสต์การกำกับดูแลระดับองค์กรและ FinOps
- กำหนดค่านโยบายโมเดลขององค์กร: ระบุว่าโมเดลใดมีสิทธิ์สำหรับการกำหนดเส้นทางของ Fusion ในแดชบอร์ดขององค์กร เพื่อให้รายชื่อโมเดลสอดคล้องกับการปฏิบัติตามกฎระเบียบขององค์กรและข้อกำหนดการเก็บรักษาข้อมูล
- ตรวจสอบเครดิต AI ตามการใช้งาน: ติดตามการใช้เครดิตในระดับทีมตามระดับความพยายาม โดยคำนึงถึงความจริงที่ว่าการประมวลผลแบบหลายโมเดลใน Fusion High และ Max สามารถใช้เครดิตต่อหนึ่งงานมากกว่าการประมวลผลแบบโมเดลเดี่ยว
- คำนึงถึงช่วงเวลาการเรียกเก็บเงินแบบส่งเสริมการขาย: นำส่วนลดส่งเสริมการขาย 30% ของ GitHub สำหรับต้นทุนโมเดลสำหรับผู้สมัครสมาชิก Copilot แบบชำระเงินจนถึงวันที่ 30 พฤศจิกายน 2026 มาคำนวณร่วมด้วยเมื่อประเมินค่าใช้จ่ายในการดำเนินงาน
- สร้างจุดตรวจสอบการรีวิวโค้ดโดยมนุษย์: กำหนดให้มีการตรวจสอบโค้ดร่วมกัน (peer review) เป็นภาคบังคับสำหรับคำขอพูลรีเควสต์ (pull requests) ที่สร้างโดยเอเจนต์ทั้งหมด เพื่อให้มั่นใจว่าลูปการวิจารณ์แบบอัตโนมัติทำหน้าที่เสริมการควบคุมดูแลทางวิศวกรรมของมนุษย์ ไม่ใช่มาแทนที่
คำถามที่พบบ่อย (FAQ)
GitHub คำนวณการเรียกเก็บเงินอย่างไรเมื่อ Copilot Fusion เรียกใช้งานโมเดลหลายตัว?
จะเกิดอะไรขึ้นหาก Copilot Fusion ปฏิเสธร่างโค้ดขั้นกลาง?
ผู้ดูแลระบบระดับองค์กรสามารถจำกัดโมเดลที่ Copilot Fusion เลือกได้หรือไม่?
ประเด็นสำคัญสำหรับทีมวิศวกรรม
การเปิดตัว GitHub Copilot Fusion ยืนยันว่าการพึ่งพาโมเดล AI แบบเสาหิน (monolithic) เพียงตัวเดียวสำหรับงานวิศวกรรมซอฟต์แวร์ที่ซับซ้อนนั้นนำมาซึ่งข้อแลกเปลี่ยนในการดำเนินงานที่ไม่จำเป็น เวิร์กโฟลว์การพัฒนาสมัยใหม่ครอบคลุมความต้องการทางความคิดที่หลากหลาย ตั้งแต่การเติมเต็มไวยากรณ์ทันทีไปจนถึงการใช้เหตุผลข้ามที่เก็บโค้ดที่ซับซ้อน การบังคับให้สถาปัตยกรรมโมเดลตัวเดียวรองรับขอบเขตทั้งหมดนี้อาจนำไปสู่ค่าใช้จ่ายด้านโมเดลที่พุ่งสูงขึ้นหรือคุณภาพการประมวลผลที่ลดลง
ผลลัพธ์จากเกณฑ์มาตรฐานอิสระชี้ให้เห็นว่าการจัดระเบียบแบบหลายโมเดลสามารถมอบประสิทธิภาพการเขียนโค้ดที่แข่งขันได้ภายใต้ต้นทุนโมเดลที่ต่ำลงสำหรับเวิร์กโหลดบางประเภท ผลลัพธ์ที่แท้จริงจะขึ้นอยู่กับความซับซ้อนของงาน พฤติกรรมการจัดระเบียบ โมเดลที่เลือก และรูปแบบการใช้งานขององค์กร ด้วยการแยกการมอบหมายงานออกจากการเลือกแบบแมนนวลของนักพัฒนา การจัดระเบียบโมเดลแบบรันไทม์จึงสร้างแนวทางปฏิบัติในการดำเนินงานที่ใช้ได้จริง ในขณะที่องค์กรวิศวกรรมซอฟต์แวร์ขยายขนาดเอเจนต์เขียนโค้ดแบบอัตโนมัติ ความแตกต่างทางการแข่งขันหลักจะไม่ใช่การเข้าถึงโมเดลพื้นฐานตัวใดตัวหนึ่ง แต่จะเป็นการกำกับดูแล ความน่าเชื่อถือ และความเข้มงวดทางสถาปัตยกรรมของเลเยอร์การจัดระเบียบที่เชื่อมต่อโมเดลเหล่านั้นเข้าด้วยกัน
เอกสารอ้างอิง
-
GitHub: Route and Orchestrate Models with GitHub Copilot Fusion — บันทึกประจำรุ่นอย่างเป็นทางการและภาพรวมฟีเจอร์จากงาน GitHub Universe 2026
-
GitHub: Copilot Fusion Now Supports Selection of Local Models — ประกาศอย่างเป็นทางการที่ให้รายละเอียดเกี่ยวกับการอนุมานบนอุปกรณ์สำหรับงานที่มีสิทธิ์ด้วยการกำหนดเส้นทางโมเดลท้องถิ่น
-
GitHub Docs: About GitHub Copilot Fusion Concepts and Configuration — เอกสารทางเทคนิคอย่างเป็นทางการที่ให้รายละเอียดเกี่ยวกับรูปแบบการประมวลผล ระดับความพยายาม และกฎการเรียกเก็บเงิน
-
GitHub Docs: Configuring Models Available for Copilot Fusion — คำแนะนำสำหรับผู้ดูแลระบบในการจัดการนโยบายโมเดลระดับองค์กรและการตั้งค่าเริ่มต้น
-
Artificial Analysis: GitHub Copilot Fusion Benchmark Evaluation — การวิเคราะห์อิสระที่วัดต้นทุนของงาน ประสิทธิภาพของโทเค็น และคะแนน Coding Agent Index
-
The New Stack: GitHub Debuts Copilot Fusion Multi-Model System — รายงานทางเทคนิคเกี่ยวกับการผสานรวม Project HydraFusion และการนำไปใช้งานของลูกค้าองค์กร
-
VentureBeat: GitHub Copilot Fusion Mixes Models for Cost Efficiency — การสัมภาษณ์ทางเทคนิคกับผู้นำฝ่ายผลิตภัณฑ์ของ GitHub ครอบคลุมสถาปัตยกรรมการกำหนดเส้นทางระดับรันไทม์
Share this article



