OpenAI và Google ủng hộ cơ chế từ chối đào tạo AI chung? OpenAI, Google và Microsoft đã công bố kế hoạch vào ngày 30 tháng 10 năm 2026 về việc tuân thủ một token chính sách chung duy nhất trong tệp robots.txt, cho phép các đơn vị vận hành trang web thể hiện tùy chọn đào tạo mô hình trí tuệ nhân tạo tạo sinh trên nhiều nhà cung cấp cùng lúc. Cơ chế đề xuất này bắt nguồn từ một Bản thảo Internet cá nhân được gửi lên nhóm làm việc về Sở thích AI của IETF bởi kỹ sư Kevin Kelley thuộc Anthropic. Mặc dù sáng kiến này cung cấp cho các nhà xuất bản một phương pháp tối ưu để tuyên bố từ chối đào tạo bằng cú pháp Allow và Disallow tiêu chuẩn, lịch trình triển khai vẫn kéo dài sang năm 2027 và mỗi nền tảng lớn dự kiến sẽ diễn giải và áp dụng tín hiệu này theo các cách khác nhau trong việc đào tạo mô hình cũng như neo giữ trò chuyện trực tiếp.
Sắp xếp lại cấu trúc cốt lõi của ngành: Các phòng thí nghiệm AI lớn phối hợp về tiêu chuẩn Robots.txt
Tổng quan nhanh
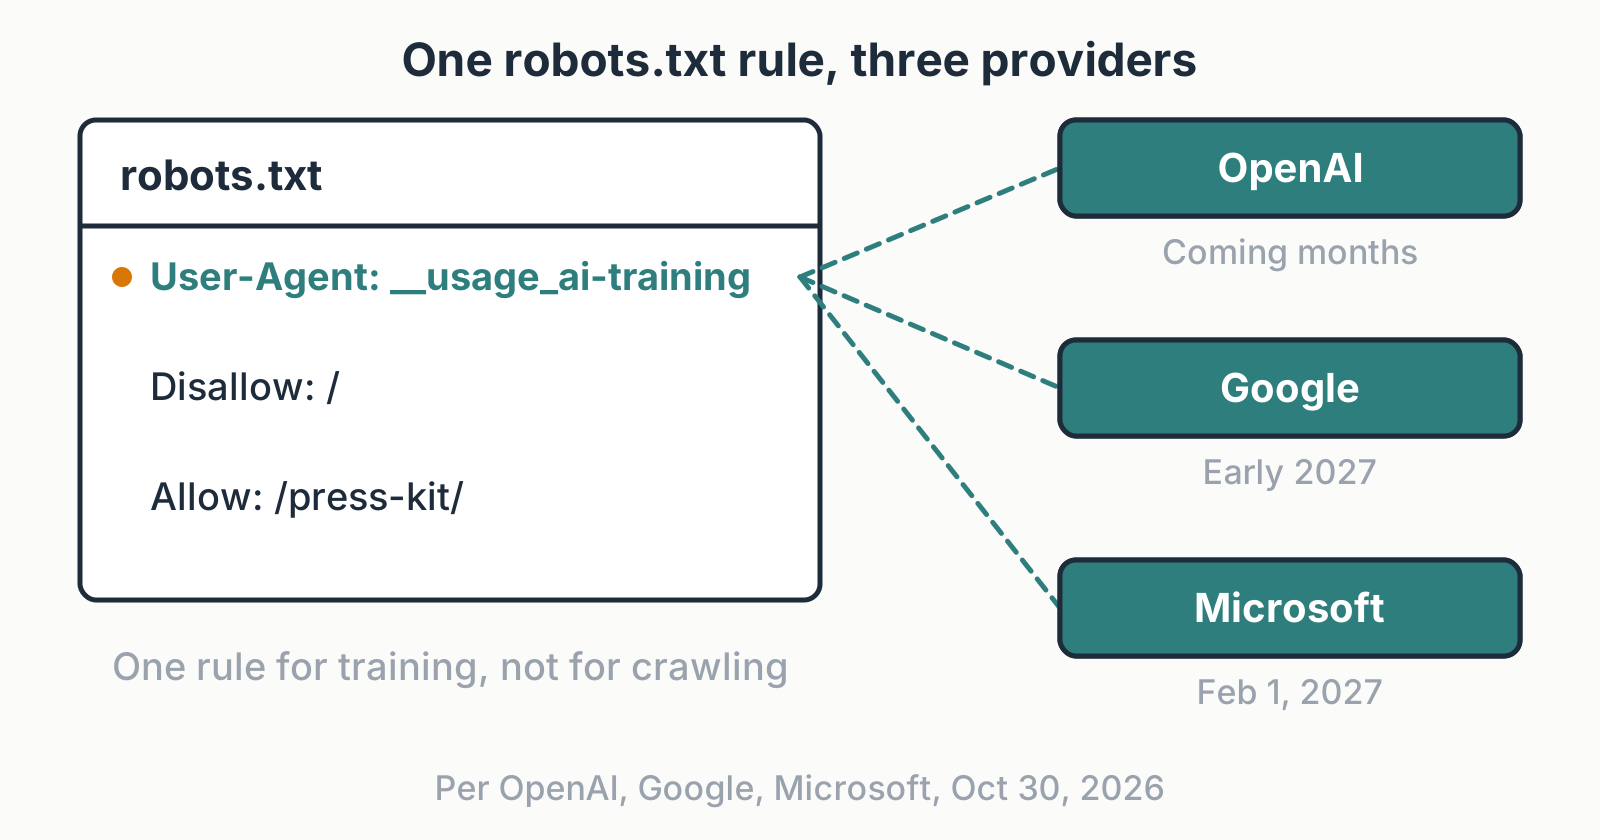
- OpenAI, Google và Microsoft đã công bố kế hoạch phối hợp vào ngày 30 tháng 10 năm 2026 nhằm công nhận một token chính sách robots.txt chung,
__usage_ai-training, để quản lý các tùy chọn đào tạo mô hình tạo sinh. - Tín hiệu này được định nghĩa trong Bản thảo Internet IETF cá nhân do kỹ sư Kevin Kelley của Anthropic soạn thảo, thiết lập cú pháp chuẩn hóa nhưng chưa phải là tiêu chuẩn RFC chính thức hoặc hoàn thiện của IETF.
- Lịch trình áp dụng của các nền tảng có sự khác biệt đáng kể: Anthropic đã bắt đầu công việc kỹ thuật nội bộ, OpenAI hướng tới mục tiêu triển khai trong những tháng tới, Microsoft bắt đầu từ ngày 1 tháng 2 năm 2027 và Google dự kiến hỗ trợ vào năm 2027.
Trong gần ba mươi năm, Giao thức loại trừ robot (Robots Exclusion Protocol) đã chi phối cách thức các trình thu thập thông tin web tự động tương tác với nội dung trực tuyến công khai. Quản trị viên trang web đã đặt một tệp văn bản thuần túy robots.txt đơn giản trong thư mục gốc của họ, xác định tác nhân người dùng của công cụ tìm kiếm nào có quyền nạp các đường dẫn URL cụ thể. Giao thức này hoạt động dựa trên một thỏa thuận thương mại cơ bản: các nhà xuất bản trang web cho phép các trình thu thập thông tin lập chỉ mục nội dung của họ để đổi lấy khả năng hiển thị, lưu lượng truy cập giới thiệu đi và mức độ hiển thị thương hiệu trên các trang kết quả của công cụ tìm kiếm.
Sự trỗi dậy nhanh chóng của trí tuệ nhân tạo tạo sinh đã phá vỡ mô hình kinh tế đó. Các công cụ thu thập dữ liệu tự động được triển khai bởi các phòng thí nghiệm AI tiên phong đã bắt đầu tiếp nhận các miền web để đào tạo các mô hình nền tảng, thường tóm tắt nội dung gốc trực tiếp trong các giao diện câu trả lời mà không mang lại lượt nhấp chuyển tiếp cho nhà xuất bản. Chủ sở hữu nội dung muốn ngăn chặn việc tài sản trí tuệ của họ bị tiếp nhận buộc phải duy trì các danh sách phân mảnh, phức tạp gồm các tác nhân người dùng độc quyền, bao gồm GPTBot, ClaudeBot và Google-Extended. Chi phí vận hành này làm tăng rủi ro xảy ra lỗi cấu hình hoặc vô tình hủy lập chỉ mục tìm kiếm khi quản lý đồng thời nhiều chỉ thị trình thu thập thông tin.

Sự xuất hiện của cơ chế từ chối đào tạo AI chung đánh dấu một sự dịch chuyển đáng kể từ việc chặn nhà cung cấp phân mảnh sang quản trị giao thức hợp tác. Bằng cách phối hợp hỗ trợ xung quanh một token chính sách chung, các nhà cung cấp AI lớn hướng đến mục tiêu giảm rào cản kỹ thuật cho những người sáng tạo nội dung muốn thiết lập các ranh giới rõ ràng liên quan đến việc đào tạo mô hình tạo sinh. Theo thông báo chính thức từ Google Search Central, quy tắc duy nhất này cho phép quản trị viên trang web tuyên bố lập trường đào tạo AI tạo sinh của họ trong một bước, thay vì theo dõi và cấu hình các chỉ thị riêng biệt cho từng trình thu thập thông tin AI thương mại đang thâm nhập thị trường.
Cơ chế kiến trúc bên trong: Cách thức hoạt động của Token __usage_ai-training
Kiến trúc kỹ thuật đằng sau tín hiệu tùy chọn chung được quy định trong Bản thảo Internet IETF về Tín hiệu Tùy chọn Đào tạo có thể đọc được bằng máy. Quan trọng là bản thảo không giới thiệu các chỉ thị mới lạ hoặc thay đổi ngữ pháp cơ bản của Giao thức loại trừ robot được định nghĩa trong RFC 9309. Thay vào đó, nó tái sử dụng bản ghi User-Agent tiêu chuẩn bằng cách chỉ định một token chính sách được dành riêng: __usage_ai-training.
Để cấu hình tính năng từ chối, quản trị viên web tạo một khối quy tắc thông thường chỉ định token chính sách này làm tác nhân người dùng, theo sau là các quy tắc Disallow và Allow tiêu chuẩn. Ví dụ dưới đây minh họa cách chủ sở hữu trang web thể hiện việc từ chối trên tất cả các thư mục trang web trong khi vẫn giữ lại ngoại lệ cho tài liệu quảng cáo công khai:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Định nghĩa ngữ nghĩa về những gì cấu thành “đào tạo AI” được neo giữ trong các thông số kỹ thuật từ vựng nền tảng của nhóm làm việc IETF. Theo khung này, đào tạo được định nghĩa nghiêm ngặt là việc sử dụng nội dung web được thu thập để sửa đổi hoặc tinh chỉnh các tham số và trọng số đã học của một mô hình trí tuệ nhân tạo tạo sinh. Các hoạt động tính toán không phải tạo sinh, chẳng hạn như phân loại tài liệu tiêu chuẩn, xếp hạng chỉ mục tìm kiếm, sửa lỗi chính tả và lọc thư rác, bị loại trừ rõ ràng khỏi định nghĩa này.
Ranh giới giao thức: Thu thập thông tin so với Đào tạo so với Neo giữ
Việc hiểu rõ các giới hạn vận hành của token được đề xuất này đòi hỏi phải tách biệt các giai đoạn tiếp nhận dữ liệu tự động khác nhau:
[Nội dung Web Công khai]
       │
       ▼
[1. Thu thập / Nạp qua HTTP] ──> Chi phối bởi các User-Agent trình thu thập cụ thể (ví dụ: GPTBot, Bingbot)
       │                    *__usage_ai-training KHÔNG chi phối hành vi nạp HTTP*
       ├────────────────────────────────────────┐
       ▼                                        ▼
[2. Sử dụng Đào tạo Mô hình]             [3. Neo giữ Trực tiếp / RAG]
   *__usage_ai-training: Disallow*          *Chi phối bởi thẻ trang & cài đặt nhà cung cấp*
   Báo hiệu tùy chọn không muốn đào tạo      Cung cấp ngữ cảnh web thời gian thực cho mô hình AI
       │                                        │
       ▼                                        ▼
   Việc thực thi phụ thuộc vào              Tiêu chí đủ điều kiện được thiết lập bởi
   các nhà cung cấp AI tham gia             chính sách của từng nền tảng
Các nhóm kỹ thuật phải đánh giá bốn ranh giới cấu trúc vốn có trong thông số kỹ thuật bản thảo này:
- Tín hiệu chi phối việc đào tạo, không phải việc thu thập thông tin: Token chính sách không phải là chỉ thị cho hành vi thu thập thông tin mạng. Trình thu thập thông tin AI gặp phải
Disallow: /theo__usage_ai-trainingvẫn được phép nạp tài liệu HTML qua HTTP. Nó chỉ đơn giản được hướng dẫn là không đưa văn bản được truy xuất đó vào các luồng đào tạo mô hình. Để ngăn bot yêu cầu URL hoàn toàn, quản trị viên phải tiếp tục chặn tên nhận dạng cụ thể của trình thu thập thông tin đó. - Quy tắc đại diện ký tự đại diện (wildcard) không được áp dụng: Các khối ký tự đại diện chung, chẳng hạn như
User-Agent: *theo sau làDisallow: /, không khớp với token chính sách. Bản thảo yêu cầu các nhà cung cấp AI tham gia không được diễn giải nhóm ký tự đại diện phổ biến là biểu hiện của tùy chọn đào tạo AI. Nếu một tệp bỏ qua token__usage_ai-trainingrõ ràng, tiêu chuẩn sẽ diễn giải trang web là không bày tỏ tùy chọn đào tạo nào. - Không có tính năng hủy đào tạo mô hình hồi tố: Việc cập nhật tệp
robots.txtcủa trang web hoạt động tiến về phía trước theo thời gian. Nó cung cấp tín hiệu cho các chu kỳ thu thập và đào tạo trong tương lai nhưng không bắt buộc phòng thí nghiệm AI phải xóa dữ liệu đã được tích hợp vào các tập dữ liệu đào tạo lịch sử hoặc xóa trọng số từ các mô hình nền tảng có sẵn từ trước. - Phối hợp tự nguyện vượt qua việc thực thi kỹ thuật: Tín hiệu thể hiện sở thích của nhà xuất bản; nó không cung cấp khả năng thực thi kỹ thuật chống lại người tiêu dùng dữ liệu không tham gia hoặc không tuân thủ. Theo các nguyên tắc của RFC 9309, robots.txt vẫn là một cơ chế cố vấn hợp tác thay vì là bức tường lửa kiểm soát quyền truy cập.
Sự khác biệt trong việc triển khai của nhà cung cấp và lịch trình di chuyển
Mặc dù Google, Microsoft và OpenAI đã công bố kế hoạch hỗ trợ tín hiệu chung, nhưng việc triển khai kỹ thuật và lịch trình triển khai của họ có sự khác biệt đáng kể. Mỗi nhà cung cấp tiếp cận sự cân bằng giữa việc lập chỉ mục của công cụ tìm kiếm, đào tạo mô hình tạo sinh và tạo sinh tăng cường truy xuất (RAG) thông qua cơ sở hạ tầng sản phẩm của riêng mình.
Bảng dưới đây đối chiếu các cam kết đã được xác nhận của nền tảng, quy tắc diễn giải và lịch trình di chuyển:
| Nền tảng | Trạng thái đã xác nhận & Lịch trình | Diễn giải Token Chính sách | Xử lý Neo giữ & Truy xuất | Di chuyển Thẻ cũ & Ngoại lệ |
|---|---|---|---|---|
| Đã công bố hỗ trợ; dự kiến vào năm 2027 (ngày chính xác chưa ấn định) | Được diễn giải là Google-Extended: Disallow khi không có quy tắc Google-Extended rõ ràng |
Ánh xạ mặc định ảnh hưởng đến việc neo giữ Ứng dụng Gemini; các quy tắc rõ ràng được ưu tiên | Các chỉ thị Google-Extended hiện có vẫn hoàn toàn có hiệu lực; việc lập chỉ mục tìm kiếm không bị ảnh hưởng |
|
| Microsoft | Cam kết đã xác nhận; bắt đầu tôn trọng từ ngày 1 tháng 2 năm 2027 | Được công nhận là tùy chọn từ chối đào tạo trong quá trình thu thập thông tin web | Tách biệt khỏi việc đào tạo; được quản lý riêng thông qua các thẻ cấp trang | Ngừng sử dụng NoArchive/NoCache cho AI vào ngày 1 tháng 3 năm 2027; cài đặt Bing Webmaster Tools tạm thời mở vào ngày 15 tháng 12 |
| OpenAI | Cam kết thực hiện trong những tháng tới | Hỗ trợ trực tiếp trong các đường dẫn tiếp nhận dữ liệu | Được đánh giá cùng với các chỉ thị GPTBot |
Cấu hình GPTBot hiện tại vẫn hoạt động và có hiệu lực |
| Anthropic | Bản thảo do nhân viên soạn thảo; quá trình phát triển được báo cáo trên danh sách nhóm làm việc | Dự kiến hỗ trợ trên các dịch vụ; lịch trình phòng tin tức chính thức chưa ấn định | Được đánh giá cùng với các chỉ thị ClaudeBot |
Các điều khiển trình thu thập thông tin ClaudeBot hiện tại tiếp tục hoạt động |
Google có kế hoạch diễn giải việc từ chối đào tạo AI chung thành lệnh cấm Google-Extended khi không có quy tắc Google-Extended rõ ràng. Do Google-Extended cũng chi phối tính đủ điều kiện để neo giữ trong Ứng dụng Gemini, ánh xạ mặc định này có thể ảnh hưởng đến việc nội dung của nhà xuất bản có sẵn cho các trải nghiệm đó hay không. Quy tắc Google-Extended rõ ràng sẽ được ưu tiên hơn tín hiệu chung trong quá trình triển khai của Google, nhưng các nhà xuất bản không nên cho rằng các biện pháp kiểm soát hiện tại của Google cung cấp các tùy chọn từ chối độc lập cho việc đào tạo mô hình và neo giữ Ứng dụng Gemini. Nội dung được phép theo Google-Extended có thể đủ điều kiện để neo giữ Gemini, mà không có bất kỳ đảm bảo nào về việc đưa vào hoặc trích dẫn.
Ngược lại, Microsoft Bing coi việc đào tạo mô hình và neo giữ thời gian thực là các khái niệm kiến trúc riêng biệt, chi tiết như trong cập nhật chính thức của Bing Webmaster. Microsoft cho phép các nhà xuất bản từ chối đào tạo mô hình tạo sinh trong khi vẫn tiếp tục cho phép neo giữ trực tiếp trong các câu trả lời của Copilot. Các trang web quản lý các tùy chọn này có thể khai báo các hạn chế đào tạo trong robots.txt hoặc thông qua các thẻ meta HTML cấp trang và tiêu đề HTTP, ghi đè lên robots.txt cho các URL riêng lẻ. Việc neo giữ được kiểm soát thông qua các tùy chọn cấp trang, bao gồm tùy chọn DisallowExtended cho phép neo giữ trong các công cụ của riêng Microsoft (như Copilot) đồng thời loại trừ các dịch vụ của bên thứ ba được hỗ trợ bởi các API neo giữ của Microsoft. Hơn nữa, Microsoft đang loại bỏ dần sự phụ thuộc lịch sử vào các thẻ NoArchive và NoCache để kiểm soát AI; các trang web phụ thuộc vào các thẻ đó phải chuyển sang các tùy chọn mới trước ngày 1 tháng 3 năm 2027. Cài đặt neo giữ tạm thời của Bing Webmaster Tools chỉ khả dụng cho các trang web sử dụng NoArchive hoặc NoCache kể từ ngày 15 tháng 12 năm 2026. Nó vẫn có hiệu lực cho đến khi Microsoft thu thập lại thông tin trang và phát hiện ra tùy chọn mới, hoặc cho đến ngày 30 tháng 9 năm 2027, tùy theo điều kiện nào đến trước.
Danh sách kiểm tra kỹ thuật: Kiểm toán tùy chọn web cho Web Tác nhân
Việc triển khai tín hiệu tùy chọn đào tạo AI chung đòi hỏi sự phối hợp giữa kiến trúc hệ thống, vận hành nội dung và các nhóm quản trị pháp lý. Các nhà lãnh đạo kỹ thuật phải đảm bảo rằng cấu hình máy chủ phản ánh chính xác các chính sách của tổ chức mà không vô tình làm gián đoạn việc phát hiện của công cụ tìm kiếm.
Danh sách kiểm tra triển khai cho quản trị viên web và hệ thống
- Kiểm toán các tệp Robots hiện tại: Xem xét các tệp
robots.txthiện có để lập danh mục các chỉ thị dành riêng cho nhà cung cấp, xác minh xem các quy tắc choGPTBot,ClaudeBothoặcGoogle-Extendedcó xung đột với các chính sách đào tạo của tổ chức hay không. - Triển khai Token chính sách được dành riêng: Triển khai khối
User-Agent: __usage_ai-trainingđể thể hiện ranh giới đào tạo toàn cầu trên các nhà cung cấp AI tham gia theo định dạng hợp nhất. - Duy trì các đường dẫn ngoại lệ chi tiết: Nếu các tài sản công khai—chẳng hạn như thông cáo báo chí, bộ công cụ truyền thông hoặc tài liệu dành cho nhà phát triển mở—được dùng cho mục đích tiêu thụ của mô hình, hãy khai báo các ngoại lệ
Allow:rõ ràng bên dưới chỉ thị từ chối. - Tách biệt việc chặn nạp dữ liệu khỏi quản trị đào tạo: Nếu mục tiêu chính là giảm tải cho máy chủ nguồn hoặc ngăn chặn việc thu thập dữ liệu trái phép, hãy định cấu hình giới hạn tốc độ dựa trên IP, thử thách bot CDN và các khối tác nhân người dùng trình thu thập thông tin rõ ràng.
Danh sách kiểm tra quản trị và tuân thủ
- Xem xét lịch trình di chuyển neo giữ của Microsoft: Đối với các trang web sử dụng
NoArchivehoặcNoCacheđể kiểm soát đầu ra của Bing Copilot, hãy chuẩn bị chuyển sang các thẻ cấp trang mới trước thời hạn thực thi ngày 1 tháng 3 năm 2027 của Microsoft. - Đánh giá sự đánh đổi về khả năng khám phá tìm kiếm: Đối với các nền tảng đánh giá khả năng hiển thị trong các công cụ trả lời dạng trò chuyện, hãy nhận ra cách các ánh xạ mặc định dành riêng cho nhà cung cấp (chẳng hạn như phương án dự phòng của Google thành
Google-Extended) ảnh hưởng đến tính đủ điều kiện truy xuất thời gian thực. - Theo dõi cập nhật của Nhóm làm việc IETF: Theo dõi tiến trình của
draft-kelley-aipref-training-preference-signaltrong nhóm làm việc IETF AIPREF để tính toán các cập nhật cú pháp tiềm năng trước thời hạn hết hạn dự kiến vào tháng 5 năm 2027.
Share this article