GitHub 发布 Copilot Fusion?GitHub 于 2026 年 10 月 28 日正式宣布 Copilot Fusion 全面可用,并引入了可在软件工程任务中协调多个人工智能模型的运行时模型路由器和编排器。该系统在旧金山举行的年度 GitHub Universe 大会上亮相,将模型选择权从单个开发者手中剥离,允许平台分析任务需求并在不同的基础模型之间动态委派工作。随着软件工程团队面临不断攀升的 API 成本以及在不同前沿模型之间频繁切换带来的认知疲劳,自动化模型 orchestration(编排)正在成为标准的运营架构模式。
核心行业重组:GitHub 在 Universe 大会上发布 Copilot Fusion
概览
- GitHub 于 2026 年 10 月 28 日在 Visual Studio Code、Copilot CLI、JetBrains IDE 以及 GitHub Copilot 桌面应用程序中全面推出 Copilot Fusion。
- 该系统将源自 Project HydraFusion 的运行时多模型协调与微调的自动模型选择算法相结合。
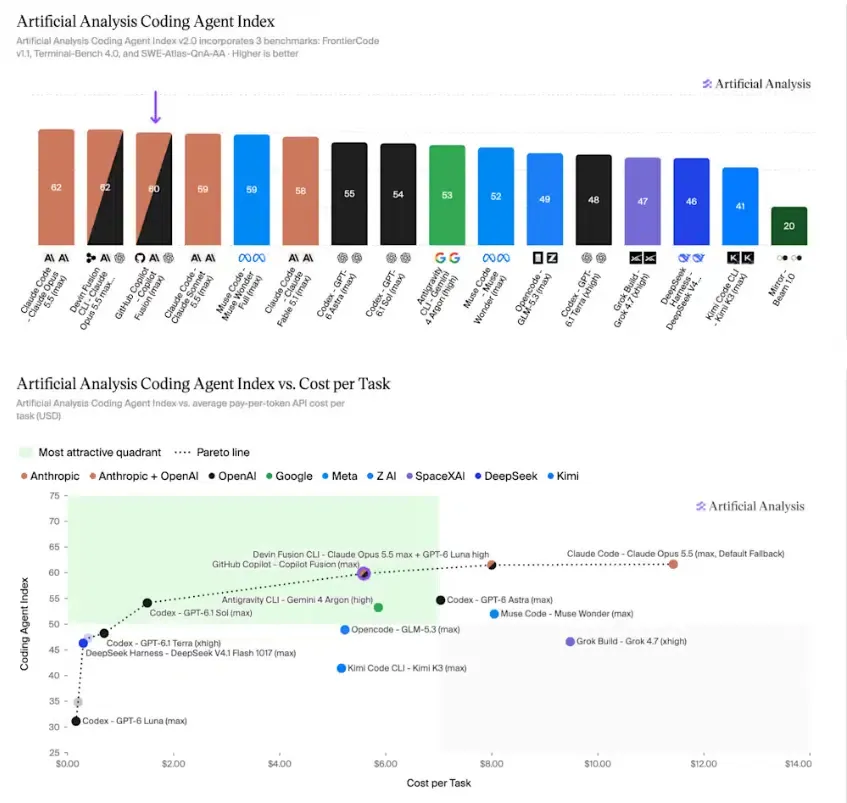
- 在 Artificial Analysis 进行的独立评估中,Fusion Max 在 Coding Agent Index v2.0 上取得了 60 分的综合得分,比搭载 Opus 5.5 Max 的 Claude Code 仅落后两分,同时将任务成本降低了约 51%。
使用 AI 编码助手的软件开发团队过去一直在手动选择的范式下运作。程序员从 IDE 下拉菜单中选择单个模型(例如 GPT-4o、Claude Sonnet 或 o1 系列推理模型),并在整个编码会话中维持该选择。虽然这种模式对于独立的提示词很有效,但它带来了运营权衡。开发人员经常为复杂的架构规划选择高成本、高延迟的前沿模型,但在执行生成单元测试或编写样板文档等日常任务时,往往又忘记切回轻量级模型。
这种手动方法会推高企业的 API 支出,并低效地消耗上下文 Token。为了解决这些工作流权衡问题,GitHub 开发了 Copilot Fusion,正如官方的 GitHub 公告中所述。Fusion 没有将 AI 编码视为与单个静态模型的交互,而是作为一个运行时协调器运作。开发人员指定一个总体推理工作量级别,系统则会为任务的每个步骤自主选择最合适的基础模型或模型组合。

GitHub Launches Copilot Fusion 发布所代表的战略转变侧重于任务级经济效益,而不是单纯的参数规模扩展。根据 Artificial Analysis 发布的基准评估,通过 Copilot CLI 在 Coding Agent Index v2.0 上测试的 Copilot Fusion Max 完成基准编码任务的平均成本为每个任务 5.59 美元,而运行 Anthropic 公司的 Claude Opus 5.5(最高设置)的 Claude Code 则为 11.42 美元。所评估的配置每个任务消耗约 720 万个 Token——约为独立 Opus 配置 Token 体积的一半——同时完成任务的时间缩短了约 40%。
各项基准组件的性能表现各有不同:Fusion Max 在 Terminal-Bench 4.0 上以 71 分领先,但在 FrontierCode 上得分为 51 分(落后于 Claude Code 的 56 分),在 SWE-Atlas-QnA-AA 上得分为 57 分。此外,虽然微软领导层引用内部 DeepSWE 评估显示潜在成本降低高达 77%,但该数字代表的是一个独立的、公司报告的最高场景,而非独立基准平均值。这些结果证实,动态多模型编排可以显著降低受支持工作流的开发开销,尽管实际节省取决于特定的任务组合、审查要求和企业使用模式。
架构模式:单模型、级联和批评执行拓扑
Copilot Fusion 并不是作为一个独立的基础模型运作的,而是作为嵌入在开发者客户端中的智能控制平面发挥作用。当用户提交涉及推理、代码生成、调试或工具使用的指令时,Fusion 会针对实时系统健康状况、可用性和语义复杂性评估传入的意图信号。
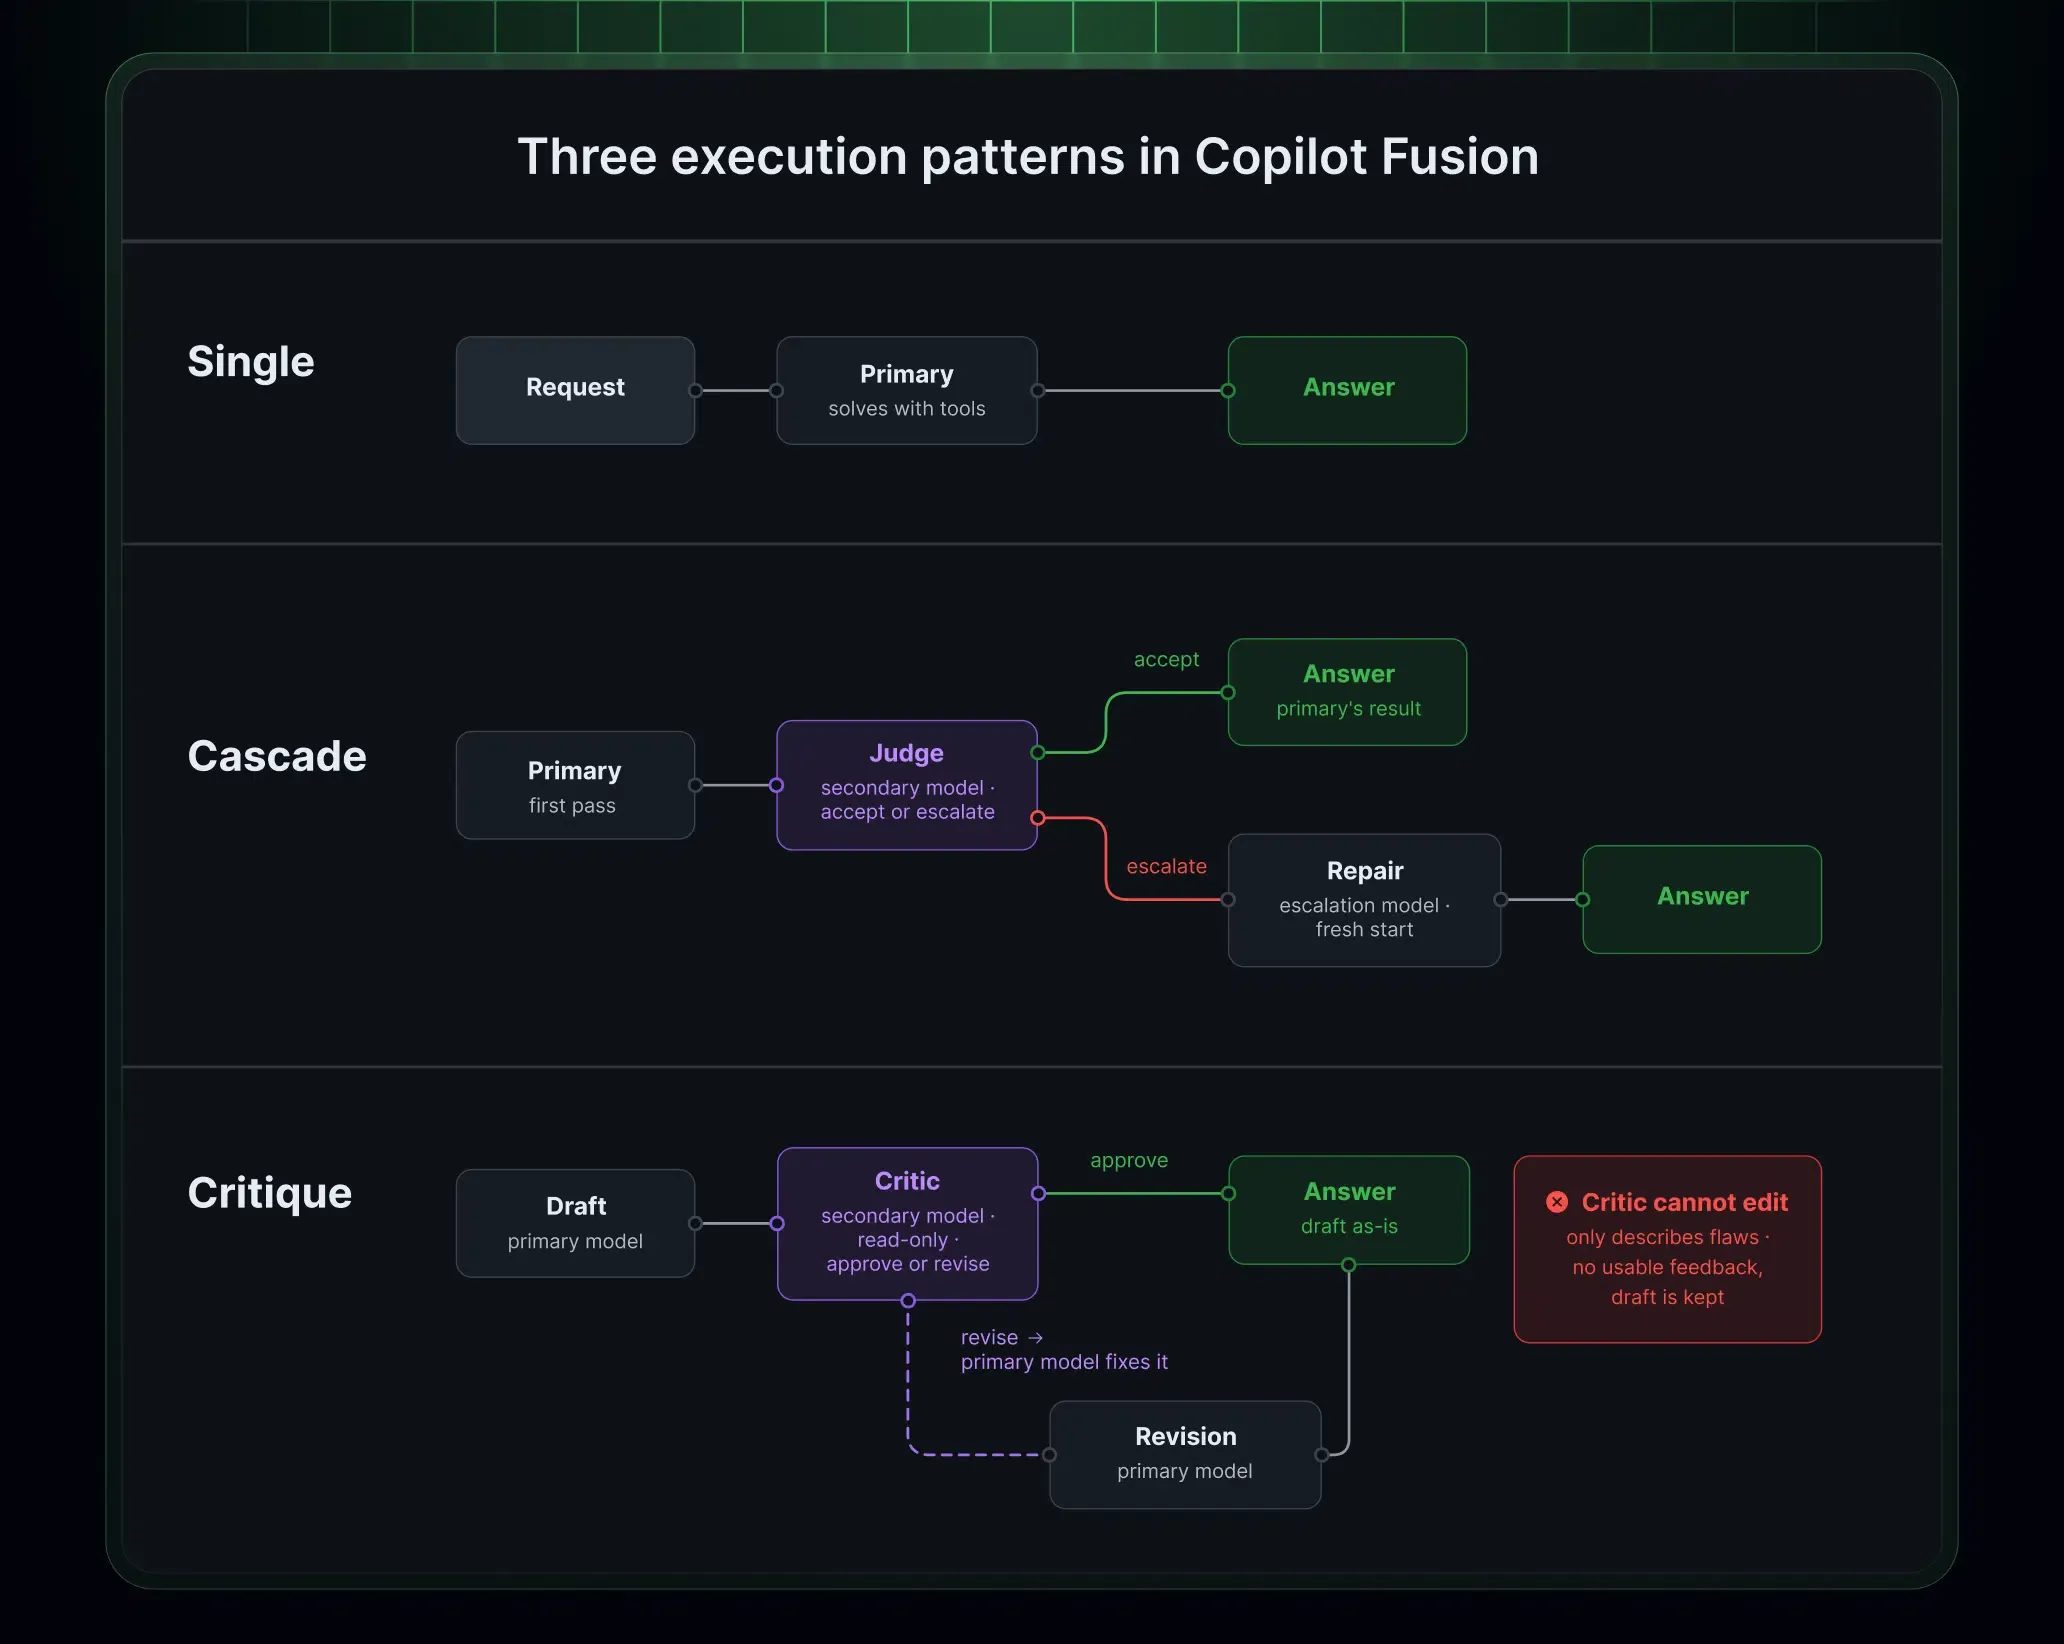
根据任务特征和所选的工作量层级,系统会动态选择以下三种执行模式之一:
- 单模型模式(Single Pattern):单个模型接收提示词并直接完成任务,零审阅开销。该模式适用于直接的代码生成、语法查询和基础重构。
- 级联模式(Cascade Pattern):轻量级模型草拟初步解决方案。辅助裁判模型检查拟议的代码,并决定是接受输出还是将任务升级到功能更强的模型以进行精炼。
- 批评模式(Critique Pattern):主模型草拟初始响应,同时一个或多个评审模型并行独立评估代码。编排器聚合他们的反馈,主模型相应地修改代码,然后将最终输出返回给用户。
[Single Pattern]
  Prompt ──> Primary Model ──> Single Execution ──> Final Code Output

[Cascade Pattern]
  Prompt ──> Lightweight Model ──> Initial Draft ──> Judge Model ──[Accept]──> Final Code Output
                                                         └──[Escalate]──> Stronger Model ──> Final Output

[Critique Pattern]
  Prompt ──> Drafting Model ──> Initial Draft ──┬─> Reviewer Model A ──┐
                                                └─> Reviewer Model B ──┴─> Feedback Aggregator ──> Final Revision
这些执行拓扑在执行速度、验证严谨性和计算成本之间引入了明显的权衡。GitHub 没有将提示词硬编码到特定模式中,而是将这些工作流映射到可选的工作量级别:
- Fusion Standard:在日常编码中平衡成本、质量和延迟。当前实现通常每个任务选择一个模型。
- Fusion High:在兼顾 Token 效率的同时,优先考虑针对重大编码任务的更强能力和更深推理。在必要时可以使用多模型编排。
- Fusion Max:为最苛刻的任务优先提供前沿级能力,并在有用的地方动态选择额外的审查或升级步骤。
- Fusion Fast:一种专用的、非用户可选的工作量级别,用于支持延迟敏感的 Visual Studio Code 内联聊天场景。
跨动态工作流管理上下文边界需要专门的内存处理。Copilot Fusion 本身不具备统一的上下文窗口。相反,每个执行步骤都严格在执行该子任务的具体模型的上下文限制内运行。IDE 中显示的上下文容量反映了参与模型中最保守的限制。此外,为了最大限度地提高提示词缓存效率,Fusion 尽可能将核心对话线程保留在单个主模型上,仅向协助的评审模型传递必要的、隔离的上下文窗口。
跨开发者团队的企业治理与本地模型集成
在大型企业工程组织中部署自主模型编排会带来治理、合规性和预算方面的考量。当 AI 系统在 Anthropic、OpenAI 和其他提供商的模型之间动态选择时,管理员必须确保组织的数据驻留和安全规则保持完整。
企业管理员可以通过受支持的 GitHub Copilot 模型策略和企业管理设置来管理符合 Copilot Fusion 条件的模型,正如 Copilot Fusion 管理手册中所记录的那样。管理员可以查看 Fusion 可用的模型名册,跨开发者席位设置默认工作量级别,并在不全公司禁用特定模型的情况下为 Fusion 禁用它们。Fusion 尊重适用的订阅、组织、数据驻留、FedRAMP 相关和评估模型限制。这些控制措施管理系统内的模型资格,但它们不能取代组织自身的合规审查、数据治理或安全验证流程。
下表概述了不同的执行架构如何平衡执行表面、审查机制和 Token 支出配置文件:
| 执行模式 | 主要调用 | 审查机制 | Token 成本配置文件 | 最适合 |
|---|---|---|---|---|
| 单模型模式 (Single Mode) | 一个专用的模型 | 无 | 基准标准模型定价 | 直接的代码编辑和语法问题 |
| 级联模式 (Cascade Mode) | 高效的草稿模型 | 裁判模型检查与升级 | 低到中等(条件升级) | 范围明确的错误修复和结构化修改 |
| 批评模式 (Critique Mode) | 主生成器 | 并行独立的评审模型 | 较高(多个同时模型调用) | 复杂的架构逻辑和安全敏感的代码 |
| 本地模型混合模式 (Local Model Hybrid) | 受支持的本地设备端模型 | 云端协调的模型选择 | 减少本地步骤上的云端 Token 消耗 | 具有云端协调路由的合规设备端推理 |
正如 GitHub 关于本地模型选择的更新日志中所宣布的,GitHub 引入了感知本地模型的路由作为选择性加入的实验性预览。配置了受支持的本地模型后,Copilot Fusion Standard 可能会为符合条件的任务选择设备端推理,从而减少这些步骤的云模型使用。在配备兼容硬件的 Windows 系统上,开发人员可以通过 Copilot 应用、Copilot CLI 或 Visual Studio Code 中的 Windows ML 管理来安装和运行 MAI Code 1.1 Flash。Windows、macOS 和 Linux 上的跨平台用户可以使用 Ollama 等本地模型提供商在 Copilot CLI 中配置诸如 Qwen3.8 Flash Next 之类的本地模型,并使用 --experimental 标志启动 CLI。
然而,Copilot Fusion 仍然依赖于基于云端的路由决策,并且在适当时任务可能会使用云端模型。因此,本地模型支持并不能使 Copilot Fusion 成为完全离线的编码环境;需要物理隔离(Air-gapped)安全性的开发人员应转而评估专门的离线工具。
工程检查清单:在生产环境中采用多模型编排
将多模型运行时编排集成到软件开发工作流中需要调整开发人员习惯、IDE 配置和企业财务运营。工程领导层必须建立清晰的运营协议,以利用 Token 效率,同时避免工作流陷阱。
开发者实施检查清单
- 提交前检查工作区 Diff:丢弃 AI 草稿不会自动还原工作区文件修改;开发人员必须在提交代码之前查看所有未提交的文件编辑。
- 将工作量级别与任务复杂性相匹配:为复杂的算法逻辑和安全审计保留 Fusion Max,将 Fusion Standard 用于日常编码,以防止不必要的 AI 额度消耗。
- 审计多模型进度流:观察 IDE 进度指示器以检查哪些具体模型对生成的代码块做出了贡献,从而确保整个执行步骤的透明度。
- 配置受支持的本地模型:对于 Fusion Standard 上的符合条件的任务,在 Windows 上设置受支持的本地模型(例如 MAI Code 1.1 Flash)或通过 Ollama 设置 Qwen3.8 Flash Next,并在需要时启用实验性设置。
企业治理与 FinOps 检查清单
- 配置企业模型策略:在企业仪表盘中指定哪些模型符合 Fusion 路由条件,将模型名册与企业合规和数据驻留要求保持一致。
- 审计基于使用情况的 AI 额度:跨工作量层级跟踪团队级额度消耗,同时考虑到 Fusion High 和 Max 中的多模型执行每个任务消耗的额度可能比单模型执行更多。
- 计入促销计费窗口期:在对运营费用进行基准测试时,将 GitHub 在 2026 年 11 月 30 日之前为付费 Copilot 订阅者提供的 30% 模型成本促销折扣考虑在内。
- 建立人工代码评审门槛:为所有代理生成的拉取请求维护强制性的同行代码评审,确保自动批评循环是对人工工程监督的补充,而不是替代。
常见问题解答 (FAQ)
当 Copilot Fusion 调用多个模型时,GitHub 是如何计算账单的?
如果 Copilot Fusion 丢弃了中间代码草稿,会发生什么?
企业管理员可以限制 Copilot Fusion 选择哪些模型吗?
工程团队的核心要点
GitHub Copilot Fusion 的发布证实,在复杂的软件工程任务中依赖单个、单一的人工智能模型会引入不必要的运营权衡。现代开发工作流包含不同的认知需求,从即时语法补全到复杂的跨仓库推理。强迫单一模型架构处理这整个范围可能会导致模型支出不断升级或执行质量受损。
独立的基准测试结果表明,多模型编排可以在降低某些工作负载的模型成本的同时提供有竞争力的编码性能。实际结果将取决于任务复杂性、编排行为、所选模型以及组织的使用模式。通过将任务委派与开发人员的手动选择解耦,运行时模型编排建立了一条务实的运营路径。随着软件工程组织扩展自动化编码代理,主要的竞争差异化因素将不再是对任何单个基础模型的访问权限,而是连接它们的编排层的治理、可靠性和架构严谨性。
参考资料
-
GitHub:使用 GitHub Copilot Fusion 路由和编排模型 — GitHub Universe 2026 的官方发行说明和功能概述。
-
GitHub:Copilot Fusion 现已支持选择本地模型 — 详细介绍通过本地模型路由对符合条件的任务进行设备端推理的官方公告。
-
GitHub 文档:关于 GitHub Copilot Fusion 概念和配置 — 详细说明执行模式、工作量级别和计费规则的官方技术文档。
-
GitHub 文档:配置可用于 Copilot Fusion 的模型 — 用于管理企业模型策略和默认设置的管理指南。
-
Artificial Analysis:GitHub Copilot Fusion 基准评估 — 衡量任务成本、Token 效率和 Coding Agent Index 得分的独立分析。
-
The New Stack:GitHub 推出 Copilot Fusion 多模型系统 — 关于 Project HydraFusion 集成和企业客户实现的深度技术报道。
-
VentureBeat:GitHub Copilot Fusion 混合模型以实现成本效益 — 涵盖运行时路由架构的 GitHub 产品领导层技术访谈。
Share this article