OpenAI 与 Google 支持统一的 AI 训练退出机制?OpenAI、Google 和微软于 2026 年 10 月 30 日宣布,计划在 robots.txt 中支持一个单一的共享策略 Token,允许网站运营者同时向多个服务商表达生成式 AI 模型训练偏好。该提议机制源自 Anthropic 工程师 Kevin Kelley 提交给 IETF AI Preferences 工作组的一份独立互联网草案(Internet-Draft)。尽管该倡议为发布者提供了一种使用标准 Allow 和 Disallow 语法声明训练退出机制的简化方法,但其实施时间表将延续至 2027 年,且各大平台计划在模型训练和实时对话检索增强(Grounding)中对该信号进行不同的解释与应用。
核心行业调整:各大 AI 实验室协同推进 robots.txt 标准
核心要点
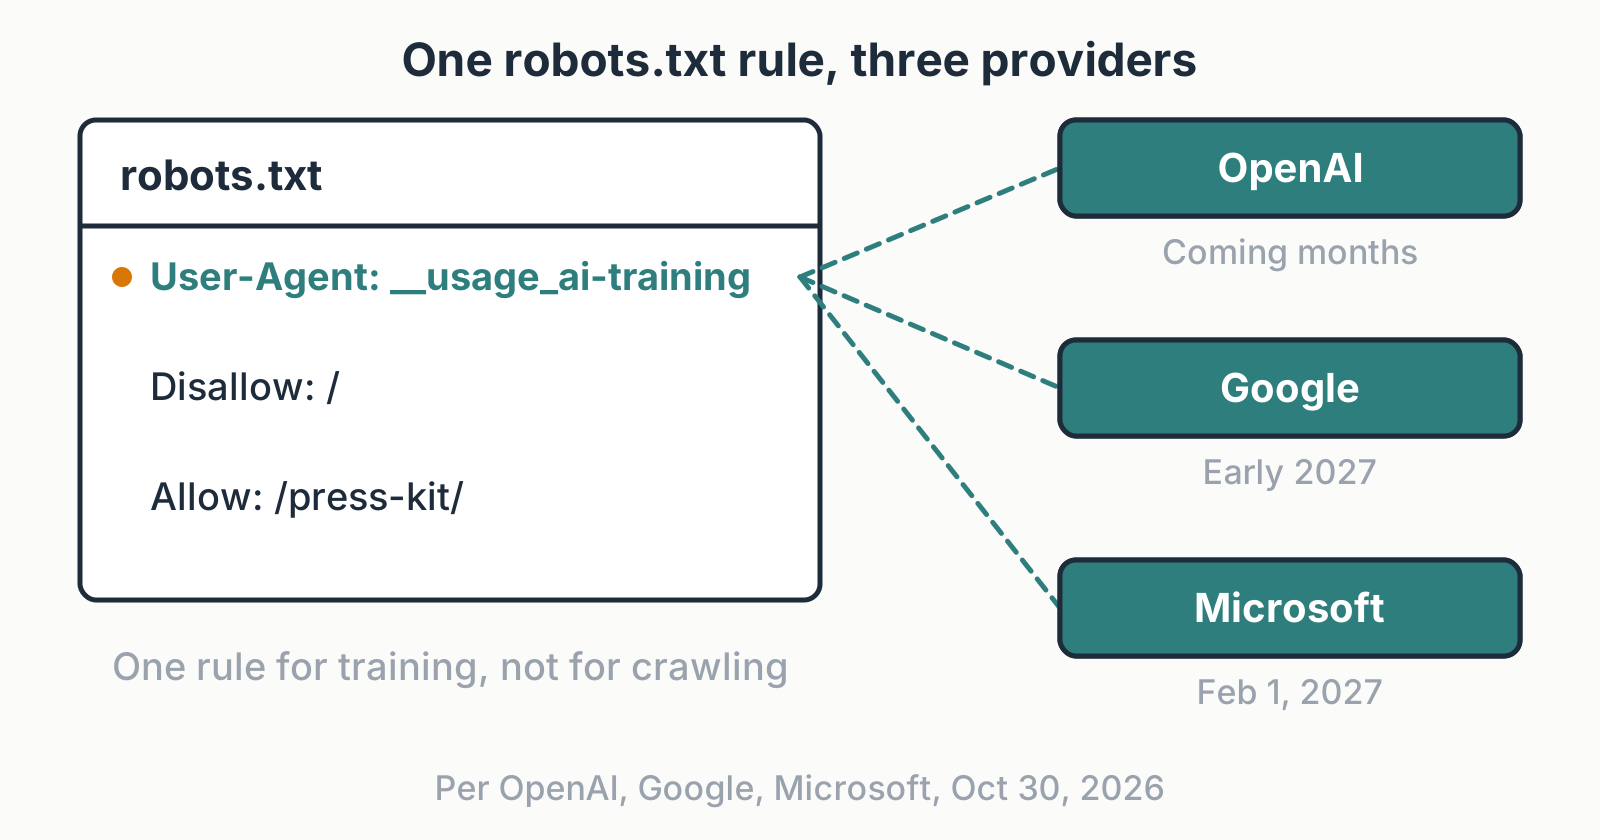
- OpenAI、Google 和微软于 2026 年 10 月 30 日宣布协同计划,认可一个用于管理生成式模型训练偏好的共享 robots.txt 策略 Token:
__usage_ai-training。 - 该信号由 Anthropic 工程师 Kevin Kelley 撰写的独立 IETF 互联网草案定义,确立了标准化的语法,但并不代表官方或最终的 IETF RFC 标准。
- 各平台的采用时间表存在显著差异:Anthropic 已启动内部工程工作,OpenAI 计划在未来几个月内推出,微软于 2027 年 2 月 1 日开始支持,Google 则预计在 2027 年支持。
近三十年来,机器人排除协议(Robots Exclusion Protocol)一直规范着自动化网络爬虫与公共在线内容的交互方式。网站管理员在根目录下放置一个简单的 robots.txt 纯文本文件,定义哪些搜索引擎用户代理(User-Agent)有权抓取特定的 URL 路径。该协议基于一项基本的商业契约:网站发布者允许爬虫索引其内容,以此换取搜索引擎结果页面上的曝光度、外部引荐流量和品牌知名度。
生成式人工智能的迅猛发展打破了这一经济模型。前沿 AI 实验室部署的自动抓取工具开始摄取网页域名来训练基础模型,并往往直接在问答界面中总结原始内容,而没有为发布者带来引荐点击。希望防止其知识产权被摄取的网站所有者被迫维护碎片化、复杂的专有用户代理列表,包括 GPTBot、ClaudeBot 和 Google-Extended。这种管理开销增加了在同时管理多个爬虫指令时出现配置错误或意外取消搜索引擎索引的操作风险。

共享 AI 训练退出机制的出现标志着从碎片化的供应商屏蔽向协同协议治理的重大转变。通过围绕共享策略 Token 协调支持,各大 AI 服务商旨在降低内容创作者为建立生成式模型训练的清晰边界所需的门槛。根据 Google 搜索中心官方公告,这一条规则允许网站管理员一步到位地声明其生成式 AI 训练立场,而不必跟踪和配置进入市场的每一个独立商业 AI 爬虫的独特指令。
底层架构机制:__usage_ai-training Token 的工作原理
共享偏好信号背后的技术架构在 IETF 关于机器可读训练偏好信号的互联网草案中进行了规范。至关重要的是,该草案并未引入新的指令,也没有改变 RFC 9309 中定义的机器人排除协议的底层语法。相反,它通过分配一个保留的策略 Token(__usage_ai-training)来重复使用标准的 User-Agent 记录。
要配置退出,网络管理员需要创建一个普通的规则块,将此策略 Token 指定为用户代理,后面跟上标准的 Disallow 和 Allow 规则。以下示例说明了网站所有者如何在所有网站目录中表达退出,同时为公共宣传资料保留例外情况:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
构成“AI 训练”的语义定义锚定在 IETF 工作组的基础词汇规范中。在此框架下,训练被严格定义为利用抓取的网页内容来修改或微调生成式人工智能模型的学习权重和参数。非生成式计算操作(如标准文档分类、搜索索引排名、拼写纠错和垃圾邮件过滤)明确排除在该定义之外。
协议边界:抓取与训练与检索增强(Grounding)
理解该提议 Token 的运营限制需要将自动化数据摄取的主体阶段进行区分:
[公共网页内容]
       │
       ▼
[1. HTTP 抓取 / 获取] ──> 受特定爬虫用户代理治理(例如 GPTBot、Bingbot)
       │                    *__usage_ai-training 不治理 HTTP 获取行为*
       ├────────────────────────────────────────┐
       ▼                                        ▼
[2. 模型训练用途]                  [3. 实时 Grounding / RAG]
   *__usage_ai-training: Disallow*          *由页面标签和供应商设置治理*
   发出反对训练偏好的信号                  为 AI 模型提供实时网络上下文
       │                                        │
       ▼                                        ▼
   执行取决于参与的                         资格标准由各个平台
   AI 服务商                                政策设定
技术团队必须评估该草案规范中固有的四个结构边界:
- 该信号治理训练,而非抓取:该策略 Token 不是针对网络抓取行为的指令。在
__usage_ai-training下遇到Disallow: /的 AI 爬虫仍然被允许通过 HTTP 获取 HTML 文档。它只是被指示不要将检索到的文本输入到模型训练管道中。为了完全阻止机器人请求该 URL,管理员必须继续阻止爬虫的具体身份名称。 - 通配符规则不适用:通用的通配符块(例如
User-Agent: *后跟Disallow: /)不匹配该策略 Token。该草案规定,参与的 AI 服务商不得将通用的通配符组解释为对 AI 训练偏好的表达。如果文件省略了显式的__usage_ai-trainingToken,则标准将该网站解释为未表达训练偏好。 - 无溯及既往的模型遗忘:更新网站的
robots.txt文件是向前生效的。它为未来的抓取和训练周期提供了一个信号,但并不强制 AI 实验室清除已集成到历史训练数据集中的数据,也不强制删除预先存在的基础模型中的权重。 - 自愿协同优于技术执行:该信号表达的是发布者的偏好;它不针对未参与或不合规的数据消费者提供技术执行力。根据 RFC 9309 原则,robots.txt 仍然是一种合作性的咨询机制,而不是访问控制防火墙。
服务商实现差异与迁移时间表
尽管 Google、微软和 OpenAI 已经宣布计划支持该共享信号,但它们的的技术实现和推出时间表存在显著差异。每个服务商都通过其自身的产研基础设施,平衡搜索引擎索引、生成式模型训练和对话式检索增强生成(RAG)之间的关系。
下表对比了已确认的平台承诺、解释规则和迁移时间表:
| 平台 | 已确认状态与时间表 | 策略 Token 解释 | Grounding 与检索处理 | 旧标签迁移与例外 |
|---|---|---|---|---|
| 已宣布支持;计划于 2027 年推出(确切日期待定) | 当不存在显式 Google-Extended 规则时,被解释为 Google-Extended: Disallow |
默认映射影响 Gemini Apps 的 Grounding;显式规则优先 | 现有的 Google-Extended 指令完全有效;搜索引擎索引不受影响 |
|
| Microsoft | 已确认承诺;将于 2027 年 2 月 1 日开始遵守 | 在网页抓取期间被识别为训练退出机制 | 与训练解耦;通过页面级标签单独管理 | 于 2027 年 3 月 1 日退役针对 AI 的 NoArchive/NoCache;临时的必应站长工具设置于 12 月 15 日开放 |
| OpenAI | 承诺在未来几个月内实施 | 在数据摄取管道中直接支持 | 与 GPTBot 指令一同评估 |
现有的 GPTBot 配置保持活跃且可执行 |
| Anthropic | 由员工撰写草案;工作组列表中报告了开发进展 | 计划跨服务支持;官方新闻室时间表待定 | 与 ClaudeBot 指令一同评估 |
现有的 ClaudeBot 爬虫控制继续运行 |
Google 计划在没有显式 Google-Extended 规则时,将共享的 AI 训练退出机制解释为 Google-Extended 禁用。由于 Google-Extended 还管辖 Gemini Apps 中 Grounding 的资格,这种默认映射可能会影响发布者的内容是否可用于这些体验。在 Google 的实现中,显式的 Google-Extended 规则优先于共享信号,但发布者不应假定 Google 当前的控制为模型训练和 Gemini Apps Grounding 提供独立的退出机制。根据 Google-Extended 允许的内容可能有资格用于 Gemini Grounding,但不保证收录或引用。
相比之下,微软必应将模型训练和实时 Grounding 视为不同的架构概念,正如官方必应站长更新中所述。微软允许发布者选择退出生成式模型训练,同时继续允许在 Copilot 回答中进行实时 Grounding。管理这些偏好的网站可以在 robots.txt 中或通过页面级 HTML 元标签和 HTTP 标头声明训练限制,这些标头会覆盖单个 URL 的 robots.txt。Grounding 通过页面级偏好进行控制,包括一个 DisallowExtended 选项,该选项允许在微软自己的工具(如 Copilot)中进行 Grounding,同时排除由微软 Grounding API 提供支持的第三方服务。此外,微软正在逐步淘汰历史对 NoArchive 和 NoCache 标签用于 AI 控制的依赖;依赖这些标签的网站必须在 2027 年 3 月 1 日之前迁移到新选项。临时的必应站长工具 Grounding 设置仅适用于截至 2026 年 12 月 15 日使用 NoArchive 或 NoCache 的网站。它一直有效,直到微软重新抓取该页面并发现新偏好,或直到 2027 年 9 月 30 日(以较早者为准)。
工程清单:为代理网络(Agentic Web)审计网页偏好
部署共享的 AI 训练偏好信号需要系统架构、内容运营和法律合规团队之间的协作。工程负责人必须确保服务器配置准确反映组织政策,而不会无意中破坏搜索引擎发现能力。
站长与系统实现清单
- 审计当前机器人清单:审查现有的
robots.txt文件以编目供应商特定的指令,验证针对GPTBot、ClaudeBot或Google-Extended的规则是否与组织的训练政策冲突。 - 部署保留的策略 Token:实现
User-Agent: __usage_ai-training块,以统一格式表达参与的 AI 服务商之间的全局训练边界。 - 维护细粒度的例外路径:如果公共资产(如新闻稿、媒体套件或开放开发人员文档)旨在供模型消费,请在 disallow 指令下方声明显式的
Allow:例外。 - 将获取阻止与训练治理分离:如果主要目标是减少源服务器负载或防止未授权抓取,请配置基于 IP 的速率限制、CDN 机器人挑战和显式的爬虫用户代理阻止。
治理与合规清单
- 审查微软 Grounding 迁移时间表:对于利用
NoArchive或NoCache来控制必应 Copilot 输出的网站,请准备在微软 2027 年 3 月 1 日的执行截止日期之前过渡到新的页面级标签。 - 评估搜索引擎可见性权衡:对于评估对话式问答引擎中可见性的平台,了解供应商特定的默认映射(例如 Google 回退到
Google-Extended)如何影响实时检索资格。 - 跟踪 IETF 工作组更新:监控 IETF AIPREF 工作组内
draft-kelley-aipref-training-preference-signal的进展,以便在 2027 年 5 月预定过期之前应对可能的语法更新。
Share this article