¿Claude Sonnet 5.5 es un 30% más rápido? Anthropic ha lanzado oficialmente Claude Sonnet 5.5, informando de una generación de salida más rápida en más de un 30% y una reducción de hasta el 30% en el coste por tarea completada. A medida que las plataformas de inteligencia artificial generativa pasan de prototipos experimentales a sistemas de producción de gran volumen, los equipos de ingeniería de software enfrentan una creciente presión por controlar el consumo de tokens y la latencia de ejecución. Históricamente, los arquitectos empresariales asumían que lograr un rendimiento de codificación de primer nivel requería desplegar los modelos más grandes y costosos. Hoy en día, dado que las arquitecturas de nivel intermedio optimizadas pueden resolver desafíos complejos de ingeniería de software con menos pasos operativos y llamadas a herramientas, la economía fundamental de las herramientas automatizadas para desarrolladores se desplaza hacia la eficiencia en la ejecución.
Economía de producción: por qué el coste de completar una tarea importa más que el precio por token
Resumen
- Anthropic lanzó Claude Sonnet 5.5 el 28 de septiembre de 2026, ofreciendo una generación de salida más rápida en más de un 30% y hasta un 30% menos de coste por tarea completada.
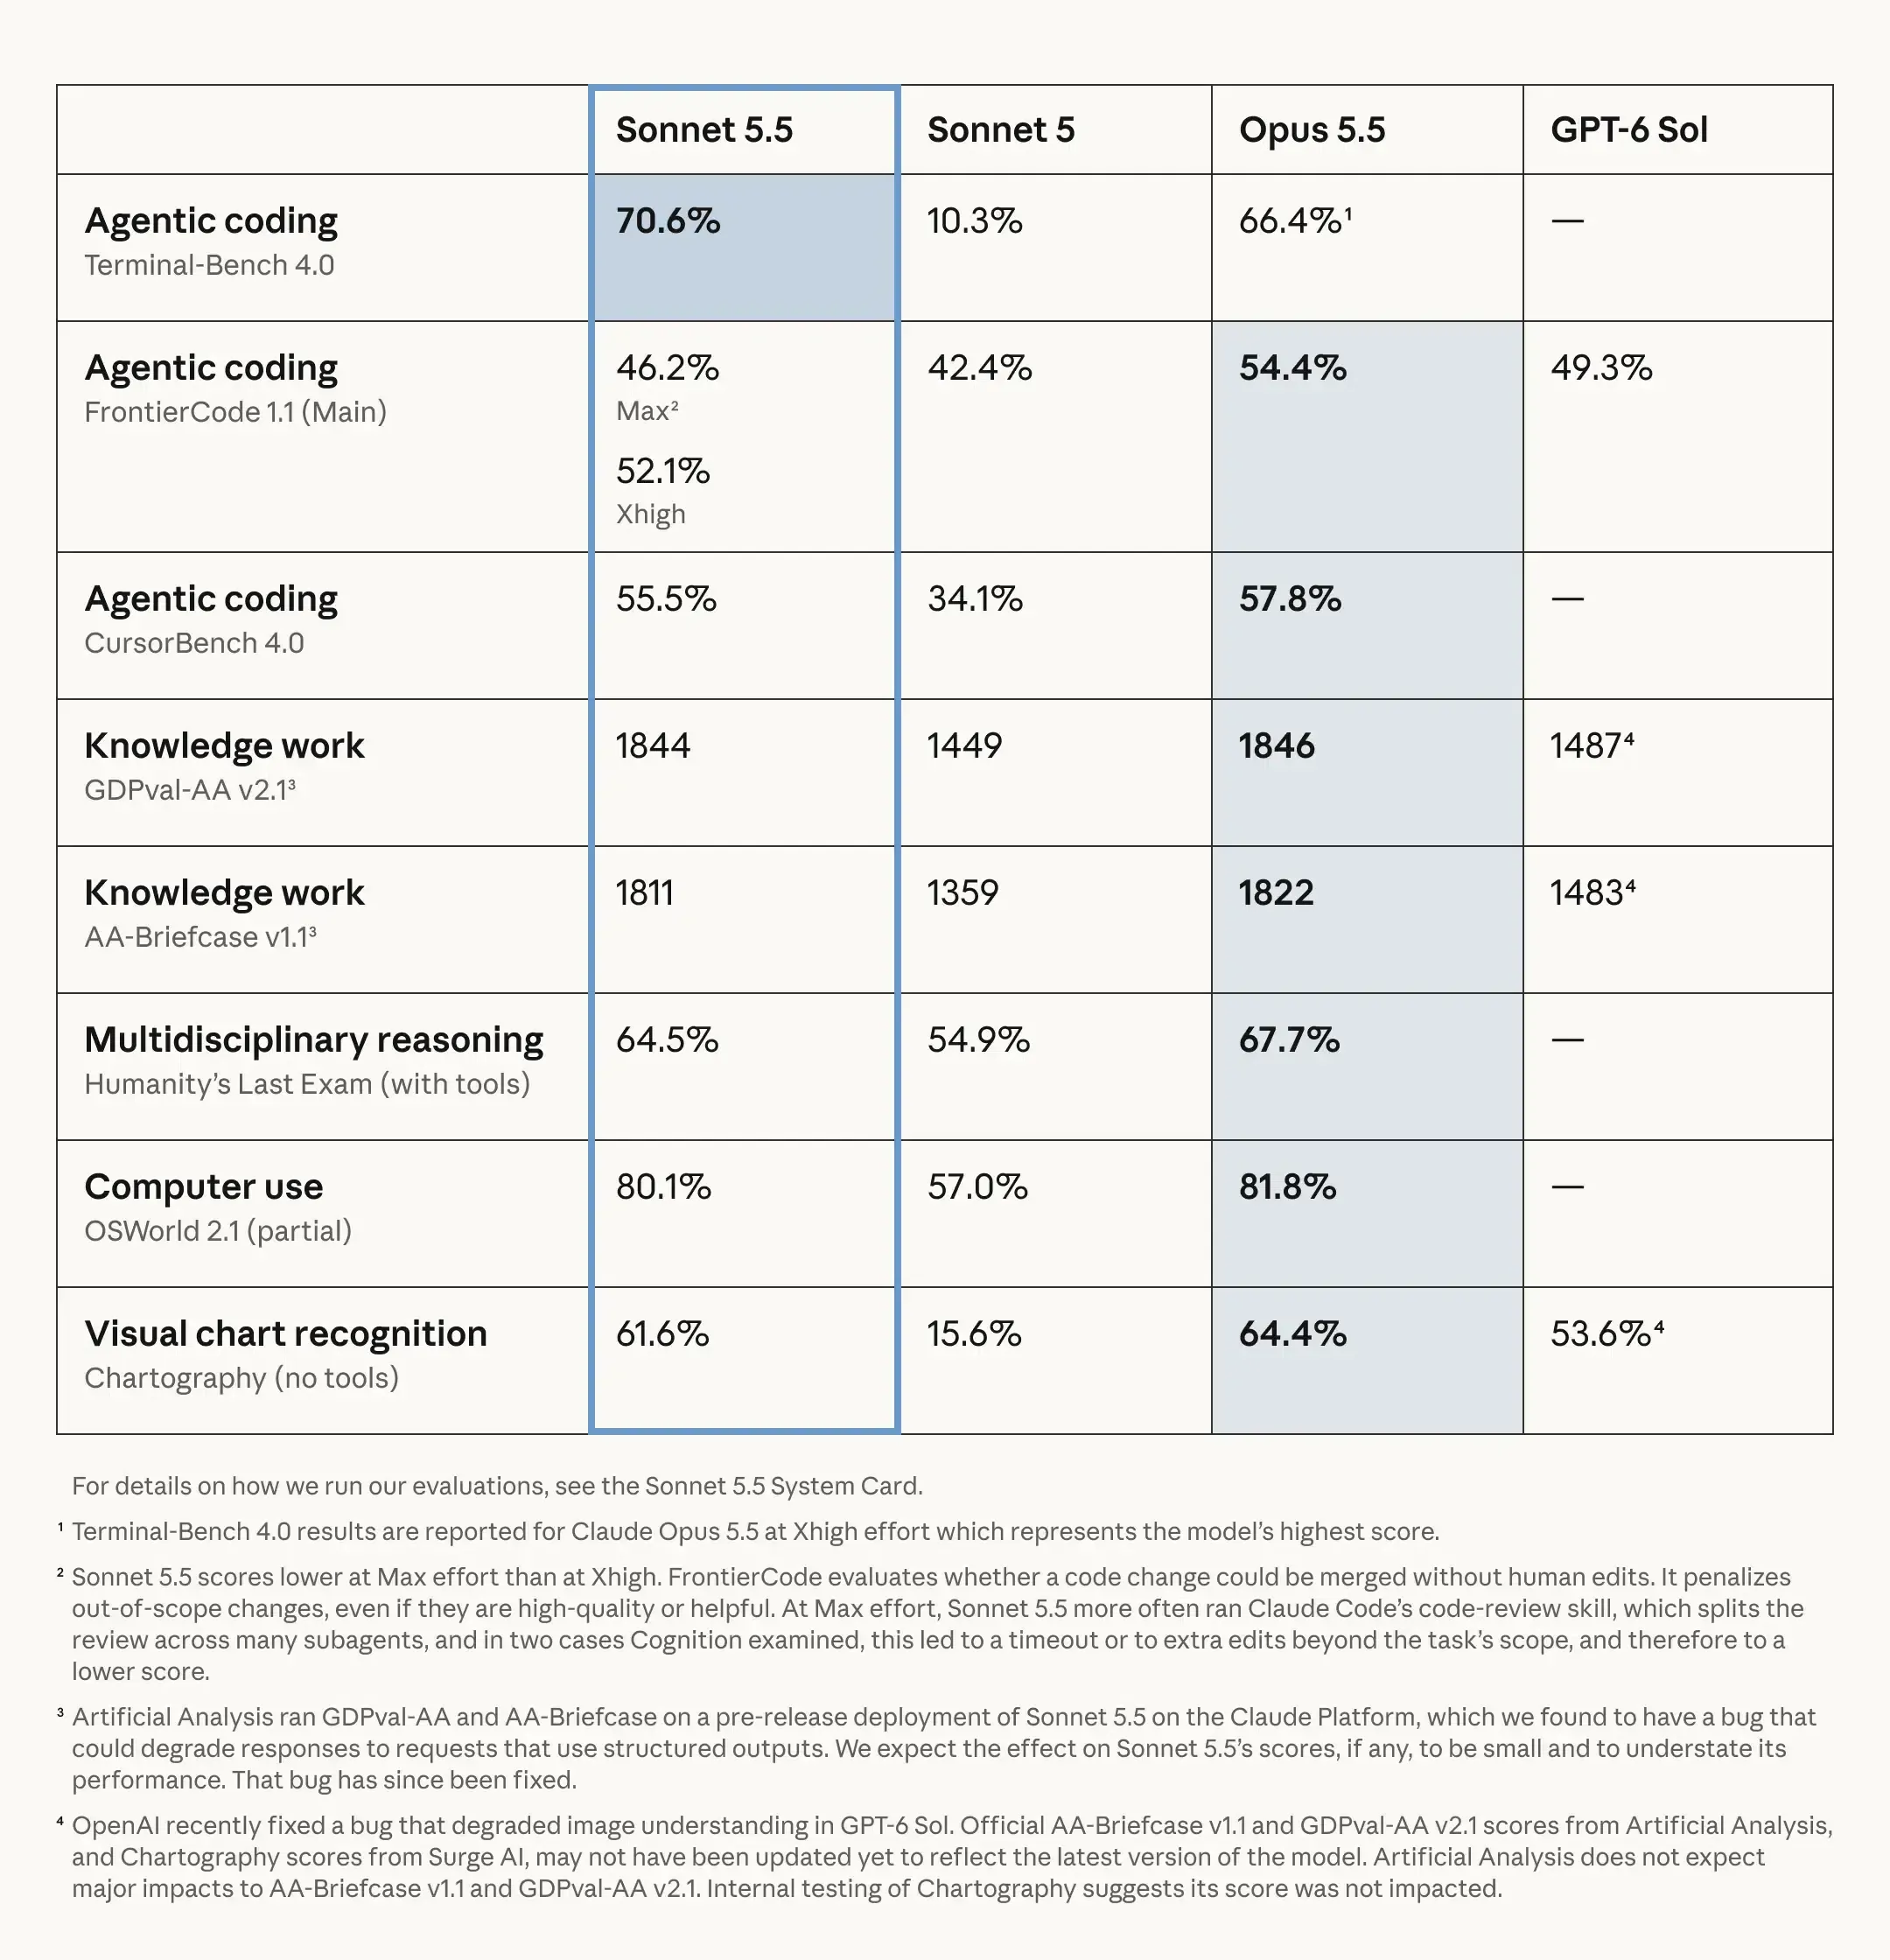
- En la evaluación de codificación con agentes Terminal-Bench 4.0, Sonnet 5.5 obtuvo una puntuación del 70,6%, superando al modelo insignia Claude Opus 5.5 (66,4%) y a Sonnet 5 (10,3%).
- El precio de los tokens de API se mantiene en $2 por millón de tokens de entrada y $10 por millón de tokens de salida, logrando reducciones de costes mediante menos pasos de ejecución y llamadas a herramientas por lotes.
La viabilidad comercial de desplegar agentes autónomos de ingeniería de software se ha enfrentado históricamente a importantes limitaciones económicas. Ejecutar herramientas para desarrolladores de varios pasos que inspeccionan bases de código, ejecutan comandos de shell y corrigen pruebas unitarias de forma iterativa consume volúmenes masivos de tokens. Aunque los modelos de vanguardia demuestran una notable profundidad de razonamiento, sus altos costes por token y latencias elevadas hacen que la ejecución continua y desatendida sea costosa para las empresas de software a escala.
Al evaluar la infraestructura de desarrollo, el precio de catálogo de la API a menudo oculta el coste real de completar un trabajo. Un modelo con un precio bajo por token que realiza decenas de llamadas a herramientas repetitivas y reintentos, al final cuesta significativamente más que un modelo que resuelve problemas en menos pasos de ejecución. Esta dinámica se explora en informes del sector sobre Sonnet 5.5, que destacan cómo los costes de finalización de tareas se están desvinculando de los precios nominales por token.
Anthropic ha estructurado Claude Sonnet 5.5 para abordar directamente estos cuellos de botella operativos. Si bien mantiene las tarifas base de API de $2 por millón de tokens de entrada y $10 por millón de tokens de salida, el modelo logra una reducción de hasta el 30% en los costes netos de las tareas al requerir sustancialmente menos pasos de razonamiento. Los informes de pruebas de clientes publicados por Anthropic destacan notables ganancias de eficiencia en cargas de trabajo de producción:
- Box informó que Sonnet 5.5 operó 2,4 veces más rápido mientras utilizaba un 12% menos de tokens totales para volver a verificar documentos fuente e identificar regresiones de código.
- Zendesk observó que los tickets de soporte se procesaron un 20% más rápido junto con menos errores de decisión automatizados que los modelos de producción existentes.
- Slack demostró que el modelo superó a Sonnet 5 en evaluaciones de bots fuera de línea sin modificaciones en los prompts, consumiendo aproximadamente un 14% menos de tokens de salida.
- Lovable descubrió que Sonnet 5.5 requería aproximadamente un tercio menos de llamadas a herramientas y la mitad de ejecuciones de shell durante las compilaciones automatizadas de aplicaciones.
- Base44 verificó que el modelo completaba compilaciones de aplicaciones completas en un promedio de 3,6 iteraciones, comparado con 7,7 iteraciones para Opus 5.
Estos resultados ilustran cómo la eficiencia en la ejecución altera fundamentalmente la productividad del desarrollador. Al reducir las llamadas a herramientas fallidas y eliminar iteraciones redundantes, los modelos de nivel intermedio proporcionan una base sostenible para la automatización empresarial continua.
Análisis técnico: evaluación de benchmarks de codificación y escalado de subagentes
El surgimiento de modelos intermedios que superan a los modelos insignia en benchmarks técnicos específicos refleja un cambio en el entrenamiento posterior de los modelos fundamentales. Las leyes de escala iniciales sugerían que el número bruto de parámetros era el determinante principal de la inteligencia del modelo. Sin embargo, las tareas complejas de los agentes, como navegar por entornos de terminal y editar repositorios extensos, dependen en gran medida de la gestión del contexto, la disciplina precisa en el uso de herramientas y el control del alcance.
Los modelos insignia como Opus 5.5 poseen una inmensa capacidad de razonamiento, destacando en decisiones arquitectónicas ambiguas y abiertas. Sin embargo, una profundidad de razonamiento extensa puede introducir ocasionalmente una carga operativa innecesaria en tareas estrictamente definidas. En las evaluaciones del benchmark FrontierCode, por ejemplo, Anthropic señaló que Sonnet 5.5 en modo Max obtuvo una puntuación inferior que en Xhigh porque invocaba con más frecuencia la habilidad de revisión de código de Claude Code. Esta habilidad dividía las revisiones entre múltiples subagentes, lo que en los casos examinados provocó tiempos de espera o ediciones fuera del alcance penalizadas por el entorno de prueba. Por el contrario, Sonnet 5.5 ejecutándose en esfuerzo estándar es especialmente adecuado para una ejecución restringida y bien delimitada: analiza rápidamente las estructuras de los repositorios, evalúa los cambios propuestos y opera dentro de los límites de archivo definidos.
Paridad de benchmarks: Terminal-Bench, CursorBench y GDPval-AA
Las evaluaciones publicadas por Anthropic muestran que Sonnet 5.5 iguala o supera los benchmarks de primer nivel en dominios técnicos cotidianos. En Terminal-Bench 4.0, que evalúa la resolución de problemas de línea de comandos de varios pasos, Sonnet 5.5 obtuvo un 70,6%, superando a Opus 5.5 (66,4%) y a Sonnet 5 (10,3%). En CursorBench 4.0, derivado de sesiones reales de desarrolladores en Cursor, Sonnet 5.5 alcanzó el 55,5%, quedando apenas dos puntos porcentuales por detrás de Opus 5.5 (57,8%). Además, en GDPval-AA v2.1, que mide tareas profesionales reales en 44 ocupaciones, Sonnet 5.5 logró una puntuación Elo de 1844, siguiendo muy de cerca a Opus 5.5 con 1846.
Para examinar cómo los modelos optimizados agilizan la ejecución autónoma, consideremos las diferencias en el flujo de trabajo:
[Bucle de agente insignia monolítico]
  Prompt del usuario ──> Cadena de razonamiento pesada ──> Llamadas a herramientas dispersas (alto consumo de tokens) ──> Riesgo de edición excesiva y tiempo de espera

[Bucle de agente intermedio optimizado]
  Prompt del usuario ──> Mapeo de intenciones con alcance ──> Llamadas a herramientas por lotes ──> Menos pasos de ejecución ──> Parche conciso entregado
Este flujo de trabajo optimizado puede reducir las oportunidades de deriva del contexto y los viajes de ida y vuelta innecesarios. Anthropic reporta una generación de salida un 30% más rápida junto con un menor número de pasos en comparación con Sonnet 5. El modelo agrupa las llamadas a herramientas, minimizando la latencia de red entre el tiempo de ejecución del agente y los entornos host.
Sonnet 5.5 también introduce una infraestructura de seguridad de primer nivel en la categoría intermedia. Es la primera variante de Sonnet que se despliega con salvaguardas de ciberseguridad similares a las de Opus 5.5. Las tareas de descubrimiento de vulnerabilidades de alto riesgo recurren automáticamente a arquitecturas anteriores, mientras que los defensores aprobados reciben permisos escalonados a través del Programa de Verificación Cibernética. Además, el sistema incorpora clasificadores de seguridad diseñados para reducir la extracción de razonamiento a escala industrial y mantener el razonamiento preservado vinculado a la cuenta de origen.
Estrategia arquitectónica: asignación de cargas de trabajo entre modelos de vanguardia e intermedios
A medida que los modelos fundamentales de IA se bifurcan en motores de razonamiento ultra profundo y modelos de ejecución ágil, los líderes de ingeniería deben reevaluar cómo asignan los niveles de modelo a lo largo del ciclo de vida de desarrollo de software. Desplegar un único modelo insignia en toda la canalización de ingeniería introduce latencia y costes innecesarios. En cambio, la infraestructura de desarrollo moderna depende cada vez más del enrutamiento dinámico de modelos, asignando tareas basadas en la complejidad estructural.
Al diseñar flujos de trabajo de producción, los equipos deben sopesar las compensaciones entre el razonamiento conceptual profundo y la resolución de tareas de alto rendimiento. Mientras que los modelos insignia siguen siendo indispensables para la planificación arquitectónica general, los modelos intermedios manejan la gran mayoría de la ejecución de código diaria con una capacidad de respuesta superior.
La siguiente matriz de decisión describe la alineación técnica entre los niveles de modelo:
| Categoría de carga de trabajo | Modelo principal | Perfil de coste | Perfil de latencia | Ideal para |
|---|---|---|---|---|
| Corrección de errores y revisiones de PR | Claude Sonnet 5.5 | Bajo ($2 / $10 por 1M tokens) | Rápido (30%+ más rápido) | Tareas diarias bien definidas y verificaciones CI/CD de alto volumen |
| Arquitectura y migraciones de código base | Claude Opus 5.5 | Alto ($4 / $20 por 1M tokens) | Adaptativo, ciclos de razonamiento profundo | Refactorización compleja y ambigua en repositorios extensos |
| Prototipado interactivo y diseño UI | Claude Sonnet 5.5 | Bajo ($2 / $10 por 1M tokens) | Rápido, iteración responsiva | Diseño de flujos de usuario, diagramas y andamiaje frontend |
| Investigación avanzada en ciberseguridad | Modelos Claude con acceso verificado | Depende del modelo y nivel de acceso | Verificación exhaustiva de varios pasos | Investigación de seguridad autorizada de alto riesgo |
Anthropic estructura las capacidades de ciberseguridad a través de salvaguardas escalonadas. Mientras que la corrección de vulnerabilidades rutinarias procede normalmente en Sonnet 5.5, las tareas de seguridad de mayor riesgo recurren automáticamente a arquitecturas anteriores. Para los defensores autorizados que realizan investigaciones de seguridad avanzadas, el acceso a capacidades ampliadas en los modelos Sonnet 5.5, Opus 5.5 y Mythos se gestiona a través del Programa de Verificación Cibernética.
Al establecer reglas de enrutamiento dinámico, las organizaciones de ingeniería pueden dirigir las revisiones rutinarias de pull requests, la generación de pruebas unitarias y la localización de errores hacia Sonnet 5.5. Esto reserva la capacidad del modelo Opus para refactorizaciones arquitectónicas de alta complejidad, manteniendo los presupuestos de ingeniería predecibles sin comprometer la fiabilidad del software.
Listas de verificación de integración: operacionalización de Sonnet 5.5 en CI/CD empresarial
A medida que las organizaciones de software incorporan modelos rápidos y rentables como Sonnet 5.5 en sus canales de producción, los equipos de ingeniería deben establecer cronogramas de gobernanza sólidos. Maximizar el ahorro de costes requiere alinear los parámetros de la API con la complejidad de las tareas, evitando al mismo tiempo la deriva no controlada de los agentes.
Lista de verificación para desarrolladores
- Configurar niveles de esfuerzo dinámicos: Utilice los ajustes de esfuerzo nativos del modelo (predeterminados en Medio en aplicaciones Claude y Claude Code, y Alto en la Plataforma Claude) para equilibrar la profundidad de razonamiento frente al gasto de tokens.
- Aprovechar el almacenamiento en caché de prompts: Implemente caché de prompts en prompts de sistema estáticos y mapas de repositorios para asegurar un descuento del 90% en tokens de caché ($0,20 por millón de tokens).
- Desplegar procesamiento por lotes asíncrono: Enrute las evaluaciones que no son en tiempo real, las auditorías de código automatizadas y las migraciones por lotes a través de APIs de lotes para lograr un descuento del 50% en los costes estándar de tokens.
- Integrar fallos de seguridad (fail-safes): Establezca interruptores automáticos (circuit breakers) que terminen o redirijan las solicitudes si los bucles de herramientas automatizados exceden los presupuestos de iteración predefinidos.
Lista de verificación de gobernanza e infraestructura
- Reevaluar la economía de las suscripciones: Calcule los costes marginales de cómputo por desarrollador activo para determinar si los modelos intermedios de alta velocidad permiten ofrecer mayores cuotas de uso o precios más bajos.
- Monitorizar ratios de iteración: Mida el número promedio de ejecuciones de herramientas necesarias para resolver las tareas; las reducciones en el número de iteraciones mejoran directamente la satisfacción del desarrollador.
- Configurar el procesamiento solo en EE.UU. cuando sea necesario: Para clientes empresariales regulados con requisitos de residencia de datos, configure los puntos finales de inferencia solo en EE.UU. (disponibles a 1,1x de precio bajo términos empresariales calificados).
- Verificar la elegibilidad de retención de datos cero: Confirme el estado de retención de datos cero con el proveedor de la API, garantizando el cumplimiento empresarial y señalando que las características especializadas como los cachés de prompts persistentes pueden operar bajo términos de retención de datos distintos.
Al adoptar estas prácticas operativas estructuradas, las organizaciones de software pueden convertir la velocidad algorítmica y la eficiencia de tokens en ganancias de desarrollo predecibles.
Preguntas frecuentes (FAQ)
¿Por qué Sonnet 5.5 cuesta menos por tarea si el precio por token coincide con el de Sonnet 5?
¿Puede Claude Sonnet 5.5 reemplazar a Opus 5.5 en ingeniería de software?
¿Cómo impacta el almacenamiento en caché de prompts en los costes operativos de los agentes de codificación?
Conclusiones clave para los equipos de ingeniería
El lanzamiento de Claude Sonnet 5.5 refleja una evolución de la industria desde el escalado de parámetros sin restricciones hacia la eficiencia operativa. Las plataformas de ingeniería de software de alto rendimiento no requieren necesariamente la carga computacional de los modelos insignia para cada fase operativa. Cuando un modelo intermedio resuelve de manera confiable tareas de base de código con alcance en menos iteraciones, el desarrollo de software automatizado se vuelve significativamente más rentable de desplegar a escala.
Capitalizar estas ganancias de eficiencia requiere establecer una arquitectura disciplinada: enrutar tareas dinámicamente según su complejidad, hacer cumplir los límites de uso de herramientas y aplicar sistemáticamente el almacenamiento en caché de prompts. A medida que los proveedores de modelos fundamentales continúen optimizando la eficiencia de tokens junto con el razonamiento bruto, los equipos de ingeniería que diseñen flujos de trabajo modulares y con control de costes mantendrán las operaciones más sostenibles y escalables.
Referencias
-
Anthropic. Presentación de Claude Sonnet 5.5.
-
Anthropic. Tarjeta de sistema de Claude Sonnet 5.5.
-
Anthropic. Precios de la API de Claude y residencia de datos.
-
Anthropic. Términos de servicio comerciales y política de retención de datos.
-
VentureBeat. Anthropic lanza Claude Sonnet 5.5 con una reducción de costes del 30% por tarea.
-
TechCrunch. Anthropic lanza Sonnet 5.5 como un socio de trabajo significativamente más barato y rápido.
-
9to5Mac. Anthropic actualiza Claude con el nuevo modelo Sonnet 5.5.
Share this article



