¿GitHub lanza Copilot Fusion? GitHub anunció oficialmente la disponibilidad general de Copilot Fusion el 28 de octubre de 2026, introduciendo un enrutador y orquestador de modelos en tiempo de ejecución que coordina múltiples modelos de inteligencia artificial para tareas de ingeniería de software. Presentado en la conferencia anual GitHub Universe en San Francisco, el sistema traslada la selección de modelos lejos de los desarrolladores individuales, permitiendo que la plataforma analice los requisitos de las tareas y delegue el trabajo de forma dinámica entre diferentes modelos base. A medida que los equipos de ingeniería de software se enfrentan a crecientes costos de API y fatiga cognitiva por alternar constantemente entre distintos modelos frontera, la orquestación automatizada de modelos está emergiendo como un patrón arquitectónico operativo estándar.
Reajuste central de la industria: GitHub lanza Copilot Fusion en Universe
De un vistazo
- GitHub lanzó la disponibilidad general de Copilot Fusion el 28 de octubre de 2026 en Visual Studio Code, Copilot CLI, los entornos de desarrollo IDE de JetBrains y la aplicación de escritorio de GitHub Copilot.
- El sistema combina la coordinación de múltiples modelos en tiempo de ejecución derivada del proyecto HydraFusion con algoritmos de selección automática de modelos ajustados.
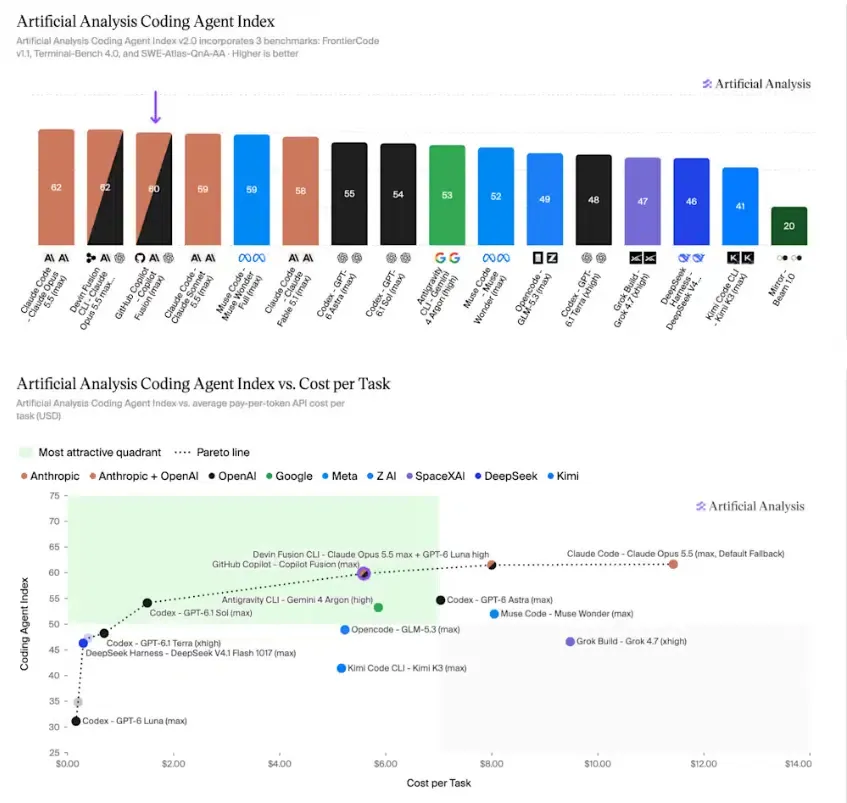
- En evaluaciones independientes realizadas por Artificial Analysis, Fusion Max alcanzó una puntuación compuesta de 60 en el Coding Agent Index v2.0, quedando dos puntos por detrás de Claude Code con Opus 5.5 Max, a la vez que redujo los costos por tarea en aproximadamente un 51%.
Los equipos de desarrollo de software que utilizan asistentes de programación de IA han operado históricamente bajo un paradigma de selección manual. Los programadores elegían un solo modelo —como GPT-4o, Claude Sonnet o un modelo de razonamiento de la serie o1— desde un menú desplegable del IDE y mantenían esa selección durante toda una sesión de programación. Si bien es eficaz para solicitudes aisladas, este patrón introduce compensaciones operativas. Los desarrolladores seleccionan frecuentemente modelos frontera prémium de alta latencia para la planificación arquitectónica compleja y luego omiten volver a cambiar a modelos ligeros al realizar tareas cotidianas como generar pruebas unitarias o redactar documentación repetitiva.
Este enfoque manual puede inflar los gastos corporativos en API y consumir tokens de contexto de manera ineficiente. Para abordar estas compensaciones en el flujo de trabajo, GitHub desarrolló Copilot Fusion, tal como se detalla en el anuncio oficial de GitHub. En lugar de tratar la programación con IA como una interacción con un único modelo estático, Fusion opera como un coordinador en tiempo de ejecución. Los desarrolladores designan un nivel general de esfuerzo de razonamiento, y el sistema selecciona de forma autónoma el modelo subyacente más adecuado o la combinación de modelos para cada paso de una tarea.

El giro estratégico representado por el lanzamiento de GitHub Copilot Fusion se centra en la economía a nivel de tarea en lugar de en el escalado de parámetros brutos. Según las evaluaciones de referencia publicadas por Artificial Analysis, Copilot Fusion Max, probado a través de Copilot CLI en el Coding Agent Index v2.0, completó tareas de programación de referencia a un costo promedio de $5.59 por tarea, en comparación con los $11.42 de Claude Code ejecutando Claude Opus 5.5 de Anthropic en su configuración máxima. La configuración evaluada consumió aproximadamente 7.2 millones de tokens por tarea —aproximadamente la mitad del volumen de tokens de la configuración independiente de Opus— mientras completaba las tareas en un tiempo aproximado un 40% menor.
El rendimiento varió según los componentes individuales de referencia: Fusion Max lideró en Terminal-Bench 4.0 con una puntuación de 71, pero obtuvo 51 en FrontierCode (por detrás de los 56 de Claude Code) y 57 en SWE-Atlas-QnA-AA. Además, aunque la dirección de Microsoft citó evaluaciones internas de DeepSWE que muestran reducciones potenciales de costos de hasta el 77%, esa cifra representa un escenario máximo reportado por la empresa independiente y no un promedio de referencia independiente. Estos resultados confirman que la orquestación dinámica de múltiples modelos puede reducir significativamente los gastos de desarrollo para los flujos de trabajo compatibles, aunque los ahorros reales dependen de la combinación específica de tareas, los requisitos de revisión y los patrones de uso empresarial.
Patrones arquitectónicos: Topologías de ejecución Simple, en Cascada y de Crítica
Copilot Fusion no opera como un modelo base independiente. En su lugar, funciona como un plano de control inteligente integrado dentro del cliente del desarrollador. Cuando un usuario envía una instrucción que implica razonamiento, generación de código, depuración o el uso de herramientas, Fusion evalúa las señales de intención entrantes frente a la salud del sistema en tiempo real, la disponibilidad y la complejidad semántica.
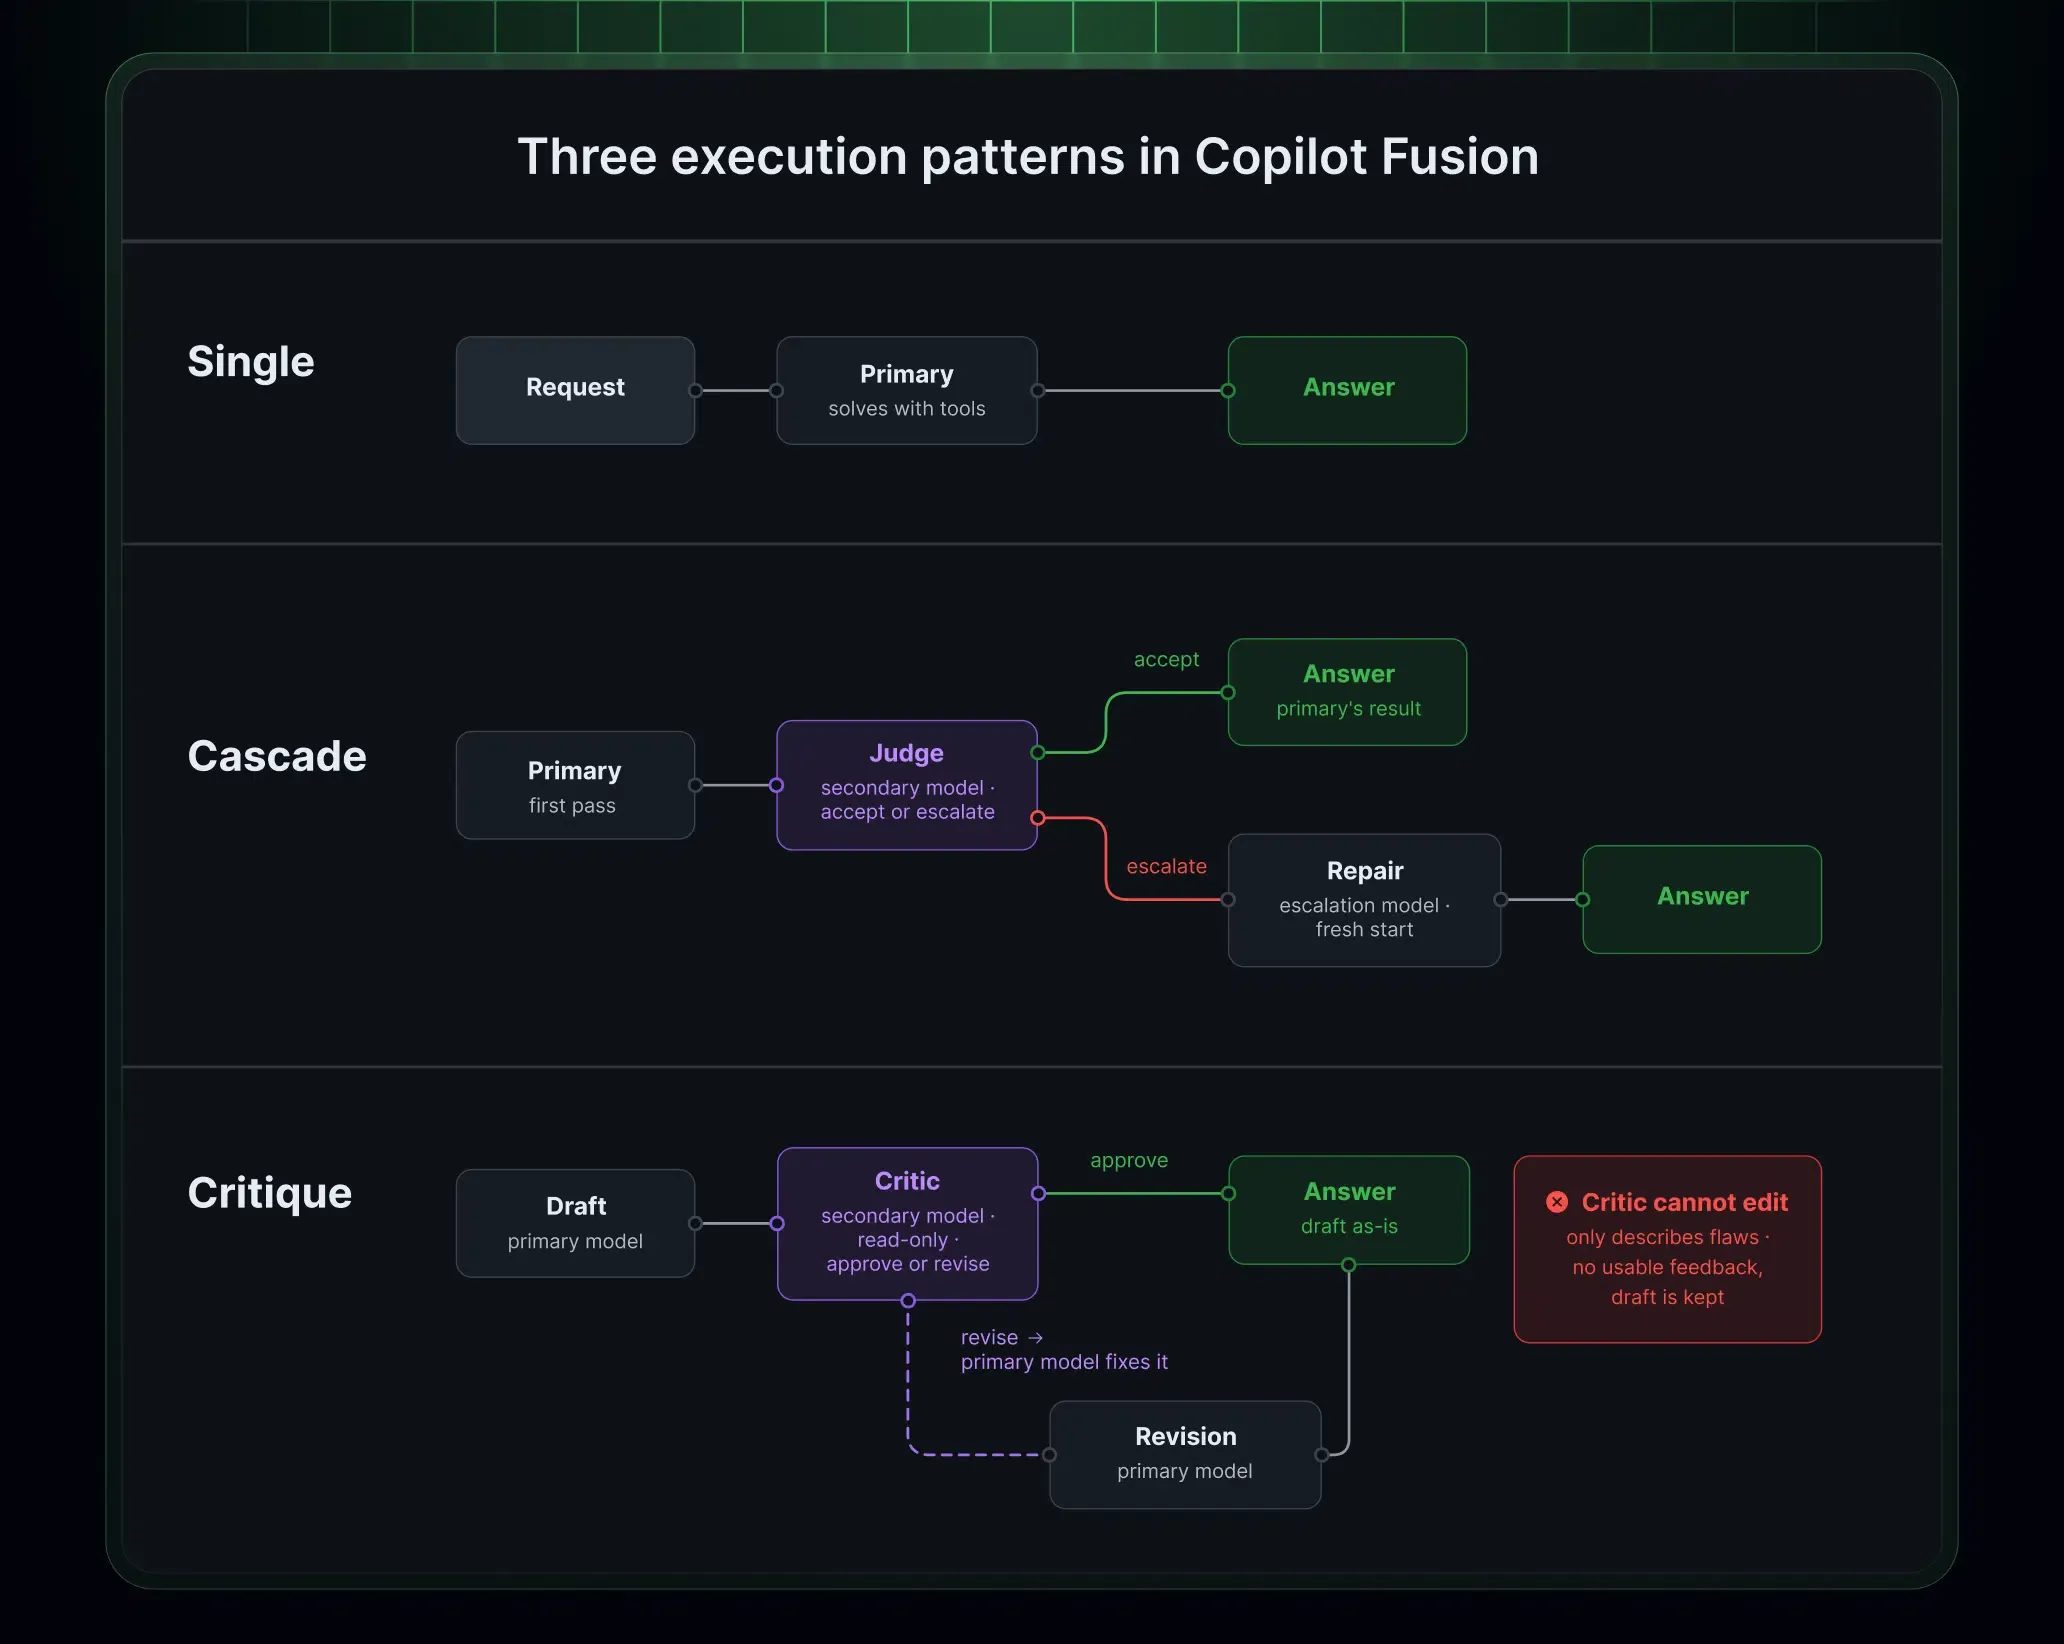
Dependiendo de las características de la tarea y el nivel de esfuerzo elegido, el sistema selecciona dinámicamente uno de los tres patrones de ejecución:
- Patrón Simple: Un solo modelo recibe la indicación y completa la tarea directamente, añadiendo cero sobrecarga de revisión. Este patrón sirve para la generación de código directa, consultas sintácticas y refactorización básica.
- Patrón en Cascada: Un modelo ligero redacta una solución inicial. Un modelo de evaluación secundario inspecciona el código propuesto y determina si acepta el resultado o escala la tarea a un modelo más capaz para una pasada refinada.
- Patrón de Crítica: Un modelo principal redacta una respuesta inicial mientras uno o más modelos revisores evalúan de manera independiente el código en paralelo. El orquestador agrupa sus comentarios y el modelo principal revisa el código en consecuencia antes de devolver el resultado final al usuario.
[Single Pattern]
  Prompt ──> Primary Model ──> Single Execution ──> Final Code Output

[Cascade Pattern]
  Prompt ──> Lightweight Model ──> Initial Draft ──> Judge Model ──[Accept]──> Final Code Output
                                                         └──[Escalate]──> Stronger Model ──> Final Output

[Critique Pattern]
  Prompt ──> Drafting Model ──> Initial Draft ──┬─> Reviewer Model A ──┐
                                                └─> Reviewer Model B ──┴─> Feedback Aggregator ──> Final Revision
Estas topologías de ejecución introducen compensaciones claras entre la velocidad de ejecución, el rigor de verificación y el costo computacional. En lugar de codificar indicaciones para patrones específicos, GitHub mapea estos flujos de trabajo a través de niveles de esfuerzo seleccionables:
- Fusion Standard: Equilibra el costo, la calidad y la latencia para la programación diaria. La implementación actual normalmente selecciona un modelo por tarea.
- Fusion High: Prioriza una mayor capacidad y un razonamiento más profundo para tareas de programación sustanciales, al tiempo que considera la eficiencia de los tokens. Se puede utilizar la orquestación de múltiples modelos cuando esté justificado.
- Fusion Max: Prioriza la capacidad de nivel frontera para las tareas más exigentes, con pasos adicionales de revisión o escalado seleccionados dinámicamente cuando sea útil.
- Fusion Fast: Un nivel de esfuerzo especializado que no puede ser seleccionado por el usuario y que se utiliza en escenarios compatibles de chat en línea de Visual Studio Code sensibles a la latencia.
La gestión de los límites de contexto en flujos de trabajo dinámicos requiere un manejo de memoria especializado. Copilot Fusion no posee una ventana de contexto unificada propia. En su lugar, cada paso de ejecución opera estrictamente dentro de los límites de contexto del modelo específico que ejecuta esa subtarea. La capacidad de contexto mostrada en el IDE refleja el límite más conservador entre los modelos participantes. Además, para maximizar la eficiencia del almacenamiento en caché de las indicaciones, Fusion retiene el hilo conversacional principal en un solo modelo primario siempre que sea posible, pasando únicamente las ventanas de contexto aisladas necesarias a los modelos revisores de apoyo.
Gobernanza empresarial e integración de modelos locales en flotas de desarrolladores
Implementar la orquestación autónoma de modelos en grandes organizaciones de ingeniería corporativa introduce consideraciones de gobernanza, cumplimiento y presupuesto. Cuando un sistema de IA selecciona dinámicamente entre modelos de Anthropic, OpenAI y otros proveedores, los administradores deben garantizar que la residencia de datos y las reglas de seguridad de la organización se mantengan intactas.
Los administradores empresariales pueden gestionar los modelos elegibles para Copilot Fusion a través de las directivas de modelos compatibles de GitHub Copilot y la configuración gestionada por la empresa, tal como se documenta en el manual administrativo de Copilot Fusion. Los administradores pueden ver la lista de modelos disponibles para Fusion, establecer niveles de esfuerzo predeterminados en las licencias de los desarrolladores y desactivar modelos específicos para Fusion sin deshabilitarlos en toda la empresa. Fusion respeta las restricciones aplicables de suscripción, organización, residencia de datos, relacionadas con FedRAMP y de modelos de evaluación. Estos controles rigen la elegibilidad de los modelos dentro del sistema, pero no reemplazan los propios procesos de revisión de cumplimiento, gobernanza de datos o validación de seguridad de una organización.
La tabla siguiente describe cómo las diferentes arquitecturas de ejecución equilibran las superficies de ejecución, la mecánica de revisión y los perfiles de gasto de tokens:
| Patrón de ejecución | Invocación principal | Mecanismo de revisión | Perfil de costo de tokens | Ideal para |
|---|---|---|---|---|
| Single Mode | Un modelo dedicado | Ninguno | Precios estándar base del modelo | Ediciones de código directas y preguntas de sintaxis |
| Cascade Mode | Modelo de borrador eficiente | Inspección del modelo de evaluación y escalado | De bajo a moderado (escalado condicional) | Corrección de errores bien acotada y modificaciones estructuradas |
| Critique Mode | Generador principal | Modelos revisores independientes paralelos | Más alto (múltiples llamadas a modelos simultáneas) | Lógica arquitectónica compleja y código sensible a la seguridad |
| Local Model Hybrid | Modelo local compatible en el dispositivo | Selección de modelos coordinada en la nube | Menor consumo de tokens en la nube en pasos locales | Inferencia elegible en el dispositivo con enrutamiento coordinado en la nube |
GitHub introdujo el enrutamiento con conocimiento de modelos locales como una vista previa experimental opcional, tal como se anunció en el registro de cambios de GitHub sobre la selección de modelos locales. Con un modelo local compatible configurado, Copilot Fusion Standard puede seleccionar la inferencia en el dispositivo para las tareas elegibles, reduciendo el uso de modelos en la nube para esos pasos. En sistemas Windows con hardware compatible, los desarrolladores pueden instalar y ejecutar MAI Code 1.1 Flash a través de la gestión de Windows ML dentro de la aplicación Copilot, Copilot CLI o Visual Studio Code. Los usuarios multiplataforma en Windows, macOS y Linux pueden configurar modelos locales como Qwen3.8 Flash Next en Copilot CLI utilizando proveedores de modelos locales como Ollama, iniciando la CLI con la etiqueta --experimental.
Sin embargo, Copilot Fusion todavía depende de decisiones de enrutamiento basadas en la nube, y las tareas pueden utilizar modelos en la nube cuando sea apropiado. Por lo tanto, la compatibilidad con modelos locales no convierte a Copilot Fusion en un entorno de programación totalmente sin conexión; los desarrolladores que requieran seguridad desconectada deben evaluar herramientas dedicadas fuera de línea en su lugar.
Lista de verificación de ingeniería: Adopción de la orquestación multimodelo en producción
La integración de la orquestación en tiempo de ejecución de múltiples modelos en los flujos de trabajo de desarrollo de software requiere ajustes en los hábitos de los desarrolladores, las configuraciones del IDE y las operaciones financieras de la empresa. El liderazgo de ingeniería debe establecer protocolos operativos claros para capitalizar las eficiencias de los tokens al tiempo que se evitan los escollos en el flujo de trabajo.
Lista de verificación de implementación para desarrolladores
- Inspeccionar las diferencias del espacio de trabajo antes de las confirmaciones (commits): Descartar un borrador de IA no revierte automáticamente las modificaciones de los archivos del espacio de trabajo; los desarrolladores deben revisar todas las ediciones de archivos no confirmadas antes de enviar el código.
- Adaptar los niveles de esfuerzo a la complejidad de la tarea: Reserve Fusion Max para lógica algorítmica compleja y auditorías de seguridad, utilizando Fusion Standard para la programación diaria para evitar un consumo innecesario de créditos de IA.
- Auditar los flujos de progreso multimodelo: Observe los indicadores de progreso del IDE para inspeccionar qué modelos específicos contribuyen a los bloques de código generados, garantizando la transparencia en los pasos de ejecución.
- Configurar modelos locales compatibles: Para las tareas elegibles en Fusion Standard, configure modelos locales compatibles como MAI Code 1.1 Flash en Windows o Qwen3.8 Flash Next a través de Ollama, habilitando la configuración experimental cuando sea necesario.
Lista de verificación de gobernanza empresarial y FinOps
- Configurar directivas de modelos empresariales: Especifique qué modelos son elegibles para el enrutamiento de Fusion en el panel de control de la empresa, alineando la lista de modelos con el cumplimiento corporativo y los requisitos de residencia de datos.
- Auditar los créditos de IA basados en el uso: Realice un seguimiento del consumo de créditos a nivel de equipo en los distintos niveles de esfuerzo, teniendo en cuenta que la ejecución de múltiples modelos en Fusion High y Max puede consumir más créditos por tarea que las ejecuciones de un solo modelo.
- Contabilizar las ventanas de facturación promocionales: Tenga en cuenta el descuento promocional del 30% de GitHub en los costos de los modelos para los suscriptores de pago de Copilot hasta el 30 de noviembre de 2026, al realizar evaluaciones comparativas de los gastos operativos.
- Establecer filtros de revisión de código humanos: Mantenga revisiones de código por pares obligatorias para todas las solicitudes de extracción (pull requests) generadas por agentes, asegurando que los bucles de crítica automatizados complementen, en lugar de reemplazar, la supervisión de la ingeniería humana.
Preguntas frecuentes (FAQ)
¿Cómo calcula GitHub la facturación cuando Copilot Fusion llama a varios modelos?
¿Qué sucede si Copilot Fusion descarta un borrador de código intermedio?
¿Pueden los administradores empresariales restringir qué modelos selecciona Copilot Fusion?
Puntos clave para los equipos de ingeniería
El lanzamiento de GitHub Copilot Fusion confirma que depender de un único modelo de IA monolítico para tareas complejas de ingeniería de software introduce compensaciones operativas innecesarias. Los flujos de trabajo de desarrollo modernos abarcan diversas demandas cognitivas, que van desde la finalización instantánea de la sintaxis hasta un intrincado razonamiento entre repositorios. Forzar a una arquitectura de un solo modelo a manejar todo este espectro puede generar un aumento en los gastos de modelos o una calidad de ejecución comprometida.
Los resultados de pruebas independientes sugieren que la orquestación multimodelo puede ofrecer un rendimiento de programación competitivo a menores costos de modelos para ciertas cargas de trabajo. Los resultados reales dependerán de la complejidad de la tarea, el comportamiento de la orquestación, los modelos seleccionados y los patrones de uso de la organización. Al desacoplar la delegación de tareas de las elecciones manuales de los desarrolladores, la orquestación de modelos en tiempo de ejecución establece un camino operativo pragmático. A medida que las organizaciones de ingeniería de software escalen los agentes de programación automatizados, el principal diferenciador competitivo no será el acceso a ningún modelo base individual, sino la gobernanza, la confiabilidad y el rigor arquitectónico de la capa de orquestación que los conecta.
Referencias
-
GitHub: Route and Orchestrate Models with GitHub Copilot Fusion — Notas de la versión oficial y resumen de características de GitHub Universe 2026.
-
GitHub: Copilot Fusion Now Supports Selection of Local Models — Anuncio oficial que detalla la inferencia en el dispositivo para tareas elegibles con enrutamiento de modelos locales.
-
Documentación de GitHub: Acerca de los conceptos y la configuración de GitHub Copilot Fusion — Documentación técnica oficial que detalla los patrones de ejecución, los niveles de esfuerzo y las reglas de facturación.
-
Documentación de GitHub: Configuración de modelos disponibles para Copilot Fusion — Guía administrativa para gestionar las directivas de modelos empresariales y la configuración predeterminada.
-
Artificial Analysis: Evaluación comparativa de GitHub Copilot Fusion — Análisis independiente que mide los costos de las tareas, la eficiencia de los tokens y las puntuaciones del Coding Agent Index.
-
The New Stack: GitHub presenta el sistema multimodelo Copilot Fusion — Reportaje técnico sobre la integración del proyecto HydraFusion y la implementación en clientes empresariales.
-
VentureBeat: GitHub Copilot Fusion combina modelos para lograr eficiencia de costos — Entrevista técnica con la dirección de producto de GitHub sobre las arquitecturas de enrutamiento en tiempo de ejecución.
Share this article