GitHub lance Copilot Fusion ? GitHub a officiellement annoncé la disponibilité générale de Copilot Fusion le 28 octobre 2026, introduisant un routeur et un orchestrateur de modèles d'exécution qui coordonne plusieurs modèles d'intelligence artificielle pour les tâches de génie logiciel. Dévoilé lors de la conférence annuelle GitHub Universe à San Francisco, le système soustrait la sélection des modèles aux développeurs individuels, permettant à la plateforme d'analyser les exigences des tâches et de déléguer dynamiquement le travail entre différents modèles de fondation. Alors que les équipes d'ingénierie logicielle font face à des coûts d'API croissants et à une fatigue cognitive due au basculement constant entre différents modèles de pointe, l'orchestration automatisée des modèles s'impose comme un modèle architectural opérationnel standard.
Réalignement sectoriel majeur : GitHub lance Copilot Fusion lors de Universe
En un coup d'œil
- GitHub a lancé la disponibilité générale de Copilot Fusion le 28 octobre 2026 pour Visual Studio Code, Copilot CLI, les IDE JetBrains et l'application de bureau GitHub Copilot.
- Le système associe la coordination multi-modèle en temps réel issue du projet HydraFusion à des algorithmes de sélection automatique de modèles affinés.
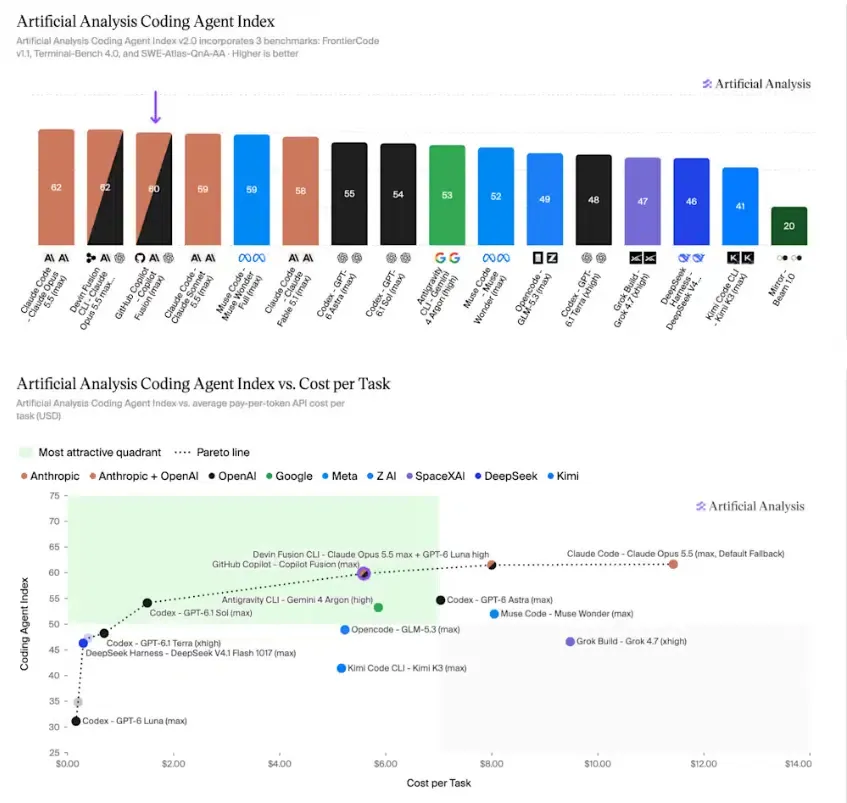
- Dans le cadre d'évaluations indépendantes menées par Artificial Analysis, Fusion Max a obtenu un score composite de 60 sur l'indice Coding Agent Index v2.0, se classant à deux points derrière Claude Code avec Opus 5.5 Max tout en réduisant les coûts des tâches d'environ 51 %.
Les équipes de développement logiciel utilisant des assistants de codage par IA ont historiquement fonctionné selon un paradigme de sélection manuelle. Les programmeurs choisissaient un modèle unique — tel que GPT-4o, Claude Sonnet ou un modèle de raisonnement de la série o1 — dans un menu déroulant de l'IDE et maintenaient ce choix tout au long d'une session de codage. Bien qu'efficace pour des invites isolées, ce schéma entraîne des compromis opérationnels. Les développeurs sélectionnent fréquemment des modèles de pointe haut de gamme à forte latence pour la planification architecturale complexe, puis oublient de repasser à des modèles légers lors de tâches courantes telles que la génération de tests unitaires ou la rédaction de documentation standard.
Cette approche manuelle peut faire grimper les dépenses en API des entreprises et consommer les jetons de contexte de manière inefficace. Pour remédier à ces compromis de flux de travail, GitHub a développé Copilot Fusion, comme indiqué dans

Le pivot stratégique représenté par la sortie de GitHub lance Copilot Fusion s'articule autour de l'économie par tâche plutôt que de la simple mise à l'échelle des paramètres. Selon les évaluations de tests de référence publiées par Artificial Analysis, Copilot Fusion Max, testé via Copilot CLI sur l'indice Coding Agent Index v2.0, a réalisé des missions de codage de référence à un coût moyen de $5.59 par tâche, contre $11.42 pour Claude Code exécutant Claude Opus 5.5 d'Anthropic à son paramètre maximum. La configuration évaluée a consommé environ 7,2 millions de jetons par tâche — soit environ la moitié du volume de jetons de la configuration Opus autonome — tout en achevant les tâches en environ 40 % de temps en moins.
Les performances ont varié selon les composants individuels des tests de référence : Fusion Max a pris la tête sur Terminal-Bench 4.0 avec un score de 71, mais a obtenu 51 sur FrontierCode (derrière les 56 de Claude Code) et 57 sur SWE-Atlas-QnA-AA. De plus, bien que la direction de Microsoft ait cité des évaluations internes DeepSWE montrant des réductions de coûts potentielles allant jusqu'à 77 %, ce chiffre représente un scénario maximal distinct rapporté par l'entreprise plutôt qu'une moyenne de test de référence indépendante. Ces résultats confirment que l'orchestration multi-modèle dynamique peut réduire considérablement les dépenses de développement pour les flux de travail pris en charge, bien que les économies réelles dépendent de la combinaison spécifique des tâches, des exigences de révision et des habitudes d'utilisation de l'entreprise.
Modèles architecturaux : topologies d'exécution simple, en cascade et par critique
Copilot Fusion ne fonctionne pas comme un modèle de fondation indépendant. Il agit plutôt comme un plan de contrôle intelligent intégré au client développeur. Lorsqu'un utilisateur soumet une instruction impliquant du raisonnement, de la génération de code, du débogage ou l'utilisation d'outils, Fusion évalue les signaux d'intention entrants par rapport à la santé du système en temps réel, à la disponibilité et à la complexité sémantique.
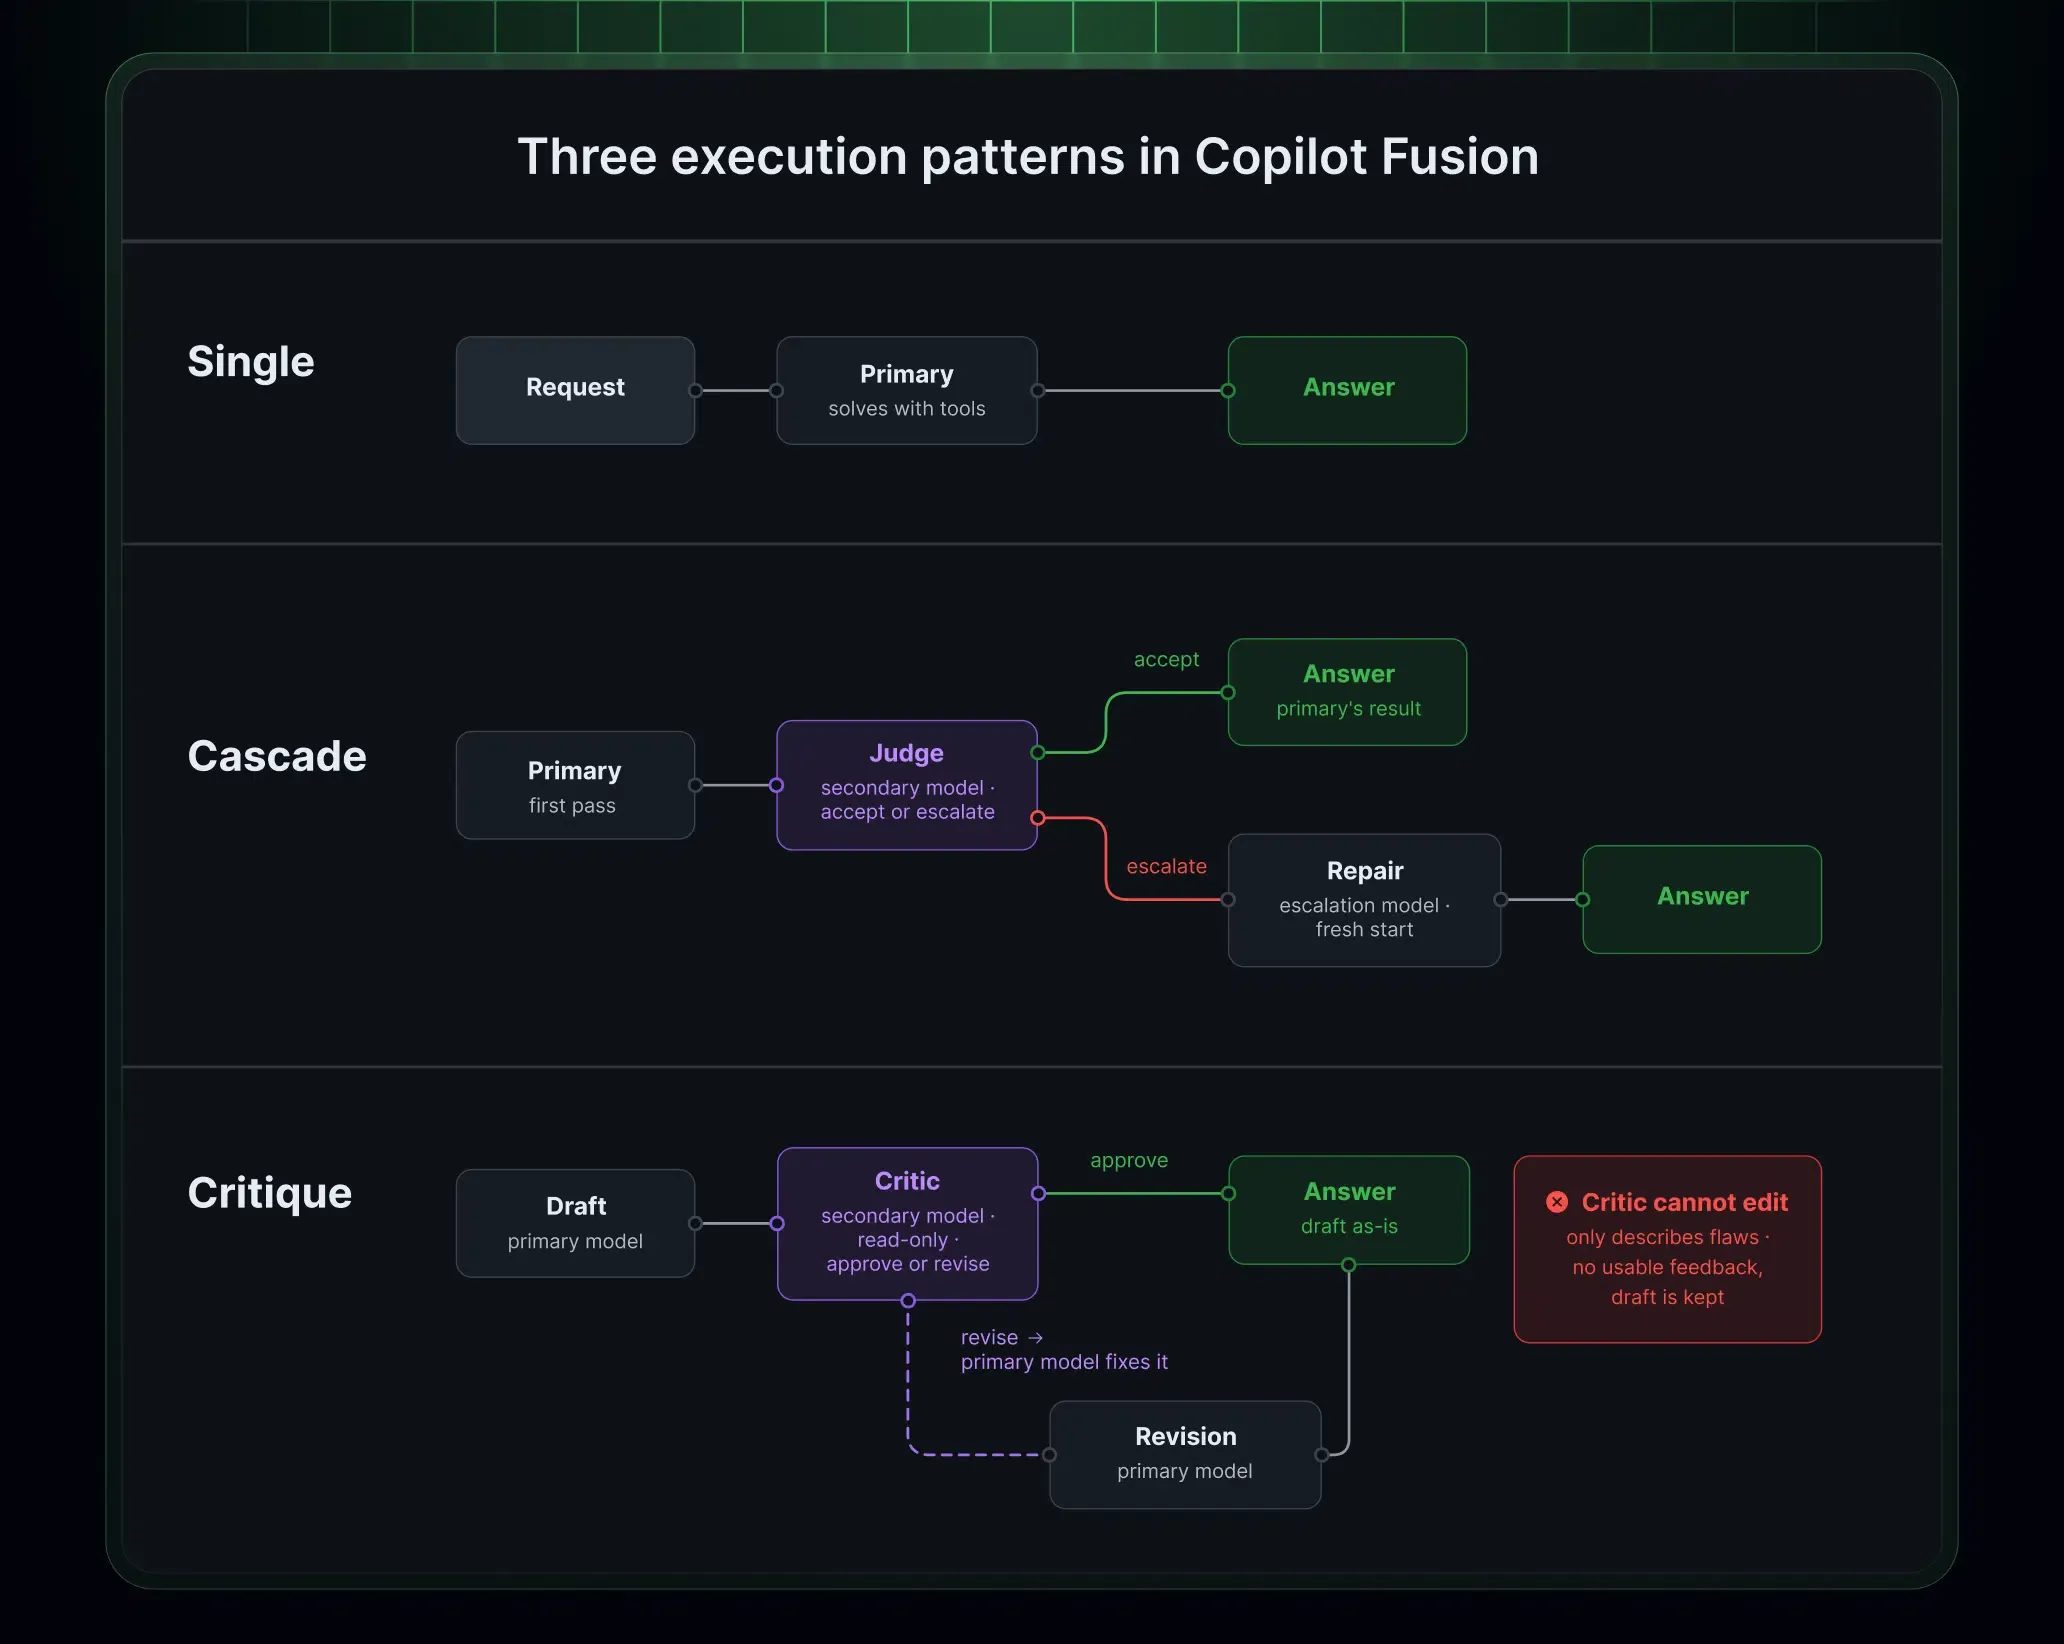
Selon les caractéristiques de la tâche et le niveau d'effort choisi, le système sélectionne dynamiquement l'un des trois schémas d'exécution :
- Modèle simple (Single Pattern) : Un seul modèle reçoit l'invite et exécute la tâche directement, sans ajouter de charge de travail de révision. Ce modèle convient à la génération de code simple, aux requêtes syntaxiques et au refactoring de base.
- Modèle en cascade (Cascade Pattern) : Un modèle léger élabore une solution initiale. Un deuxième modèle d'évaluation inspecte le code proposé et détermine s'il faut accepter le résultat ou confier la tâche à un modèle plus performant pour une passe affinée.
- Modèle par critique (Critique Pattern) : Un modèle principal élabore une réponse initiale tandis qu'un ou plusieurs modèles examinateurs évaluent indépendamment le code en parallèle. L'orchestrateur agrège leurs commentaires, et le modèle principal révise le code en conséquence avant de renvoyer le résultat final à l'utilisateur.
[Single Pattern]
  Prompt ──> Primary Model ──> Single Execution ──> Final Code Output

[Cascade Pattern]
  Prompt ──> Lightweight Model ──> Initial Draft ──> Judge Model ──[Accept]──> Final Code Output
                                                         └──[Escalate]──> Stronger Model ──> Final Output

[Critique Pattern]
  Prompt ──> Drafting Model ──> Initial Draft ──┬─> Reviewer Model A ──┐
                                                └─> Reviewer Model B ──┴─> Feedback Aggregator ──> Final Revision
Ces topologies d'exécution introduisent des compromis distincts entre la vitesse d'exécution, la rigueur de la vérification et le coût informatique. Plutôt de coder en dur des invites pour des schémas spécifiques, GitHub associe ces flux de travail à des niveaux d'effort sélectionnables :
- Fusion Standard : Équilibre les coûts, la qualité et la latence pour le codage quotidien. L'implémentation actuelle sélectionne généralement un modèle par tâche.
- Fusion High : Donne la priorité à une capacité renforcée et à un raisonnement plus poussé pour les tâches de codage importantes, tout en tenant compte de l'efficacité des jetons. L'orchestration multi-modèle peut être utilisée lorsque cela se justifie.
- Fusion Max : Donne la priorité à une capacité de pointe pour les tâches les plus exigeantes, avec des étapes supplémentaires de révision ou d'escalade sélectionnées dynamiquement lorsque cela s'avère utile.
- Fusion Fast : Un niveau d'effort spécialisé et non sélectionnable par l'utilisateur, utilisé dans les scénarios de chat en ligne pris en charge et sensibles à la latence de Visual Studio Code.
La gestion des limites de contexte dans le cadre de flux de travail dynamiques nécessite une gestion spécialisée de la mémoire. Copilot Fusion ne possède pas sa propre fenêtre de contexte unifiée. Au lieu de cela, chaque étape d'exécution fonctionne strictement dans les limites de contexte du modèle spécifique qui exécute cette sous-tâche. La capacité de contexte affichée dans l'IDE reflète la limite la plus conservatrice parmi les modèles participants. En outre, pour maximiser l'efficacité de la mise en cache des invites, Fusion conserve le fil conversationnel principal sur un seul modèle principal chaque fois que cela est possible, en ne transmettant que les fenêtres de contexte isolées nécessaires aux modèles examinateurs assistants.
Gouvernance d'entreprise et intégration de modèles locaux dans les parcs de développeurs
Le déploiement d'une orchestration de modèles autonome au sein de grandes organisations d'ingénierie d'entreprise soulève des questions de gouvernance, de conformité et de budget. Lorsqu'un système d'IA sélectionne dynamiquement des modèles provenant d'Anthropic, d'OpenAI et d'autres fournisseurs, les administrateurs doivent s'assurer que la résidence des données et les règles de sécurité de l'organisation restent intactes.
Les administrateurs d'entreprise peuvent gérer les modèles éligibles pour Copilot Fusion via les politiques de modèles GitHub Copilot prises en charge et les paramètres gérés par l'entreprise, comme indiqué dans le manuel d'administration de Copilot Fusion. Les administrateurs peuvent consulter la liste des modèles disponibles pour Fusion, définir des niveaux d'effort par défaut pour les postes de développeur et désactiver des modèles spécifiques pour Fusion sans les désactiver à l'échelle de l'entreprise. Fusion respecte les restrictions d'abonnement, d'organisation, de résidence des données, liées à FedRAMP et aux modèles d'évaluation applicables. Ces contrôles régissent l'éligibilité des modèles au sein du système, mais ils ne remplacent pas les propres processus d'examen de la conformité, de gouvernance des données ou de validation de la sécurité de l'organisation.
Le tableau ci-dessous indique la manière dont les différentes architectures d'exécution équilibrent les surfaces d'exécution, les mécanismes de révision et les profils de dépenses en jetons :
| Modèle d'exécution | Appel principal | Mécanisme de révision | Profil de coût en jetons | Idéal pour |
|---|---|---|---|---|
| Mode simple (Single Mode) | Un modèle dédié | Aucun | Tarification standard du modèle de base | Modifications de code simples et questions de syntaxe |
| Mode cascade (Cascade Mode) | Modèle de rédaction efficace | Inspection et escalade par un modèle d'évaluation | Faible à modéré (escalade conditionnelle) | Corrections de bugs bien ciblées et modifications structurées |
| Mode critique (Critique Mode) | Générateur principal | Modèles examinateurs indépendants en parallèle | Élevé (plusieurs appels simultanés de modèles) | Logique architecturale complexe et code sensible à la sécurité |
| Hybride local-modèle | Modèle local sur l'appareil pris en charge | Sélection de modèles coordonnée par le cloud | Consommation de jetons cloud réduite sur les étapes locales | Inférence sur l'appareil éligible avec routage coordonné par le cloud |
GitHub a introduit le routage tenant compte des modèles locaux sous forme de version préliminaire expérimentale facultative, comme annoncé dans le Journal des modifications GitHub sur la sélection des modèles locaux. Avec un modèle local pris en charge configuré, Copilot Fusion Standard peut sélectionner l'inférence sur l'appareil pour les tâches éligibles, réduisant ainsi l'utilisation des modèles cloud pour ces étapes. Sur les systèmes Windows dotés d'un matériel compatible, les développeurs peuvent installer et exécuter MAI Code 1.1 Flash via la gestion Windows ML dans l'application Copilot, Copilot CLI ou Visual Studio Code. Les utilisateurs multiplateformes sous Windows, macOS et Linux peuvent configurer des modèles locaux tels que Qwen3.8 Flash Next dans Copilot CLI à l'aide de fournisseurs de modèles locaux comme Ollama, en lançant la CLI avec l'indicateur --experimental.
Cependant, Copilot Fusion s'appuie toujours sur des décisions de routage basées sur le cloud, et les tâches peuvent utiliser des modèles cloud si nécessaire. La prise en charge des modèles locaux ne fait donc pas de Copilot Fusion un environnement de codage entièrement hors ligne ; les développeurs nécessitant une sécurité isolée (air-gapped) doivent plutôt évaluer des outils dédiés hors ligne.
Liste de contrôle pour l'ingénierie : adoption de l'orchestration multi-modèle en production
L'intégration de l'orchestration des modèles d'exécution dans les flux de travail de développement logiciel nécessite des ajustements au niveau des habitudes des développeurs, des configurations de l'IDE et des opérations financières de l'entreprise (FinOps). Les responsables de l'ingénierie doivent établir des protocoles opérationnels clairs pour capitaliser sur l'efficacité des jetons tout en évitant les pièges des flux de travail.
Liste de contrôle d'implémentation pour les développeurs
- Inspecter les différences de l'espace de travail (diffs) avant les validations (commits) : L'abandon d'un brouillon d'IA ne restaure pas automatiquement les modifications apportées aux fichiers de l'espace de travail ; les développeurs doivent examiner toutes les modifications de fichiers non validées avant de soumettre du code.
- Adapter les niveaux d'effort à la complexité de la tâche : Réservez Fusion Max à la logique algorithmique complexe et à l'audit de sécurité, et utilisez Fusion Standard pour le codage quotidien afin d'éviter toute consommation inutile de crédits d'IA.
- Auditer les flux de progression multi-modèles : Observez les indicateurs de progression de l'IDE pour inspecter les modèles spécifiques qui contribuent aux blocs de code générés, garantissant ainsi la transparence à chaque étape de l'exécution.
- Configurer les modèles locaux pris en charge : Pour les tâches éligibles sur Fusion Standard, configurez les modèles locaux pris en charge tels que MAI Code 1.1 Flash sous Windows ou Qwen3.8 Flash Next via Ollama, en activant les paramètres expérimentaux si nécessaire.
Liste de contrôle pour la gouvernance d'entreprise et les FinOps
- Configurer les politiques de modèles d'entreprise : Spécifiez les modèles éligibles au routage Fusion dans le tableau de bord de l'entreprise, en alignant la liste des modèles sur la conformité de l'entreprise et les exigences de résidence des données.
- Auditer les crédits d'IA basés sur l'utilisation : Suivez la consommation de crédits au niveau des équipes selon les différents niveaux d'effort, en tenant compte du fait que l'exécution multi-modèle dans Fusion High et Max peut consommer plus de crédits par tâche que les exécutions à modèle unique.
- Tenir compte des périodes de facturation promotionnelles : Intégrez la remise promotionnelle de 30 % de GitHub sur les coûts des modèles pour les abonnés payants de Copilot jusqu'au 30 novembre 2026 lors de l'évaluation comparative des dépenses opérationnelles.
- Établir des passerelles de révision de code humaine : Maintenez des révisions de code par les pairs obligatoires pour toutes les demandes d'extraction (pull requests) générées par des agents, en veillant à ce que les boucles de critique automatisées complètent, plutôt qu'elles ne remplacent, la supervision de l'ingénierie humaine.
Foire aux questions (FAQ)
Comment GitHub calcule-t-il la facturation lorsque Copilot Fusion appelle plusieurs modèles ?
Que se passe-t-il si Copilot Fusion rejette un projet de code intermédiaire ?
Les administrateurs d'entreprise peuvent-ils restreindre les modèles que Copilot Fusion sélectionne ?
Points clés pour les équipes d'ingénierie
Le lancement de GitHub Copilot Fusion confirme que le fait de s'appuyer sur un modèle d'IA unique et monolithique pour des tâches de génie logiciel complexes entraîne des compromis opérationnels superflus. Les flux de travail de développement modernes englobent diverses exigences cognitives, allant de la complétion instantanée de la syntaxe au raisonnement complexe entre différents dépôts. Forcer une architecture à modèle unique à gérer l'ensemble de ce spectre peut entraîner une augmentation des dépenses liées aux modèles ou compromettre la qualité de l'exécution.
Les résultats des tests de référence indépendants suggèrent que l'orchestration multi-modèle peut offrir des performances de codage compétitives à des coûts de modèle inférieurs pour certaines charges de travail. Les résultats réels dépendront de la complexité des tâches, du comportement d'orchestration, des modèles sélectionnés et des habitudes d'utilisation de l'organisation. En dissociant la délégation des tâches des choix manuels du développeur, l'orchestration des modèles d'exécution établit une voie opérationnelle pragmatique. À mesure que les organisations d'ingénierie logicielle déploient des agents de codage automatisés, le principal facteur de différenciation concurrentielle ne sera pas l'accès à un modèle de fondation individuel, mais la gouvernance, la fiabilité et la rigueur architecturale de la couche d'orchestration qui les relie.
Références
-
GitHub : Route and Orchestrate Models with GitHub Copilot Fusion — Notes de version officielles et aperçu des fonctionnalités de GitHub Universe 2026.
-
GitHub : Copilot Fusion Now Supports Selection of Local Models — Annonce officielle détaillant l'inférence sur l'appareil pour les tâches éligibles avec routage de modèles locaux.
-
Documentation GitHub : À propos des concepts et de la configuration de GitHub Copilot Fusion — Documentation technique officielle détaillant les schémas d'exécution, les niveaux d'effort et les règles de facturation.
-
Documentation GitHub : Configuration des modèles disponibles pour Copilot Fusion — Guide administratif pour la gestion des politiques de modèles d'entreprise et des paramètres par défaut.
-
Artificial Analysis : Évaluation comparative de GitHub Copilot Fusion — Analyse indépendante mesurant les coûts des tâches, l'efficacité des jetons et les scores de l'indice Coding Agent Index.
-
The New Stack : GitHub lance le système multi-modèle Copilot Fusion — Rapport technique sur l'intégration du projet HydraFusion et la mise en œuvre auprès des clients entreprises.
-
VentureBeat : GitHub Copilot Fusion associe des modèles pour optimiser les coûts — Entretien technique avec la direction des produits de GitHub portant sur les architectures de routage d'exécution.
Share this article



