Google dévoile Gemini 4 Hydrogen ? Google DeepMind a officiellement présenté Gemini 4 Hydrogen le 12 novembre 2026, positionnant le modèle comme un système économique et à haut débit pour l'ingénierie logicielle quotidienne et les flux de travail agentiques multi-étapes, comme détaillé dans l'annonce officielle de Google DeepMind. Alors que les équipes logicielles déploient de plus en plus d'agents autonomes pour parcourir les dépôts et exécuter des tests, s'appuyer exclusivement sur de grands modèles de raisonnement frontaliers engendre une latence notable et des dépenses d'API cumulatives. Si le raisonnement architectural profond reste essentiel pour la conception de systèmes complexes, les tâches d'ingénierie de routine telles que l'écriture de modifications localisées, l'exécution de batteries de tests et l'analyse de journaux de compilation nécessitent une exécution rapide. Hydrogen est conçu pour servir à la fois d'outil autonome pour le développement à haut volume et de moteur d'exécution associé à des modèles frontaliers dans des pipelines de routage multi-modèle.
Réalignement sectoriel fondamental : Google dévoile Gemini 4 Hydrogen pour les flux de travail à haut débit
En un coup d'œil
- Google DeepMind a introduit Gemini 4 Hydrogen en tant que modèle à haut débit conçu pour gérer le codage de routine, les questions-réponses sur les dépôts et les flux de travail agentiques avec une latence inférieure à celle des niveaux frontaliers.
- Le modèle fonctionne au sein d'une fenêtre de contexte unifiée de 1 048 576 jetons partagée entre les entrées et les sorties, avec une tarification fixée à 1,50 $ par million de jetons d'entrée et 7,50 $ par million de jetons de sortie.
- La disponibilité s'étend à Google AI Studio, l'API Gemini, Android Studio, Google Search et aux plateformes d'entreprise, avec des niveaux d'accès variant entre les offres grand public gratuites et les espaces de travail développeur payants.
Les exigences opérationnelles des flux de travail en ingénierie logicielle ont évolué au-delà de la simple complétion de code par invite unique. Les configurations agentiques modernes déclenchent souvent des dizaines d'étapes autonomes, incluant la lecture de structures de répertoires, l'inspection d'arbres de dépendances, la proposition de correctifs et l'exécution de tests de régression. Lorsque les développeurs acheminent chaque action de routine via des modèles de raisonnement frontaliers, l'exécution des tâches ralentit considérablement. Dans les environnements isochrones et itératifs, même une latence modérée sur les appels d'outils individuels peut s'accumuler en retards importants tout au long des cycles de développement automatisés.
Les discussions du secteur entourant ce lancement reflètent une prise de conscience croissante de l'importance de la spécialisation des modèles pour l'évolutivité en production. Plutôt que de traiter un modèle généraliste unique comme le choix par défaut pour chaque tâche de développement, les équipes évaluent des architectures hiérarchisées. Dans ces configurations, les modèles de raisonnement à haute capacité gèrent la conception du système et le cadrage de problèmes ambigus, tandis que les modèles d'exécution dédiés prennent en charge les opérations répétitives sur la base de code. Google a conçu Hydrogen pour répondre à ce niveau opérationnel, offrant une disponibilité immédiate pour les développeurs via des points de terminaison d'API standard et des environnements programmatiques.
Analyse des benchmarks et limites techniques de Gemini 4 Hydrogen
Google décrit Hydrogen comme une adaptation de Gemini 4 Carbon. Cependant, la documentation technique publiée ne divulgue pas de détails internes spécifiques concernant les mécanismes de transfert de poids, l'architecture des tokenizeurs ou les pipelines de distillation. Les évaluations techniques doivent par conséquent se concentrer sur les données de benchmark observables, les limites de contexte documentées et les contraintes opérationnelles rapportées, plutôt que sur des mécanismes internes déduits.
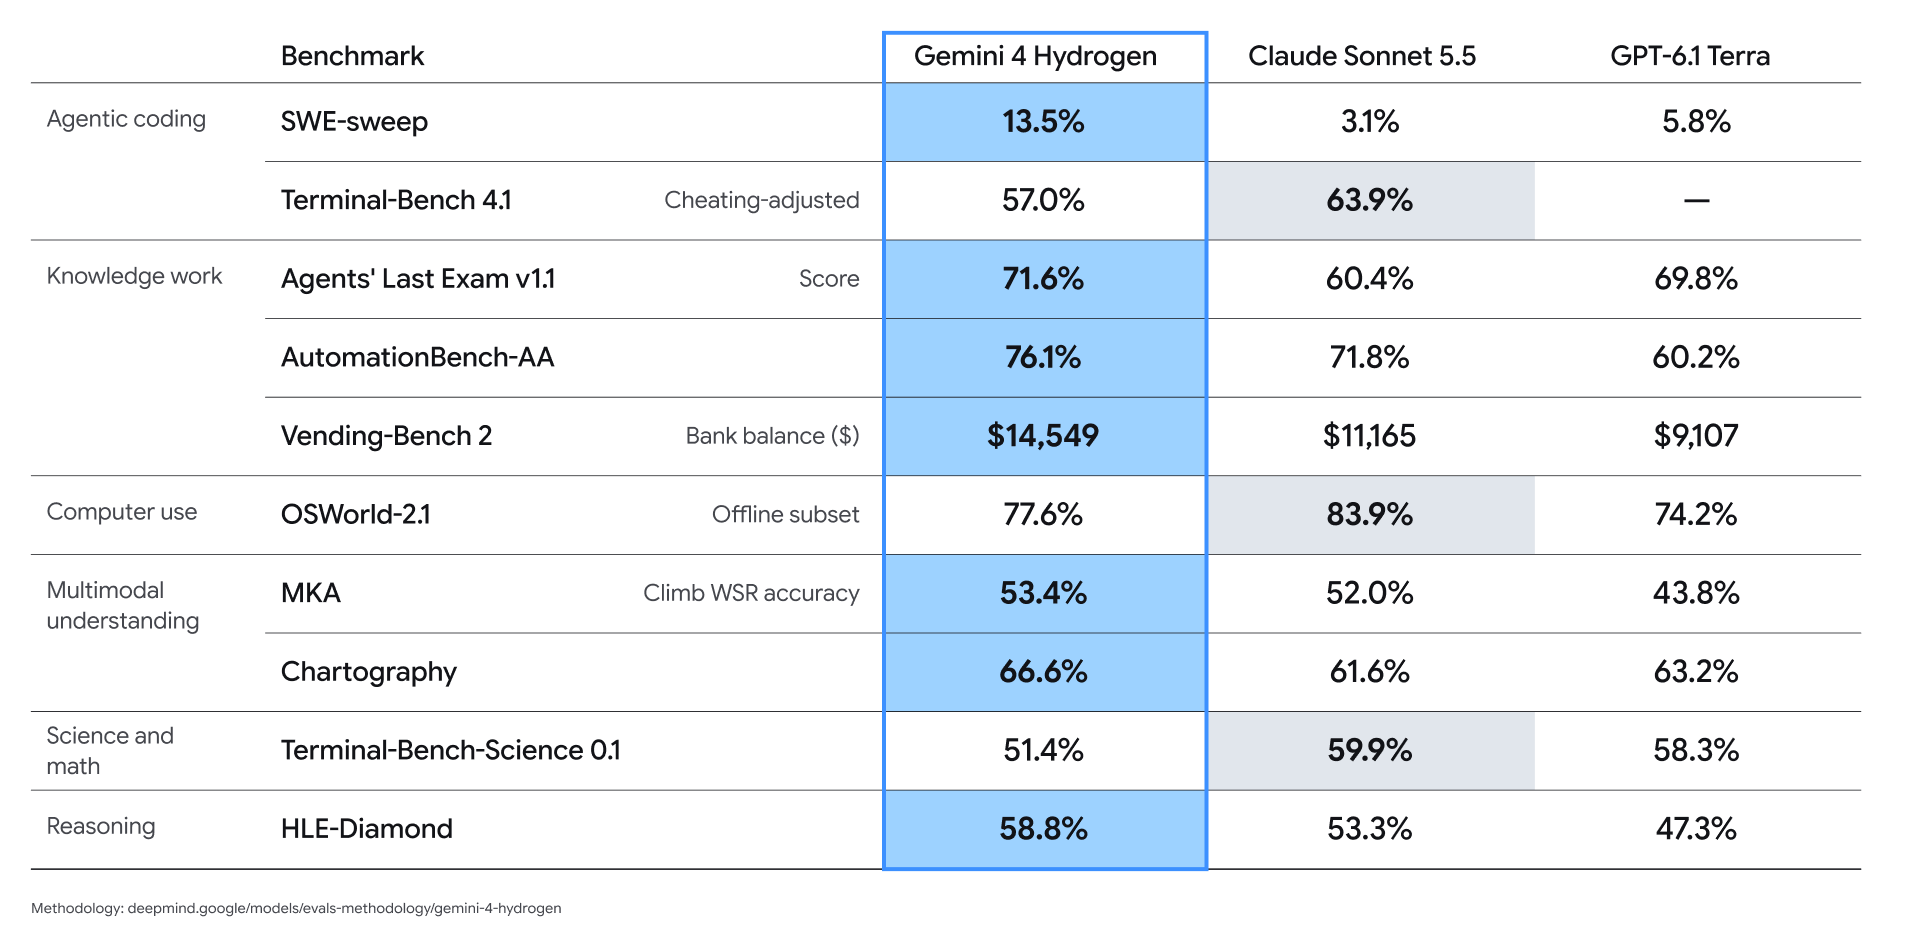
Dans les évaluations standard rapportées dans la fiche technique de Gemini 4 Hydrogen, le modèle démontre des différences de performance nettes selon les catégories de tâches. Sur le benchmark SWE-sweep pour la résolution de problèmes, Google a rapporté un taux de résolution de 13,5 % pour Hydrogen, contre 3,1 % pour Claude Sonnet 5.5 et 5,8 % pour GPT-6.1 Terra dans les conditions d'évaluation spécifiées. Inversement, sur Terminal-Bench 4.1 selon des paramètres ajustés contre la triche, Hydrogen a atteint 57,0 %, ce qui améliore considérablement le score de Gemini 3.8 Flash (18,2 %) mais reste en deçà de Claude Sonnet 5.5, qui a enregistré 63,9 %. Sur l'indice d'intelligence indépendant d'Artificial Analysis, Hydrogen a obtenu un score de 51 avec son paramètre de réflexion élevé par défaut et de 54 avec son paramètre très élevé (xhigh), à comparer aux 50 points du modèle phare Gemini 4 Argon.
Une considération architecturale critique est la capacité de contexte du modèle, telle qu'elle est documentée dans la documentation des modèles Google Cloud. Hydrogen offre un plafond de contexte unifié de 1 048 576 jetons, partagé entre l'ensemble des entrées et des sorties. Cela signifie que des fichiers d'entrée volumineux réduisent la capacité de jetons restante disponible pour les sorties du modèle. Un seul segment de premier plan prend en charge jusqu'à 65 536 jetons de sortie. Les utilisations de génération plus longues s'appuient sur des mécanismes de continuation pris en charge, incluant la continuation gérée par le SDK, une boucle de jetons de continuation personnalisée ou une exécution en arrière-plan gérée par le serveur lorsque cela est possible. Tous les segments restent soumis à la limite de contexte partagée. Les jetons de sortie englobent les jetons de raisonnement internes, les requêtes d'outils générées et le texte visible.
[Multi-Model Orchestrator Architecture in Google Antigravity]
                         ┌────────────────────────┐
                         │  Gemini 4 Carbon/Argon │ (Architectural Planning & Complex Reasoning)
                         └───────────┬────────────┘
                                     │ Task Delegation & Plan Review
                                     ▼
                         ┌────────────────────────┐
                         │   Gemini 4 Hydrogen    │ (Parallel Code Generation & Tool Calling)
                         └───────────┬────────────┘
                                     │ Structured Tool Invocations
                                     ▼
                [ Local Runtime / Test Suites / File System ]
Pour équilibrer la latence et la profondeur analytique, Hydrogen intègre quatre niveaux de raisonnement configurables : bas, moyen, élevé (par défaut) et très élevé (xhigh). Les paramètres inférieurs réduisent la latence de réponse pour les ajustements syntaxiques simples, tandis que les niveaux supérieurs allouent davantage de jetons de raisonnement internes pour évaluer les cas limites. Les développeurs doivent noter que des limitations documentées subsistent : le modèle possède une limite de connaissances fixée à mars 2026, peut connaître des délais d'attente occasionnels lors de traitements lourds en arrière-plan et est susceptible de produire des hallucinations ou des refus excessifs sur des invites ambiguës.
Systèmes découplés et compromis de l'orchestration multi-modèle
L'orchestration multi-modèle permet aux plateformes de développement de répartir les flux de travail d'ingénierie entre différents niveaux de modèles. Selon ce schéma, la modélisation de systèmes complexes et les évaluations de sécurité sont déléguées à des modèles de raisonnement frontaliers, tandis que les modifications de code concrètes et les assertions de test sont assignées à des modèles d'exécution rapides.
Google a évalué cette approche en utilisant l'orchestrateur expérimental dans Google Antigravity. Lors de tests sur Terminal-Bench 4.0, Google a rapporté que la commutation dynamique entre Carbon et Hydrogen permettait d'atteindre des taux de réussite de tâches proches de ceux de Carbon tout en consommant 24 % de quotas en moins et en achevant les tâches 19 % plus rapidement qu'en exécutant Carbon seul. Google a également fait état de premiers tests menés avec des partenaires, montrant une exécution 2× à 2,8× plus rapide et une utilisation des jetons inférieure de 12 % à 23 % par rapport à Gemini 3.8 Flash sur certains flux de travail sélectionnés. Par exemple, Box a rapporté une exécution environ 2× plus rapide et 12 % de jetons en moins sur des tâches complexes impliquant des documents et des tableaux. Ces exemples rapportés par les fournisseurs reflètent des paramètres d'intégration spécifiques et ne constituent pas des estimations contrôlées des économies réalisables sur l'ensemble des déploiements en production.
| Composant système | Outils représentatifs | Responsabilité définie | Portée opérationnelle et limitations |
|---|---|---|---|
| Coordinateur système | Gemini 4 Carbon / Argon | Conception d'architecture de haut niveau, planification inter-dépôts, évaluation de logiques complexes | Capacité de raisonnement élevée ; engendre des coûts par jeton plus élevés et une latence de génération accrue |
| Moteur d'exécution | Gemini 4 Hydrogen | Génération de code localisé, modifications de fichiers automatisées, boucles d'appel d'outils rapides | Débit de génération élevé ; peut fonctionner de manière autonome ou sous la supervision d'un coordinateur |
| Porte de vérification | Batteries de tests unitaires / Analyseurs statiques | Vérification de règles déterministes, validation de syntaxe, tests de régression | Vérifie les assertions définies et les règles statiques ; l'assurance dépend de la qualité des tests, de la couverture et d'une révision indépendante |
L'évaluation d'une architecture multi-modèle exige des équipes d'ingénierie qu'elles équilibrent la complexité du système et l'efficacité d'exécution. Si le routage dynamique des modèles peut réduire les dépenses en jetons sur les tâches répétitives, il introduit une surcharge d'orchestration, des défis de synchronisation d'état entre sous-agents et une dépendance vis-à-vis des classificateurs de routage. Les équipes d'ingénierie doivent mesurer ces compromis par rapport à leur propre distribution de tâches, aux structures de leurs dépôts et à leurs exigences de latence d'API.
Mise en œuvre technique et listes de contrôle pour la gouvernance des flux de travail
L'intégration de Gemini 4 Hydrogen dans des chaînes d'outils de développement automatisées requiert des limites d'exécution claires, une surveillance des jetons et une gouvernance défensive des agents.
Liste de contrôle pour l'implémentation par les développeurs
- Aligner les niveaux de réflexion sur les tâches opérationnelles : Configurez les paramètres d'effort de raisonnement en fonction de la complexité de la charge de travail. Réservez le niveau
xhighpour les cas limites algorithmiques complexes, maintenezhighcomme référence standard pour la navigation dans les dépôts, et utilisezmediumoulowpour les tâches sensibles à la latence telles que le reformatage de code ou la recherche simple de documentation. - Structurer les interfaces d'outils parallèles : Concevez les définitions d'outils de manière à accepter des arguments groupés lorsque l'environnement d'exécution le prend en charge, permettant ainsi aux agents de travail de demander plusieurs inspections de fichiers ou vérifications de syntaxe dans des requêtes consolidées plutôt que par des allers-retours séquentiels.
- Découpler la génération du modèle de son exécution : Veillez à ce que les modèles proposent des invocations d'outils et des modifications de code sous forme de données structurées, tandis qu'un environnement d'exécution client isolé ou un exécuteur de tests conteneurisé exécute les commandes et renvoie les résultats d'exécution ainsi que des preuves reproductibles lorsque cela est possible.
Liste de contrôle pour la gouvernance d'entreprise
- Établir la journalisation des sessions : Enregistrez les demandes d'outils, les résultats d'exécution, les décisions de permission, les modifications de code, les résultats des tests et les résumés de modèles disponibles. Ne considérez pas les résumés de raisonnement comme des traces d'exécution complètes ou fidèles.
- Appliquer des contrôles de sécurité multicouches : Traitez la documentation externe, les gestionnaires de tickets et les commentaires sur les demandes de tirage (pull requests) comme des entrées non fiables. Bien qu'Hydrogen ait démontré une amélioration de sa résilience de 2,3x sur le benchmark d'injection d'invite indirecte Gray Swan, l'aseptisation automatisée des entrées et les portes de permission d'exécution restent nécessaires.
- Surveiller la consommation cumulative de jetons : Suivez les jetons d'entrée et les jetons de sortie facturables, y compris les jetons de réflexion, en utilisant les champs d'utilisation de l'API sélectionnée. N'ajoutez pas à nouveau les jetons de réflexion lorsqu'ils sont déjà inclus dans le total facturé des sorties.
Foire aux questions (FAQ)
Comment Gemini 4 Hydrogen se compare-t-il à Carbon et Argon dans les charges de travail en production ?
Quels sont les quatre niveaux de réflexion et quand les développeurs doivent-ils utiliser le niveau xhigh ?
Comment fonctionne le modèle de tarification forfaitaire sur l'ensemble de la fenêtre de contexte d'un million de jetons ?
Points clés pour les équipes d'ingénierie
Le déploiement d'outils de codage autonomes dans des environnements de production exige des équipes de développement qu'elles regardent au-delà des scores de benchmarks frontaliers pour se concentrer sur l'économie de l'exécution d'outils itératifs. Acheminer chaque modification de code de routine via des modèles de raisonnement à forte latence induit des retards opérationnels superflus et une inflation budgétaire. En parallèle, la gestion de la latence d'exécution et des taux de réussite des tâches nécessite des attentes réalistes concernant les scores des benchmarks et les comportements de récupération d'erreurs.
En établissant des architectures hiérarchisées qui associent des modèles de raisonnement à haute capacité à des moteurs d'exécution rapides et prévisibles, les organisations d'ingénierie peuvent mettre à l'échelle leurs flux de développement automatisés de manière durable. Les équipes qui mettent en œuvre un routage multi-modèle discipliné, des limites de test structurées et une validation rigoureuse des entrées seront les mieux positionnées pour bâtir des pipelines logiciels assistés par l'IA robustes et maintenables.
Références
-
Google DeepMind. Introducing Gemini 4 Hydrogen. Annonce officielle.
-
Google DeepMind. Gemini 4 Hydrogen Model Card. Spécification technique et rapport de sécurité.
-
Google Cloud. Gemini 4 Hydrogen Model Documentation. Référence technique.
-
Google Antigravity. Gemini 4 Hydrogen in Google Antigravity. Aperçu de l'orchestration multi-modèle.
-
Artificial Analysis. Gemini 4 Hydrogen Intelligence and Latency Benchmark. Évaluation indépendante de l'IA.
-
Ars Technica. Google Rolls Out Gemini 4 Hydrogen, Finally Replacing 3.8 Flash. Analyse technique.
Share this article