OpenAI et Google soutiennent-ils le refus partagé d'entraînement à l'IA ? OpenAI, Google et Microsoft ont annoncé le 30 octobre 2026 leur intention de respecter un jeton de politique unique et partagé dans robots.txt, permettant aux gestionnaires de sites d'exprimer leurs préférences en matière d'entraînement de modèles d'IA générative auprès de plusieurs fournisseurs simultanément. Le mécanisme proposé provient d'un Internet-Draft individuel soumis au groupe de travail IETF AI Preferences par Kevin Kelley, ingénieur chez Anthropic. Bien que cette initiative offre aux éditeurs une méthode simplifiée pour déclarer le refus d'entraînement grâce à une syntaxe standard Allow et Disallow, les calendriers de déploiement s'étagent jusqu'en 2027, et chaque grande plateforme prévoit d'interpréter et d'appliquer ce signal différemment selon qu'il s'agit de l'entraînement des modèles ou de l'ancrage conversationnel en temps réel.
Réalignement sectoriel majeur : les principaux laboratoires d'IA se coordonnent sur les standards Robots.txt
En un coup d'œil
- OpenAI, Google et Microsoft ont annoncé le 30 octobre 2026 des plans coordonnés pour reconnaître un jeton de politique robots.txt partagé,
__usage_ai-training, afin de gérer les préférences d'entraînement des modèles génératifs. - Le signal est défini dans un projet Internet-Draft individuel de l'IETF rédigé par Kevin Kelley, ingénieur chez Anthropic, établissant une syntaxe standardisée sans constituer une norme RFC officielle ou finalisée de l'IETF.
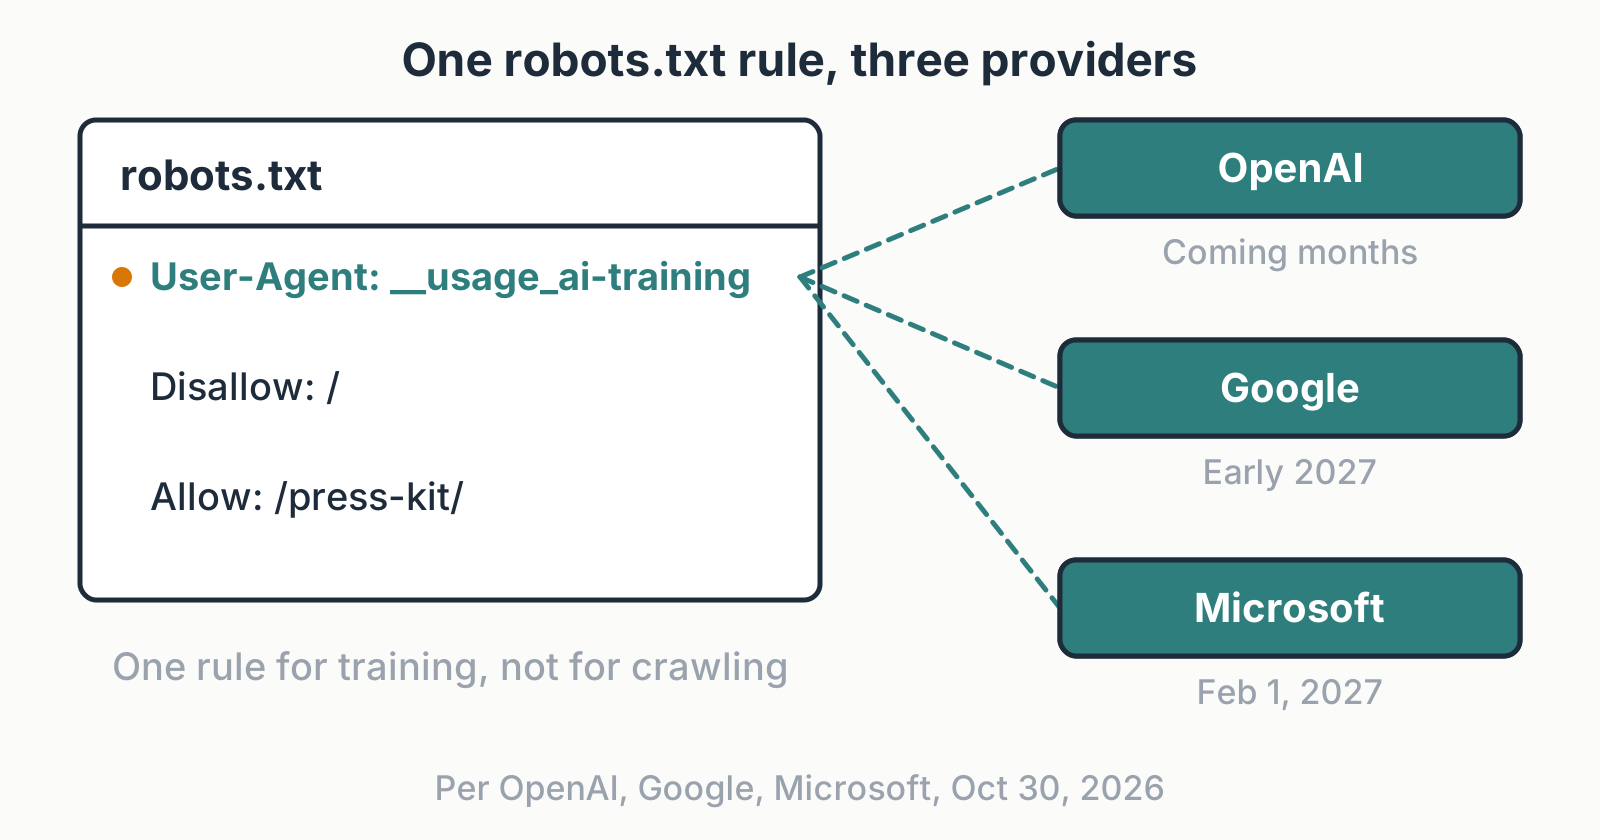
- Les calendriers d'adoption des plateformes divergent considérablement : Anthropic a amorcé des travaux d'ingénierie internes, OpenAI vise un déploiement dans les prochains mois, Microsoft débutera le 1er février 2027 et Google prévoit un support en 2027.
Pendant près de trente ans, le protocole d'exclusion des robots (Robots Exclusion Protocol) a régi les interactions entre les robots d'indexation automatisés et le contenu web public. Les administrateurs de sites web plaçaient un fichier texte simple robots.txt dans leur répertoire racine, définissant quels agents utilisateurs des moteurs de recherche étaient autorisés à récupérer des chemins d'URL spécifiques. Ce protocole reposait sur un accord commercial fondamental : les éditeurs web autorisaient les robots à indexer leur contenu en échange de leur visibilité, d'un trafic référent sortant et d'une exposition de leur marque sur les pages de résultats des moteurs de recherche.
L'essor rapide de l'intelligence artificielle générative a bouleversé ce modèle économique. Les robots de collecte automatisés déployés par les laboratoires d'IA de pointe ont commencé à ingérer des domaines web pour entraîner des modèles de fondation, résumant souvent le contenu original directement dans des interfaces de réponse sans générer de clics de référence pour les éditeurs. Les propriétaires de contenus cherchant à empêcher l'utilisation de leur propriété intellectuelle devaient maintenir des listes fragmentées et complexes d'agents utilisateurs propriétaires, incluant GPTBot, ClaudeBot et Google-Extended. Cette charge administrative augmentait le risque opérationnel d'erreurs de configuration ou de désindexation accidentelle lors de la gestion simultanée de plusieurs directives de robots d'indexation.

L'émergence d'un signal partagé de refus d'entraînement à l'IA marque un changement notable, passant du blocage fragmenté par fournisseur à une gouvernance de protocole coopérative. En coordonnant leur support autour d'un jeton de politique commun, les principaux fournisseurs d'IA visent à abaisser la barrière technique pour les créateurs de contenus souhaitant fixer des limites claires concernant l'entraînement des modèles génératifs. Selon l'annonce officielle de Google Search Central, cette règle unique permet aux administrateurs de sites web de déclarer leur position sur l'entraînement par l'IA générative en une seule étape, plutôt que de suivre et de configurer des directives distinctes pour chaque robot commercial d'IA arrivant sur le marché.
Mécanismes architecturaux sous le capot : comment fonctionne le jeton __usage_ai-training
L'architecture technique sous-tendant le signal de préférence partagé est spécifiée dans l'IETF Internet-Draft sur les signaux de préférence d'entraînement lisibles par machine. Point crucial, ce projet n'introduit pas de nouvelles directives et ne modifie pas la grammaire fondamentale du protocole d'exclusion des robots défini dans la norme RFC 9309. Il réutilise plutôt l'enregistrement standard User-Agent en lui attribuant un jeton de politique réservé : __usage_ai-training.
Pour configurer un refus, un webmestre crée un bloc de règles ordinaire désignant ce jeton de politique comme agent utilisateur, suivi des règles standard Disallow et Allow. L'exemple ci-dessous illustre la manière dont le propriétaire d'un site exprime son refus sur l'ensemble des répertoires du site tout en conservant une exception pour les supports promotionnels publics :
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
La définition sémantique de ce qui constitue un « entraînement à l'IA » s'appuie sur les spécifications de vocabulaire fondamentales du groupe de travail de l'IETF. Dans ce cadre, l'entraînement est défini strictement comme l'utilisation de contenus web collectés pour modifier ou affiner les pondérations et les paramètres appris d'un modèle d'intelligence artificielle générative. Les opérations informatiques non génératives, telles que la classification standard de documents, le classement des index de recherche, la correction orthographique et le filtrage du spam, sont explicitement exclues de cette définition.
Limites du protocole : exploration vs entraînement vs ancrage
Comprendre les limites opérationnelles de ce jeton proposé nécessite de distinguer les différentes étapes de l'ingestion automatisée de données :
[Contenu Web Public]
       │
       ▼
[1. Exploration / Récupération HTTP] ──> Régis par des agents utilisateurs spécifiques (ex. : GPTBot, Bingbot)
       │                    *__usage_ai-training NE RÉGIT PAS le comportement de récupération HTTP*
       ├────────────────────────────────────────┐
       ▼                                        ▼
[2. Utilisation pour l'entraînement]     [3. Ancrage en direct / RAG]
   *__usage_ai-training: Disallow*          *Régis par les balises de page & paramètres fournisseurs*
   Exprime le refus de l'entraînement       Fournit un contexte web en temps réel aux modèles d'IA
       │                                        │
       ▼                                        ▼
   L'application dépend des                 Critères d'éligibilité définis par
   fournisseurs d'IA participants           les politiques de chaque plateforme
Les équipes techniques doivent évaluer quatre limites structurelles inhérentes à cette spécification de projet :
- Le signal régit l'entraînement, et non l'exploration : Le jeton de politique ne constitue pas une directive régissant le comportement d'exploration sur le réseau. Un robot d'IA rencontrant la règle
Disallow: /sous__usage_ai-trainingest toujours autorisé à récupérer le document HTML via HTTP. Il lui est simplement demandé de ne pas injecter ce texte récupéré dans les pipelines d'entraînement des modèles. Pour empêcher un robot de demander l'URL dans son ensemble, les administrateurs doivent continuer de bloquer l'identité spécifique du robot d'indexation. - Les règles avec caractères génériques ne s'appliquent pas : Les blocs de type générique général, tels que
User-Agent: *suivis deDisallow: /, ne correspondent pas au jeton de politique. Le projet stipule que les fournisseurs d'IA participants ne doivent pas interpréter un groupe générique universel comme l'expression d'une préférence d'entraînement pour l'IA. Si un fichier omet le jeton explicite__usage_ai-training, la norme considère que le site n'exprime aucune préférence en matière d'entraînement. - Pas d'effacement rétroactif des modèles : La mise à jour du fichier
robots.txtd'un site web s'applique pour l'avenir. Elle fournit un signal pour les futurs cycles d'exploration et d'entraînement, mais n'oblige pas un laboratoire d'IA à purger des données déjà intégrées dans des jeux de données d'entraînement historiques ni à supprimer des pondérations issues de modèles de fondation préexistants. - Coordination volontaire plutôt qu'application technique : Le signal exprime la préférence d'un éditeur ; il n'assure pas une application technique à l'encontre des consommateurs de données non participants ou non conformes. Selon les principes de la norme RFC 9309, robots.txt demeure un mécanisme consultatif et coopératif plutôt qu'un pare-feu de contrôle d'accès.
Différences d'implémentation entre fournisseurs et calendriers de migration
Bien que Google, Microsoft et OpenAI aient annoncé leur intention de prendre en charge le signal partagé, leurs implémentations techniques et leurs calendriers de déploiement divergent considérablement. Chaque fournisseur aborde l'équilibre entre l'indexation par les moteurs de recherche, l'entraînement des modèles génératifs et la génération augmentée par récupération (RAG) conversationnelle au travers de sa propre infrastructure de produits.
Le tableau ci-dessous met en contraste les engagements confirmés des plateformes, les règles d'interprétation et les calendriers de migration :
| Plateforme | Statut confirmé et calendrier | Interprétation du jeton de politique | Gestion de l'ancrage et de la récupération | Migration des balises héritées et exceptions |
|---|---|---|---|---|
| Support annoncé ; prévu pour 2027 (date exacte à confirmer) | Interprété comme Google-Extended: Disallow lorsqu'aucune règle explicite Google-Extended n'est présente |
Le mappage par défaut affecte l'ancrage dans les applications Gemini ; les règles explicites priment | Les directives Google-Extended existantes restent pleinement valides ; l'indexation de recherche n'est pas affectée |
|
| Microsoft | Engagement confirmé ; prise en compte à partir du 1er février 2027 | Reconnu comme un refus d'entraînement lors de l'exploration du web | Dissocié de l'entraînement ; géré séparément via des balises au niveau de la page | Retrait de NoArchive/NoCache pour l'IA le 1er mars 2027 ; paramètre temporaire dans les Outils Webmaster Bing ouvert le 15 décembre |
| OpenAI | Engagement à mettre en œuvre dans les prochains mois | Support direct dans les pipelines d'ingestion de données | Évalué parallèlement aux directives de GPTBot |
Les configurations GPTBot existantes demeurent actives et applicables |
| Anthropic | Projet rédigé par un employé ; développement signalé sur la liste du groupe de travail | Support prévu sur l'ensemble des services ; calendrier de communication officielle à venir | Évalué parallèlement aux directives de ClaudeBot |
Les contrôles du robot ClaudeBot existants continuent de fonctionner |
Google prévoit d'interpréter un signal partagé de refus d'entraînement à l'IA comme une interdiction Google-Extended en l'absence de règle explicite Google-Extended. Étant donné que Google-Extended régit également l'éligibilité à l'ancrage dans les applications Gemini, ce mappage par défaut peut influencer la disponibilité du contenu d'un éditeur pour ces expériences. Une règle Google-Extended explicite prévaut sur le signal partagé dans l'implémentation de Google, mais les éditeurs ne doivent pas supposer que les contrôles actuels de Google offrent des refus indépendants pour l'entraînement des modèles et pour l'ancrage dans les applications Gemini. Le contenu autorisé sous Google-Extended peut être éligible à l'ancrage Gemini, sans aucune garantie d'inclusion ou de citation.
À l'inverse, Microsoft Bing traite l'entraînement des modèles et l'ancrage en temps réel comme des concepts architecturaux distincts, tel que l'indique la mise à jour officielle des Webmasters Bing
. Microsoft permet aux éditeurs de refuser l'entraînement des modèles génératifs tout en continuant d'autoriser l'ancrage en direct dans les réponses de Copilot. Les sites gérant ces préférences peuvent déclarer des restrictions d'entraînement dansrobots.txt ou via des balises méta HTML au niveau de la page et des en-têtes HTTP, lesquels l'emportent sur robots.txt pour des URL individuelles. L'ancrage est contrôlé via des préférences au niveau de la page, incluant une option DisallowExtended qui autorise l'ancrage dans les propres outils de Microsoft (tels que Copilot) tout en excluant les services tiers propulsés par les API d'ancrage de Microsoft. De plus, Microsoft élimine progressivement son recours historique aux balises NoArchive et NoCache pour les contrôles d'IA ; les sites s'appuyant sur ces balises doivent migrer vers les nouvelles options avant le 1er mars 2027. Le paramètre d'ancrage temporaire des Outils Webmaster Bing n'est disponible que pour les sites utilisant NoArchive ou NoCache au 15 décembre 2026. Il reste effectif jusqu'à ce que Microsoft réexplore la page et découvre la nouvelle préférence, ou jusqu'au 30 septembre 2027, selon la première de ces éventualités.
Check-list pour l'ingénierie : audit des préférences web pour le web agentique
Le déploiement du signal de préférence partagé pour l'entraînement de l'IA requiert une coordination entre l'architecture des systèmes, les opérations de contenu et les équipes de gouvernance juridique. Les responsables techniques doivent s'assurer que les configurations de serveurs reflètent fidèlement les politiques de l'organisation sans perturber par inadvertance la découverte par les moteurs de recherche.
Check-list de mise en œuvre pour les webmestres et les systèmes
- Auditer les manifestes robots actuels : Examiner les fichiers
robots.txtexistants pour répertorier les directives spécifiques aux fournisseurs, en vérifiant si les règles destinées àGPTBot,ClaudeBotouGoogle-Extendedentrent en conflit avec les politiques d'entraînement de l'organisation. - Déployer le jeton de politique réservé : Implémenter le bloc
User-Agent: __usage_ai-trainingpour exprimer les limites globales d'entraînement auprès des fournisseurs d'IA participants selon un format unifié. - Maintenir des chemins d'exception granulaires : Si des ressources publiques (telles que des communiqués de presse, des dossiers de presse ou de la documentation développeur ouverte) sont destinées à la consommation par des modèles, déclarer des exceptions explicites
Allow:sous la directive de refus. - Séparer le blocage de la récupération et la gouvernance de l'entraînement : Si l'objectif principal est de réduire la charge sur le serveur d'origine ou d'empêcher le scraping non autorisé, configurer une limitation de débit par IP, des défis anti-bot sur CDN et des blocages explicites d'agents utilisateurs de robots.
Check-list de gouvernance et de conformité
- Examiner les calendriers de migration de l'ancrage Microsoft : Pour les sites utilisant
NoArchiveouNoCacheafin de contrôler les sorties de Bing Copilot, se préparer à la transition vers les nouvelles balises au niveau de la page avant la date limite d'application fixée par Microsoft au 1er mars 2027. - Évaluer les compromis en matière de visibilité dans la recherche : Pour les plateformes évaluant leur visibilité dans les moteurs de réponse conversationnels, comprendre l'impact des mappages par défaut propres à chaque fournisseur (tels que le repli de Google sur
Google-Extended) sur l'éligibilité à la récupération en temps réel. - Suivre les mises à jour du groupe de travail IETF : Surveiller l'évolution du document
draft-kelley-aipref-training-preference-signalau sein du groupe de travail AIPREF de l'IETF afin d'anticiper d'éventuelles modifications de syntaxe avant son expiration programmée en mai 2027.
Share this article