OpenAI e Google apoiam a desativação compartilhada de treinamento de IA? OpenAI, Google e Microsoft anunciaram planos em 30 de outubro de 2026 para respeitar um único token de política compartilhado no robots.txt, permitindo que operadores de sites expressem preferências de treinamento de modelos de IA generativa em vários provedores simultaneamente. O mecanismo proposto originou-se de um rascunho de rascunho da Internet (Internet-Draft) enviado individualmente ao grupo de trabalho de preferências de IA da IETF pelo engenheiro da Anthropic, Kevin Kelley. Embora a iniciativa ofereça aos editores um método simplificado para declarar a desativação de treinamento usando a sintaxe padrão Allow e Disallow, os cronogramas de implementação permanecem escalonados até 2027, e cada grande plataforma planeja interpretar e aplicar o sinal de maneira diferente no treinamento de modelos e na contextualização conversacional em tempo real.
Realinhamento Central da Indústria: Grandes Laboratórios de IA Coordenam Padrões no Robots.txt
Visão Geral
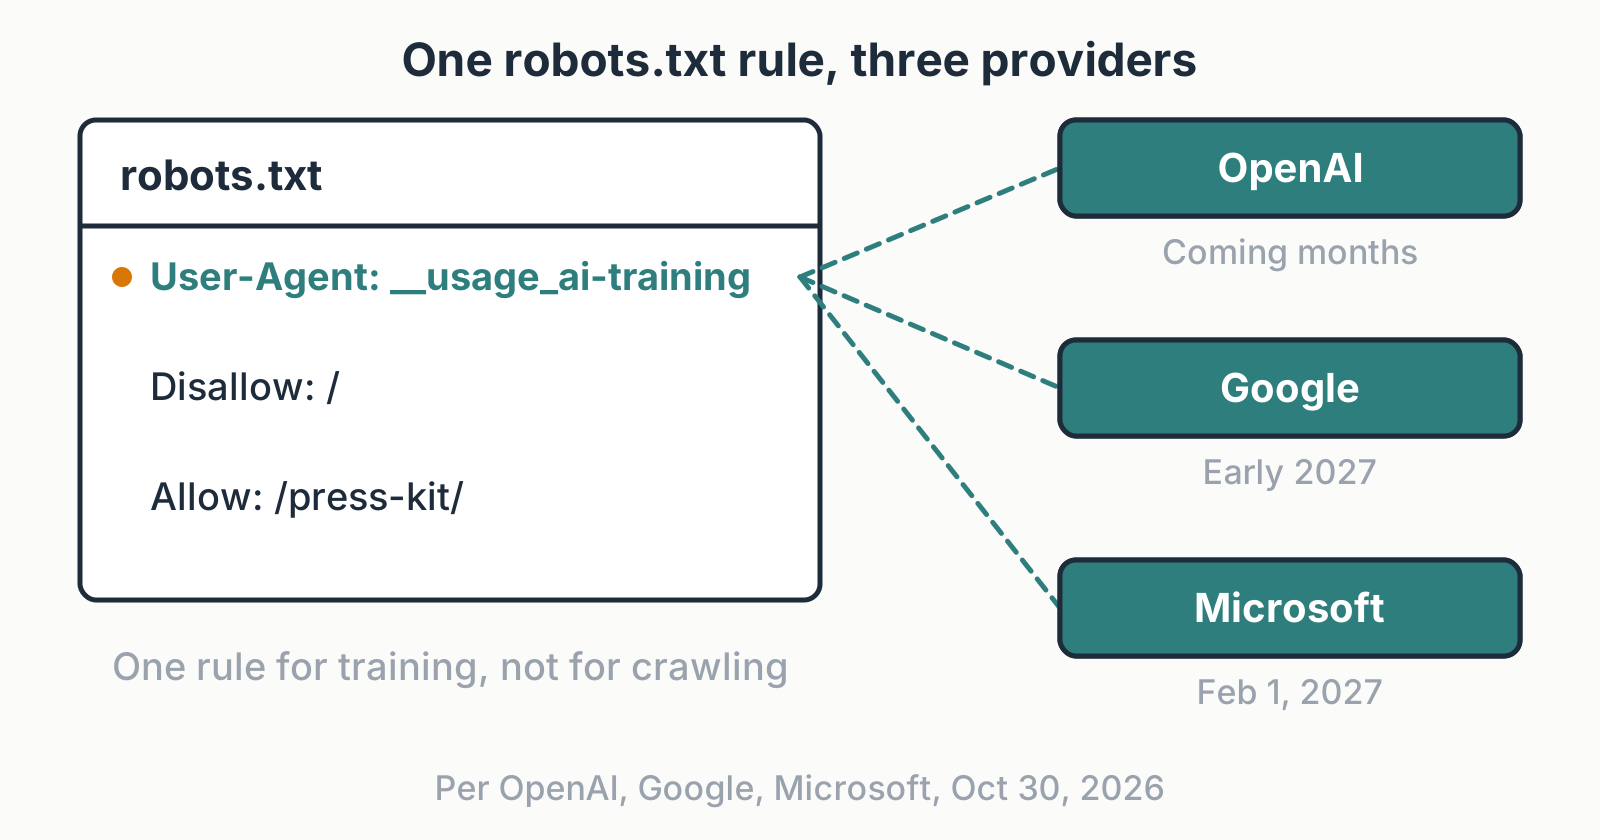
- OpenAI, Google e Microsoft anunciaram planos coordenados em 30 de outubro de 2026 para reconhecer um token de política de robots.txt compartilhado,
__usage_ai-training, para gerenciar preferências de treinamento de modelos generativos. - O sinal está definido em um rascunho de Internet-Draft da IETF de autoria do engenheiro da Anthropic, Kevin Kelley, estabelecendo uma sintaxe padronizada sem representar um padrão RFC oficial ou finalizado da IETF.
- Os cronogramas de adoção de plataformas divergem significativamente: a Anthropic iniciou o trabalho de engenharia interna, a OpenAI visa o lançamento nos próximos meses, a Microsoft começa em 1 de fevereiro de 2027 e o Google projeta suporte para 2027.
Durante quase trinta anos, o Protocolo de Exclusão de Robôs (Robots Exclusion Protocol) regiu como os rastreadores web automatizados interagiam com o conteúdo online público. Administradores de sites colocavam um arquivo de texto simples robots.txt em seu diretório raiz, definindo quais agentes de usuário de mecanismos de busca tinham permissão para buscar caminhos de URL específicos. Esse protocolo operava com base em um acordo comercial fundamental: editores de sites permitiam que os rastreadores indexassem seu conteúdo em troca de descoberta, tráfego de referência de saída e exposição da marca nas páginas de resultados dos mecanismos de busca.
A rápida ascensão da inteligência artificial generativa desestruturou esse modelo econômico. Raspadores automatizados implantados por laboratórios de IA de ponta começaram a ingerir domínios da web para treinar modelos de fundação, frequentemente resumindo o conteúdo original diretamente em interfaces de resposta sem entregar cliques de referência aos editores. Proprietários de conteúdo que buscavam impedir que sua propriedade intelectual fosse ingerida eram forçados a manter listas fragmentadas e complexas de agentes de usuário proprietários, incluindo GPTBot, ClaudeBot e Google-Extended. Essa sobrecarga administrativa aumentou o risco operacional de erros de configuração ou desindexação acidental de buscas ao gerenciar várias diretrizes de rastreadores simultaneamente.

O surgimento de uma desativação compartilhada de treinamento de IA marca uma mudança significativa do bloqueio fragmentado de fornecedores para a governança cooperativa de protocolos. Ao coordenar o suporte em torno de um token de política compartilhado, os principais provedores de IA visam reduzir a barreira técnica para criadores de conteúdo que desejam estabelecer limites claros em relação ao treinamento de modelos generativos. De acordo com o
anúncio oficial do Google Search Central, essa regra única permite que administradores de sites declarem sua postura de treinamento de IA generativa em uma única etapa, em vez de rastrear e configurar diretrizes distintas para cada crawler comercial de IA individual que entra no mercado.
Mecanismos Arquiteturais Internos: Como Funciona o Token __usage_ai-training
A arquitetura técnica por trás do sinal de preferência compartilhado é especificada no Internet-Draft da IETF sobre Sinais de Preferência de Treinamento Legíveis por Máquina. Crucialmente, o rascunho não introduz diretrizes inéditas nem altera a gramática subjacente do Protocolo de Exclusão de Robôs definida na RFC 9309. Em vez disso, ele reutiliza o registro padrão User-Agent atribuindo um token de política reservado: __usage_ai-training.
Para configurar uma desativação, um webmaster cria um bloco de regra comum designando este token de política como o agente de usuário, seguido pelas regras padrão Disallow e Allow. O exemplo abaixo ilustra como o proprietário de um site expressa uma desativação em todos os diretórios do site, mantendo uma exceção para materiais promocionais públicos:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
A definição semântica do que constitui “treinamento de IA” está ancorada nas especificações de vocabulário fundamentais do grupo de trabalho da IETF. Sob essa estrutura, o treinamento é definido estritamente como a utilização de conteúdo web raspado para modificar ou ajustar os pesos e parâmetros aprendidos de um modelo de inteligência artificial generativa. Operações computacionais não generativas, como classificação padrão de documentos, ranqueamento de índices de busca, correção ortográfica e filtragem de spam, são explicitamente excluídas desta definição.
Limites do Protocolo: Rastreamento vs. Treinamento vs. Contextualização
Compreender os limites operacionais deste token proposto exige separar os estágios distintos de ingestão automatizada de dados:
[Conteúdo Web Público]
       │
       ▼
[1. Rastreamento / Busca HTTP] ──> Regido por User-Agents de rastreadores específicos (ex: GPTBot, Bingbot)
       │                    *__usage_ai-training NÃO rege o comportamento de busca HTTP*
       ├────────────────────────────────────────┐
       ▼                                        ▼
[2. Uso em Treinamento de Modelo]        [3. Contextualização ao Vivo / RAG]
   *__usage_ai-training: Disallow*          *Regido por tags de página & configurações do fornecedor*
   Sinaliza preferência contra treinamento  Fornece contexto web em tempo real para modelos de IA
       │                                        │
       ▼                                        ▼
   A aplicação depende dos                  Critérios de elegibilidade definidos por
   provedores de IA participantes           políticas individuais de plataformas
As equipes técnicas devem avaliar quatro limites estruturais inerentes a esta especificação de rascunho:
- O Sinal Rege o Treinamento, Não o Rastreamento: O token de política não é uma diretriz para o comportamento de rastreamento de rede. Um rastreador de IA que encontre
Disallow: /sob__usage_ai-trainingainda tem permissão para buscar o documento HTML via HTTP. Ele é apenas instruído a não alimentar esse texto recuperado nos pipelines de treinamento de modelos. Para impedir que um bot solicite a URL por completo, os administradores devem continuar bloqueando o nome de identidade específico do rastreador. - Regras de Curinga (Wildcard) Não se Aplicam: Blocos gerais com curingas, como
User-Agent: *seguidos porDisallow: /, não correspondem ao token de política. O rascunho determina que os provedores de IA participantes não devem interpretar um grupo de curinga universal como uma expressão de preferência de treinamento de IA. Se um arquivo omitir o token explícito__usage_ai-training, o padrão interpreta que o site não expressa nenhuma preferência de treinamento. - Sem Desaprendizado Retrospectivo de Modelos: Atualizar o arquivo
robots.txtde um site opera voltado para o futuro. Ele fornece um sinal para futuros ciclos de rastreamento e treinamento, mas não obriga um laboratório de IA a purgar dados já integrados em conjuntos de dados de treinamento históricos ou excluir pesos de modelos de fundação pré-existentes. - Coordenação Voluntária em vez de Imposição Técnica: O sinal expressa a preferência do editor; ele não fornece imposição técnica contra consumidores de dados não participantes ou em desconformidade. Sob os princípios da RFC 9309, o robots.txt continua sendo um mecanismo consultivo cooperativo em vez de um firewall de controle de acesso.
Diferenças de Implementação dos Provedores e Cronogramas de Migração
Embora Google, Microsoft e OpenAI tenham anunciado planos para apoiar o sinal compartilhado, suas implementações técnicas e cronogramas de lançamento divergem significativamente. Cada provedor aborda o equilíbrio entre a indexação de mecanismos de busca, o treinamento de modelos generativos e a Geração Aumentada por Recuperação (RAG) conversacional por meio de sua própria infraestrutura de produtos.
A matriz abaixo contrasta os compromissos confirmados de plataforma, as regras de interpretação e os cronogramas de migração:
| Plataforma | Status Confirmado e Cronograma | Interpretação do Token de Política | Tratamento de Contextualização (Grounding) e Recuperação | Migração de Tags Legadas e Exceções |
|---|---|---|---|---|
| Suporte anunciado; planejado para 2027 (data exata a definir) | Interpretado como Google-Extended: Disallow quando nenhuma regra explícita de Google-Extended estiver presente |
O mapeamento padrão afeta a contextualização em Gemini Apps; regras explícitas prevalecem | Diretrizes existentes do Google-Extended permanecem totalmente válidas; indexação de busca inalterada |
|
| Microsoft | Compromisso confirmado; começa a respeitar em 1 de fevereiro de 2027 | Reconhecido como uma desativação de treinamento durante o rastreamento da web | Desacoplado do treinamento; gerenciado separadamente via tags a nível de página | Aposenta NoArchive/NoCache para IA em 1 de março de 2027; configuração temporária no Bing Webmaster Tools aberta em 15 de dez |
| OpenAI | Comprometido com a implementação nos próximos meses | Suporte direto em pipelines de ingestão de dados | Avaliado junto com diretrizes do GPTBot |
Configurações existentes do GPTBot permanecem ativas e aplicáveis |
| Anthropic | Rascunho de autoria de funcionário; desenvolvimento relatado na lista do grupo de trabalho | Suporte pretendido em todos os serviços; cronograma formal de imprensa a definir | Avaliado junto com diretrizes do ClaudeBot |
Controles de rastreador existentes do ClaudeBot continuam operando |
O Google planeja interpretar uma desativação compartilhada de treinamento de IA como uma proibição (disallow) do Google-Extended quando nenhuma regra explícita do Google-Extended estiver presente. Como o Google-Extended também rege a elegibilidade para contextualização (grounding) em Gemini Apps, esse mapeamento padrão pode afetar se o conteúdo de um editor está disponível para essas experiências. Uma regra explícita do Google-Extended tem precedência sobre o sinal compartilhado na implementação do Google, mas os editores não devem assumir que os controles atuais do Google oferecem desativações independentes para treinamento de modelos e contextualização em Gemini Apps. O conteúdo permitido sob o Google-Extended pode ser elegível para contextualização no Gemini, sem nenhuma garantia de inclusão ou citação.
Em contrapartida, o Microsoft Bing trata o treinamento de modelos e a contextualização em tempo real como conceitos arquiteturais distintos, conforme detalhado na atualização oficial do Bing Webmaster. A Microsoft permite que os editores optem por não participar do treinamento de modelos generativos enquanto continuam a permitir a contextualização ao vivo nas respostas do Copilot. Os sites que gerenciam essas preferências podem declarar restrições de treinamento no robots.txt ou por meio de meta tags HTML a nível de página e cabeçalhos HTTP, que substituem o robots.txt para URLs individuais. A contextualização é controlada por meio de preferências a nível de página, incluindo uma opção DisallowExtended que permite a contextualização nas ferramentas da própria Microsoft (como o Copilot), excluindo serviços de terceiros alimentados pelas APIs de contextualização da Microsoft. Além disso, a Microsoft está eliminando gradualmente sua dependência histórica de tags NoArchive e NoCache para controles de IA; sites que dependem dessas tags devem migrar para as novas opções antes de 1 de março de 2027. A configuração temporária de contextualização do Bing Webmaster Tools está disponível apenas para sites que usam NoArchive ou NoCache a partir de 15 de dezembro de 2026. Ela permanece efetiva até que a Microsoft processe um novo rastreamento da página e descubra a nova preferência, ou até 30 de setembro de 2027, o que ocorrer primeiro.
Checklist de Engenharia: Auditoria de Preferências Web para a Web Agêntica
A implantação do sinal de preferência de treinamento de IA compartilhado requer coordenação entre a arquitetura de sistemas, operações de conteúdo e equipes de governança jurídica. Os líderes de engenharia devem garantir que as configurações do servidor reflitam com precisão as políticas organizacionais sem interromper acidentalmente a descoberta por mecanismos de busca.
Checklist de Implementação para Webmasters e Sistemas
- Auditar Manifestos Robots Atuais: Revisar arquivos
robots.txtexistentes para catalogar diretrizes específicas de fornecedores, verificando se as regras paraGPTBot,ClaudeBotouGoogle-Extendedentram em conflito com as políticas de treinamento organizacionais. - Implantar o Token de Política Reservado: Implementar o bloco
User-Agent: __usage_ai-trainingpara expressar limites globais de treinamento em provedores de IA participantes em um formato unificado. - Manter Caminhos de Exceção Granulares: Se ativos públicos — como comunicados à imprensa, kits de mídia ou documentação de desenvolvedor aberta — forem destinados ao consumo por modelos, declare exceções explícitas
Allow:abaixo da diretriz de proibição (disallow). - Separar o Bloqueio de Busca da Governança de Treinamento: Se o objetivo principal for reduzir a carga no servidor de origem ou impedir a raspagem não autorizada, configure limitação de taxa baseada em IP (rate limiting), desafios de bot de CDN e bloqueios explícitos de agentes de usuário de rastreadores.
Checklist de Governança e Conformidade
- Revisar os Cronogramas de Migração de Contextualização da Microsoft: Para sites que utilizam
NoArchiveouNoCachepara controlar a saída do Bing Copilot, prepare-se para fazer a transição para as novas tags a nível de página antes do prazo de aplicação da Microsoft em 1 de março de 2027. - Avaliar as Compensações de Descoberta em Buscas: Para plataformas que avaliam a visibilidade em mecanismos de resposta conversacionais, reconheça como os mapeamentos padrão específicos de fornecedores (como o fallback do Google para
Google-Extended) afetam a elegibilidade de recuperação em tempo real. - Acompanhar as Atualizações do Grupo de Trabalho da IETF: Monitore a progressão de
draft-kelley-aipref-training-preference-signaldentro do grupo de trabalho IETF AIPREF para contabilizar potenciais atualizações de sintaxe antes de sua expiração programada em maio de 2027.
Share this article