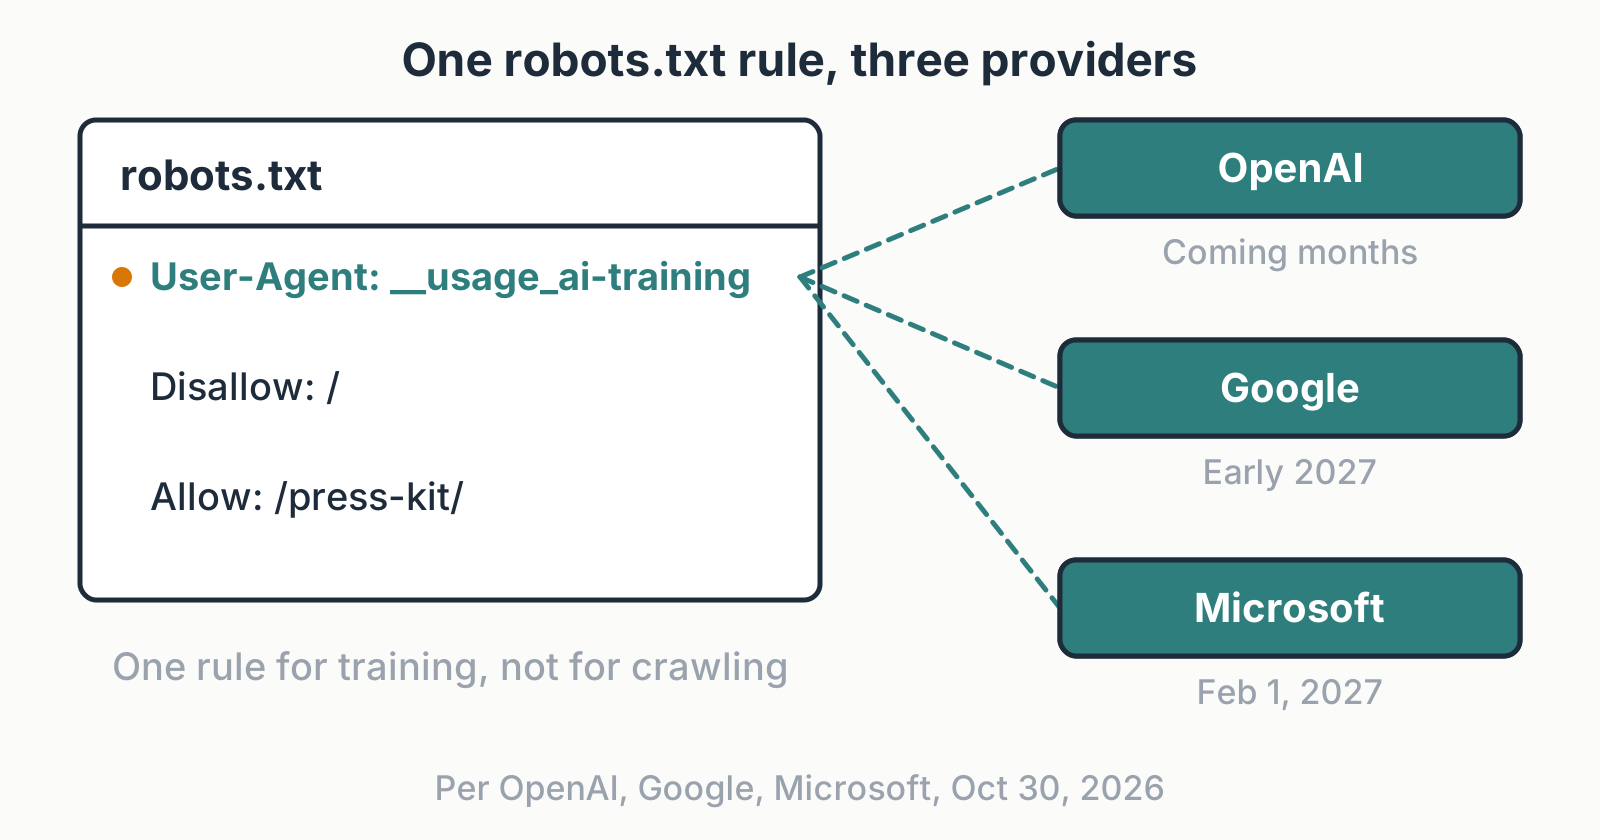
OpenAI и Google поддержали общий отказ от обучения ИИ? OpenAI, Google и Microsoft объявили 30 октября 2026 года о планах соблюдать единый общий токен политики в файле robots.txt, который позволяет владельцам сайтов одновременно выражать предпочтения в отношении обучения генеративных ИИ-моделей у нескольких провайдеров. Предложенный механизм происходит из индивидуального интернет-черновика (Internet-Draft), представленного рабочей группе IETF по ИИ-предпочтениям инженером Anthropic Кевином Келли (Kevin Kelley). Хотя инициатива предоставляет издателям удобный метод для заявления об отказе от обучения с использованием стандартного синтаксиса Allow и Disallow, сроки внедрения растянутся на 2027 год, и каждая крупная платформа планирует интерпретировать и применять этот сигнал по-своему как в обучении моделей, так и в контексте живого разговорного поиска (grounding).
Основная перестройка индустрии: ключевые ИИ-лаборатории согласовывают стандарты Robots.txt
Краткий обзор
- OpenAI, Google и Microsoft 30 октября 2026 года объявили о скоординированных планах признать общий токен политики robots.txt —
__usage_ai-training— для управления предпочтениями в обучении генеративных моделей. - Сигнал определен в индивидуальном интернет-черновике IETF, автоником которого является инженер Anthropic Кевин Келли; он устанавливает стандартизированный синтаксис, не являясь при этом официальным или окончательным стандартом RFC IETF.
- Графики внедрения платформами существенно различаются: компания Anthropic уже начала внутренние инженерные работы, OpenAI планирует запуск в ближайшие месяцы, Microsoft начинает поддержку 1 февраля 2027 года, а Google прогнозирует ее в 2027 году.
Почти тридцать лет Протокол исключения роботов (Robots Exclusion Protocol) регулировал взаимодействие автоматизированных веб-краулеров с общедоступным онлайн-контентом. Администраторы сайтов размещали простой текстовый файл robots.txt в корневом каталоге, определяя, какие пользовательские агенты поисковых систем имеют разрешение на запросы определенных путей URL. Этот протокол работал на основе фундаментальной коммерческой сделки: издатели сайтов разрешали краулерам индексировать свой контент в обмен на видимость, входящий реферальный трафик и присутствие бренда на страницах результатов поисковой выдачи.
Стремительный рост генеративного искусственного интеллекта нарушил эту экономическую модель. Автоматизированные парсерки, развернутые ведущими ИИ-лабораториями, начали сканировать веб-домены для обучения базовых моделей, часто суммируя оригинальный контент прямо в интерфейсах ответов без передачи реферальных кликов издателям. Владельцы контента, стремившиеся защитить свою интеллектуальную собственность от сбора, были вынуждены поддерживать фрагментированные, сложные списки проприетарных ботов, включая GPTBot, ClaudeBot и Google-Extended. Эта административная нагрузка увеличивала операционный риск возникновения ошибок конфигурации или случайного исключения из поисковой индексации при одновременном управлении множеством директив краулеров.

Появление общего сигнала отказа от обучения ИИ знаменует собой значительный сдвиг от фрагментированной блокировки вендоров к совместному управлению протоколами. Координируя поддержку вокруг общего токена политики, основные ИИ-провайдеры стремятся снизить технический барьер для создателей контента, которые хотят установить четкие границы в отношении обучения генеративных моделей. Согласно официальному анонсу Google Search Central, это единственное правило позволяет администраторам сайтов заявить о своей позиции в отношении обучения генеративного ИИ в один шаг, вместо того чтобы отслеживать и настраивать отдельные директивы для каждого отдельного коммерческого ИИ-краулера на рынке.
Внутренняя архитектурная механика: как работает токен __usage_ai-training
Техническая архитектура общего сигнала предпочтений описана в интернет-черновике IETF по машинно-читаемым сигналам предпочтений в обучении. Что важно, черновик не вводит новые директивы и не меняет базовую грамматику Протокола исключения роботов, определенную в RFC 9309. Вместо этого он повторно использует стандартную запись User-Agent, назначая зарезервированный токен политики: __usage_ai-training.
Чтобы настроить отказ, веб-мастер создает обычный блок правил, указывающий этот токен политики в качестве пользовательского агента, с последующими стандартными правилами Disallow и Allow. Пример ниже иллюстрирует, как владелец сайта оформляет отказ для всех каталогов сайта, сохраняя при этом исключение для общедоступных рекламных материалов:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Семантическое определение того, что представляет собой «обучение ИИ», закреплено в базовых спецификациях словаря рабочей группы IETF. В рамках этой структуры обучение определяется строго как использование собранного веб-контента для изменения или настройки изученных весов и параметров модели генеративного искусственного интеллекта. Негенеративные вычислительные операции, такие как стандартная классификация документов, ранжирование поискового индекса, исправление орфографии и фильтрация спама, явно исключаются из этого определения.
Границы протокола: сканирование (crawling) против обучения (training) и контекстного поиска (grounding)
Понимание операционных пределов этого предложенного токена требует разделения различных этапов автоматизированного сбора данных:
[Публичный веб-контент]
       │
       ▼
[1. HTTP-краулинг / Запрос] ──> Регулируется конкретными пользовательскими агентами краулеров (например, GPTBot, Bingbot)
       │                    *__usage_ai-training НЕ регулирует поведение HTTP-запросов*
       ├────────────────────────────────────────┐
       ▼                                        ▼
[2. Использование для обучения моделей]     [3. Живой поиск / RAG]
   *__usage_ai-training: Disallow*          *Регулируется тегами страниц и настройками вендоров*
   Сигнализирует об отказе от обучения      Предоставляет веб-контекст в реальном времени для ИИ-моделей
       │                                        │
       ▼                                        ▼
   Применение зависит от                    Критерии соответствия задаются
   участвующих ИИ-провайдеров               политиками конкретной платформы
Технические команды должны оценить четыре структурные границы, присущие данной спецификации черновика:
- Сигнал управляет обучением, а не краулингом: Токен политики не является директивой для поведения сетевых роботов. ИИ-краулер, столкнувшийся с правилом
Disallow: /под__usage_ai-training, все еще имеет разрешение на загрузку HTML-документа по протоколу HTTP. Ему просто дается указание не передавать этот извлеченный текст в конвейеры обучения моделей. Чтобы бот вообще не запрашивал URL-адрес, администраторам по-прежнему необходимо блокировать конкретное имя пользователя бота. - Правила с подставочными знаками (wildcard) не применяются: Общие правила с подставочными знаками, такие как
User-Agent: *с последующимDisallow: /, не соответствуют этому токену политики. Черновик требует, чтобы участвующие ИИ-провайдеры не интерпретировали универсальную группу с подставочными знаками как выражение предпочтений в отношении обучения ИИ. Если в файле опущен явный токен__usage_ai-training, стандарт интерпретирует сайт как не выражающий никаких предпочтений относительно обучения. - Отсутствие ретроспективного «забывания» моделью: Обновление файла
robots.txtсайта работает в направлении будущего. Оно предоставляет сигнал для будущих циклов сканирования и обучения, но не заставляет ИИ-лабораторию удалять данные, уже интегрированные в исторические наборы данных для обучения, или стирать веса из уже существующих базовых моделей. - Добровольная координация вместо технического принуждения: Сигнал выражает предпочтение издателя; он не обеспечивает техническое принуждение в отношении неучаствующих или несоблюдающих правила потребителей данных. Согласно принципам RFC 9309, robots.txt остается механизмом доброжелательного консультирования, а не брандмауэром контроля доступа.
Различия в реализации провайдерами и графики миграции
Хотя Google, Microsoft и OpenAI объявили о планах поддержки общего сигнала, их технические реализации и графики развертывания существенно различаются. Каждый провайдер подходит к балансу между индексированием поисковых систем, обучением генеративных моделей и генерацией с дополненной выборкой (RAG) через собственную продуктовую инфраструктуру.
В приведенной ниже таблице сопоставлены подтвержденные обязательства платформ, правила интерпретации и графики миграции:
| Платформа | Подтвержденный статус и сроки | Интерпретация токена политики | Обработка поиска (grounding) и извлечения | Миграция устаревших тегов и исключения |
|---|---|---|---|---|
| Поддержка анонсирована; запланировано на 2027 год (точная дата уточняется) | Интерпретируется как Google-Extended: Disallow при отсутствии явного правила Google-Extended |
Сопоставление по умолчанию влияет на поиск в приложениях Gemini; явные правила имеют приоритет | Существующие директивы Google-Extended остаются полностью действительными; поисковая индексация не затронута |
|
| Microsoft | Подтвержденные обязательства; начинает учитываться с 1 февраля 2027 года | Распознается как отказ от обучения при веб-краулинге | Отделено от обучения; управляется отдельно с помощью тегов на уровне страниц | Прекращает поддержку NoArchive / NoCache для ИИ 1 марта 2027 года; временная настройка Bing Webmaster Tools открывается 15 декабря |
| OpenAI | Взяты обязательства по внедрению в ближайшие месяцы | Прямая поддержка в конвейерах сбора данных | Оценивается наряду с директивами GPTBot |
Существующие конфигурации GPTBot остаются активными и применимыми |
| Anthropic | Черновик создан сотрудником компании; о разработке сообщалось в рассылке рабочей группы | Планируемая поддержка в сервисах; официальные сроки пресс-службы уточняются | Оценивается наряду с директивами ClaudeBot |
Существующие элементы управления краулером ClaudeBot продолжают работу |
Google планирует интерпретировать общий отказ от обучения ИИ как запрет Google-Extended, если явное правило Google-Extended отсутствует. Поскольку Google-Extended также определяет право на использование контента для поиска в приложениях Gemini, это отображение по умолчанию может повлиять на то, доступен ли контент издателя для таких функций. Явное правило Google-Extended имеет приоритет над общим сигналом в реализации Google, однако издателям не стоит рассчитывать на то, что текущие инструменты Google обеспечивают независимый отказ от обучения моделей и поиска для Gemini. Контент, разрешенный в рамках Google-Extended, может быть допущен к поиску Gemini без каких-либо гарантий включения или цитирования.
В отличие от этого, Microsoft Bing рассматривает обучение моделей и контекстный поиск в реальном времени как различные архитектурные концепции, что подробно описано в официальном обновлении Bing Webmaster. Microsoft позволяет издателям отказаться от обучения генеративных моделей, продолжая разрешать живой поиск в ответах Copilot. Сайты, управляющие этими настройками, могут заявлять об ограничениях на обучение в файле robots.txt либо с помощью HTML метатегов на уровне страницы и HTTP-заголовков, которые имеют приоритет над robots.txt для отдельных URL-адресов. Поиск контролируется с помощью настроек на уровне страницы, включая опцию DisallowExtended, которая разрешает поиск в собственных инструментах Microsoft (таких как Copilot), исключая при этом сторонние сервисы, работающие на базе API поиска Microsoft. Более того, Microsoft постепенно отказывается от исторической зависимости от тегов NoArchive и NoCache для управления ИИ; сайты, использующие эти теги, должны перейти на новые варианты до 1 марта 2027 года. Временная настройка поиска в Bing Webmaster Tools доступна только сайтам, использующим NoArchive или NoCache по состоянию на 15 декабря 2026 года. Она остается эффективной до тех пор, пока Microsoft не выполнит повторное сканирование страницы и не обнаружит новую настройку, либо до 30 сентября 2027 года (в зависимости от того, что наступит раньше).
Инженерный контрольный список: аудит веб-настроек для эпохи агентов
Развертывание общего сигнала предпочтений в обучении ИИ требует координации между системной архитектурой, операциями с контентом и командами юридического соответствия. Руководители инженерных отделов должны убедиться, что конфигурации серверов точно отражают политику организации, не нарушая при этом поисковую индексацию.
Контрольный список для веб-мастеров и системных администраторов
- Аудит текущих манифестов Robots: проверьте существующие файлы
robots.txtдля каталогизации специфичных для вендоров директив, проверив, не противоречат ли правила дляGPTBot,ClaudeBotилиGoogle-Extendedполитике организации в отношении обучения. - Развертывание зарезервированного токена политики: внедрите блок
User-Agent: __usage_ai-training, чтобы задать глобальные границы обучения для участвующих ИИ-провайдеров в унифицированном формате. - Поддержка детализированных путей-исключений: если общедоступные ресурсы — такие как пресс-релизы, медиа-киты или открытая документация разработчиков — предназначены для использования моделями, объявите явные исключения
Allow:ниже директивы запрета. - Отделение блокировки запросов от управления обучением: если основная цель заключается в снижении нагрузки на исходный сервер или предотвращении несанкционированного парсинга, настройте ограничение частоты запросов по IP, вызовы защиты CDN и явные блокировки пользовательских агентов краулеров.
Контрольный список по управлению и соблюдению требований
- Изучение графиков миграции поиска Microsoft: для сайтов, использующих
NoArchiveилиNoCacheдля контроля вывода Bing Copilot, подготовьтесь к переходу на новые теги на уровне страниц до истечения крайнего срока соблюдения требований Microsoft 1 марта 2027 года. - Оценка компромиссов поисковой видимости: для платформ, оценивающих видимость в разговорных поисковых системах, учтите, как сопоставления по умолчанию для конкретных вендоров (такие как откат Google к
Google-Extended) влияют на право участия в поиске в реальном времени. - Отслеживание обновлений рабочей группы IETF: следите за развитием
draft-kelley-aipref-training-preference-signalв рамках рабочей группы IETF AIPREF, чтобы учитывать возможные изменения синтаксиса до его запланированного истечения в мае 2027 года.
Share this article