GitHub запускает Copilot Fusion? 28 октября 2026 года компания GitHub официально объявила о выходе Copilot Fusion в общий доступ, представив маршрутизатор и оркестратор моделей времени выполнения, который координирует работу нескольких моделей искусственного интеллекта для задач разработки программного обеспечения. Система, представленная на ежегодной конференции GitHub Universe в Сан-Франциско, переносит выбор моделей с отдельных разработчиков, позволяя платформе анализировать требования к задаче и динамически распределять работу между различными базовыми моделями. Поскольку команды разработчиков сталкиваются с растущими затратами на API и когнитивной усталостью от постоянного переключения между различными передовыми моделями, автоматическая оркестрация моделей становится стандартным операционным архитектурным паттерном.
Главная перестройка индустрии: GitHub представляет Copilot Fusion на конференции Universe
Краткий обзор
- 28 октября 2026 года компания GitHub выпустила Copilot Fusion в общий доступ для Visual Studio Code, Copilot CLI, сред разработки JetBrains и настольного приложения GitHub Copilot.
- Система объединяет координацию нескольких моделей во время выполнения на базе Project HydraFusion и оптимизированные алгоритмы автоматического выбора моделей.
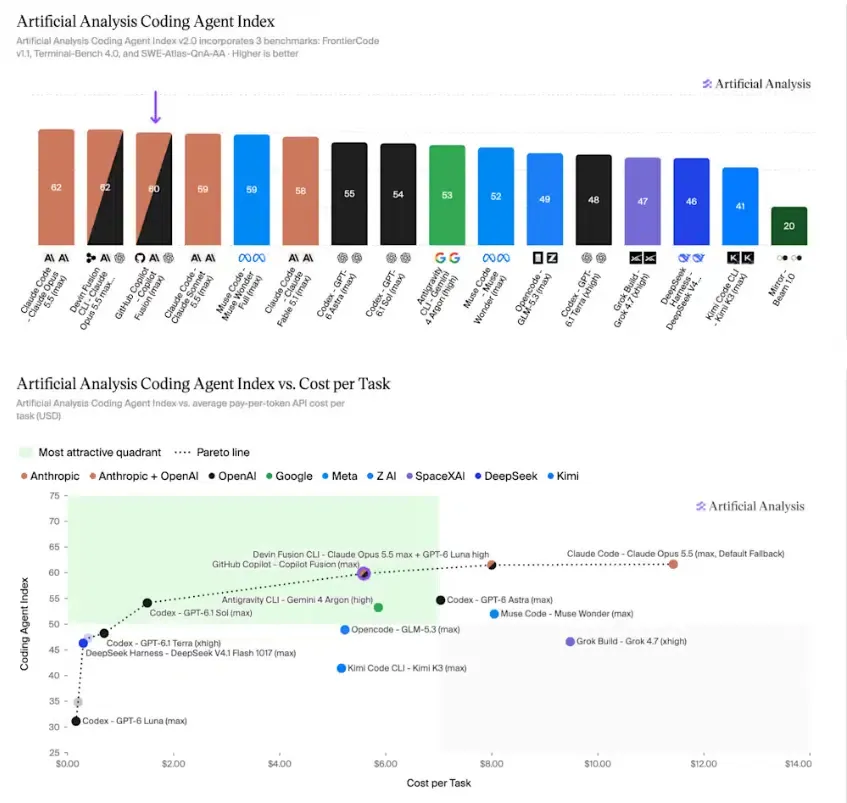
- По результатам независимой оценки Artificial Analysis, решение Fusion Max набрало 60 баллов в индексе Coding Agent Index v2.0, отстав от Claude Code с Opus 5.5 Max всего на два балла и при этом сократив затраты на выполнение задач примерно на 51%.
Команды разработчиков ПО, использующие ИИ-помощников для написания кода, исторически работали в рамках парадигмы ручного выбора. Программисты выбирали одну модель — например, GPT-4o, Claude Sonnet или рассуждающую модель серии o1 — из выпадающего меню в среде разработки и сохраняли этот выбор на протяжении всей сессии кодинга. Хотя такой подход эффективен для изолированных запросов, он влечет за собой операционные компромиссы. Разработчики часто выбирают премиальные передовые модели с высокой задержкой для сложного архитектурного планирования, а затем забывают переключиться обратно на легковесные модели при выполнении повседневных задач, таких как генерация модульных тестов или написание шаблонной документации.
Такой ручной подход может увеличивать корпоративные расходы на API и неэффективно расходовать токены контекста. Чтобы устранить эти недостатки рабочих процессов, компания GitHub разработала Copilot Fusion, о чем сообщается в официальном анонсе GitHub. Вместо того чтобы рассматривать работу с ИИ-кодингом как взаимодействие с одной статической моделью, Fusion функционирует как координатор времени выполнения. Разработчики задают общий уровень детализации рассуждений, а система автономно выбирает наиболее подходящую базовую модель или комбинацию моделей для каждого шага задачи.

Стратегический поворот, отраженный в релизе GitHub Launches Copilot Fusion, сосредоточен на экономике задач, а не на чистом масштабировании параметров. Согласно результатам бенчмарков, опубликованным Artificial Analysis, Copilot Fusion Max, протестированный через Copilot CLI в индексе Coding Agent Index v2.0, выполнял эталонные кодинговые задачи со средней стоимостью $5.59 за задачу, по сравнению с $11.42 для Claude Code под управлением Claude Opus 5.5 от Anthropic на максимальных настройках. Оцениваемая конфигурация потребляла примерно 7,2 миллиона токенов на задачу — примерно вдвое меньше объема токенов автономной конфигурации Opus, — выполняя задачи примерно на 40% быстрее.
Производительность варьировалась в зависимости от отдельных компонентов бенчмарка: Fusion Max лидировал в Terminal-Bench 4.0 с результатом 71 балл, однако набрал 51 балл во FrontierCode (уступив 56 баллам Claude Code) и 57 баллов в SWE-Atlas-QnA-AA. Кроме того, хотя руководство Microsoft ссылалось на внутренние оценки DeepSWE, указывающие на потенциальное сокращение затрат до 77%, эта цифра представляет собой отдельный максимальный сценарий, заявленный компанией, а не средний показатель независимого бенчмарка. Эти результаты подтверждают, что динамическая мультимодельная оркестрация способна существенно снизить расходы на разработку для поддерживаемых рабочих процессов, хотя реальная экономия зависит от конкретного набора задач, требований к проверке и паттернов использования на уровне предприятия.
Архитектурные паттерны: топологии выполнения Single, Cascade и Critique
Copilot Fusion не работает как самостоятельная базовая модель. Вместо этого она функционирует как интеллектуальная плоскость управления, встроенная в клиент разработчика. Когда пользователь отправляет инструкцию, предполагающую рассуждения, генерацию кода, отладку или использование инструментов, Fusion сопоставляет входящие сигналы намерения с состоянием системы в реальном времени, доступностью и семантической сложностью.
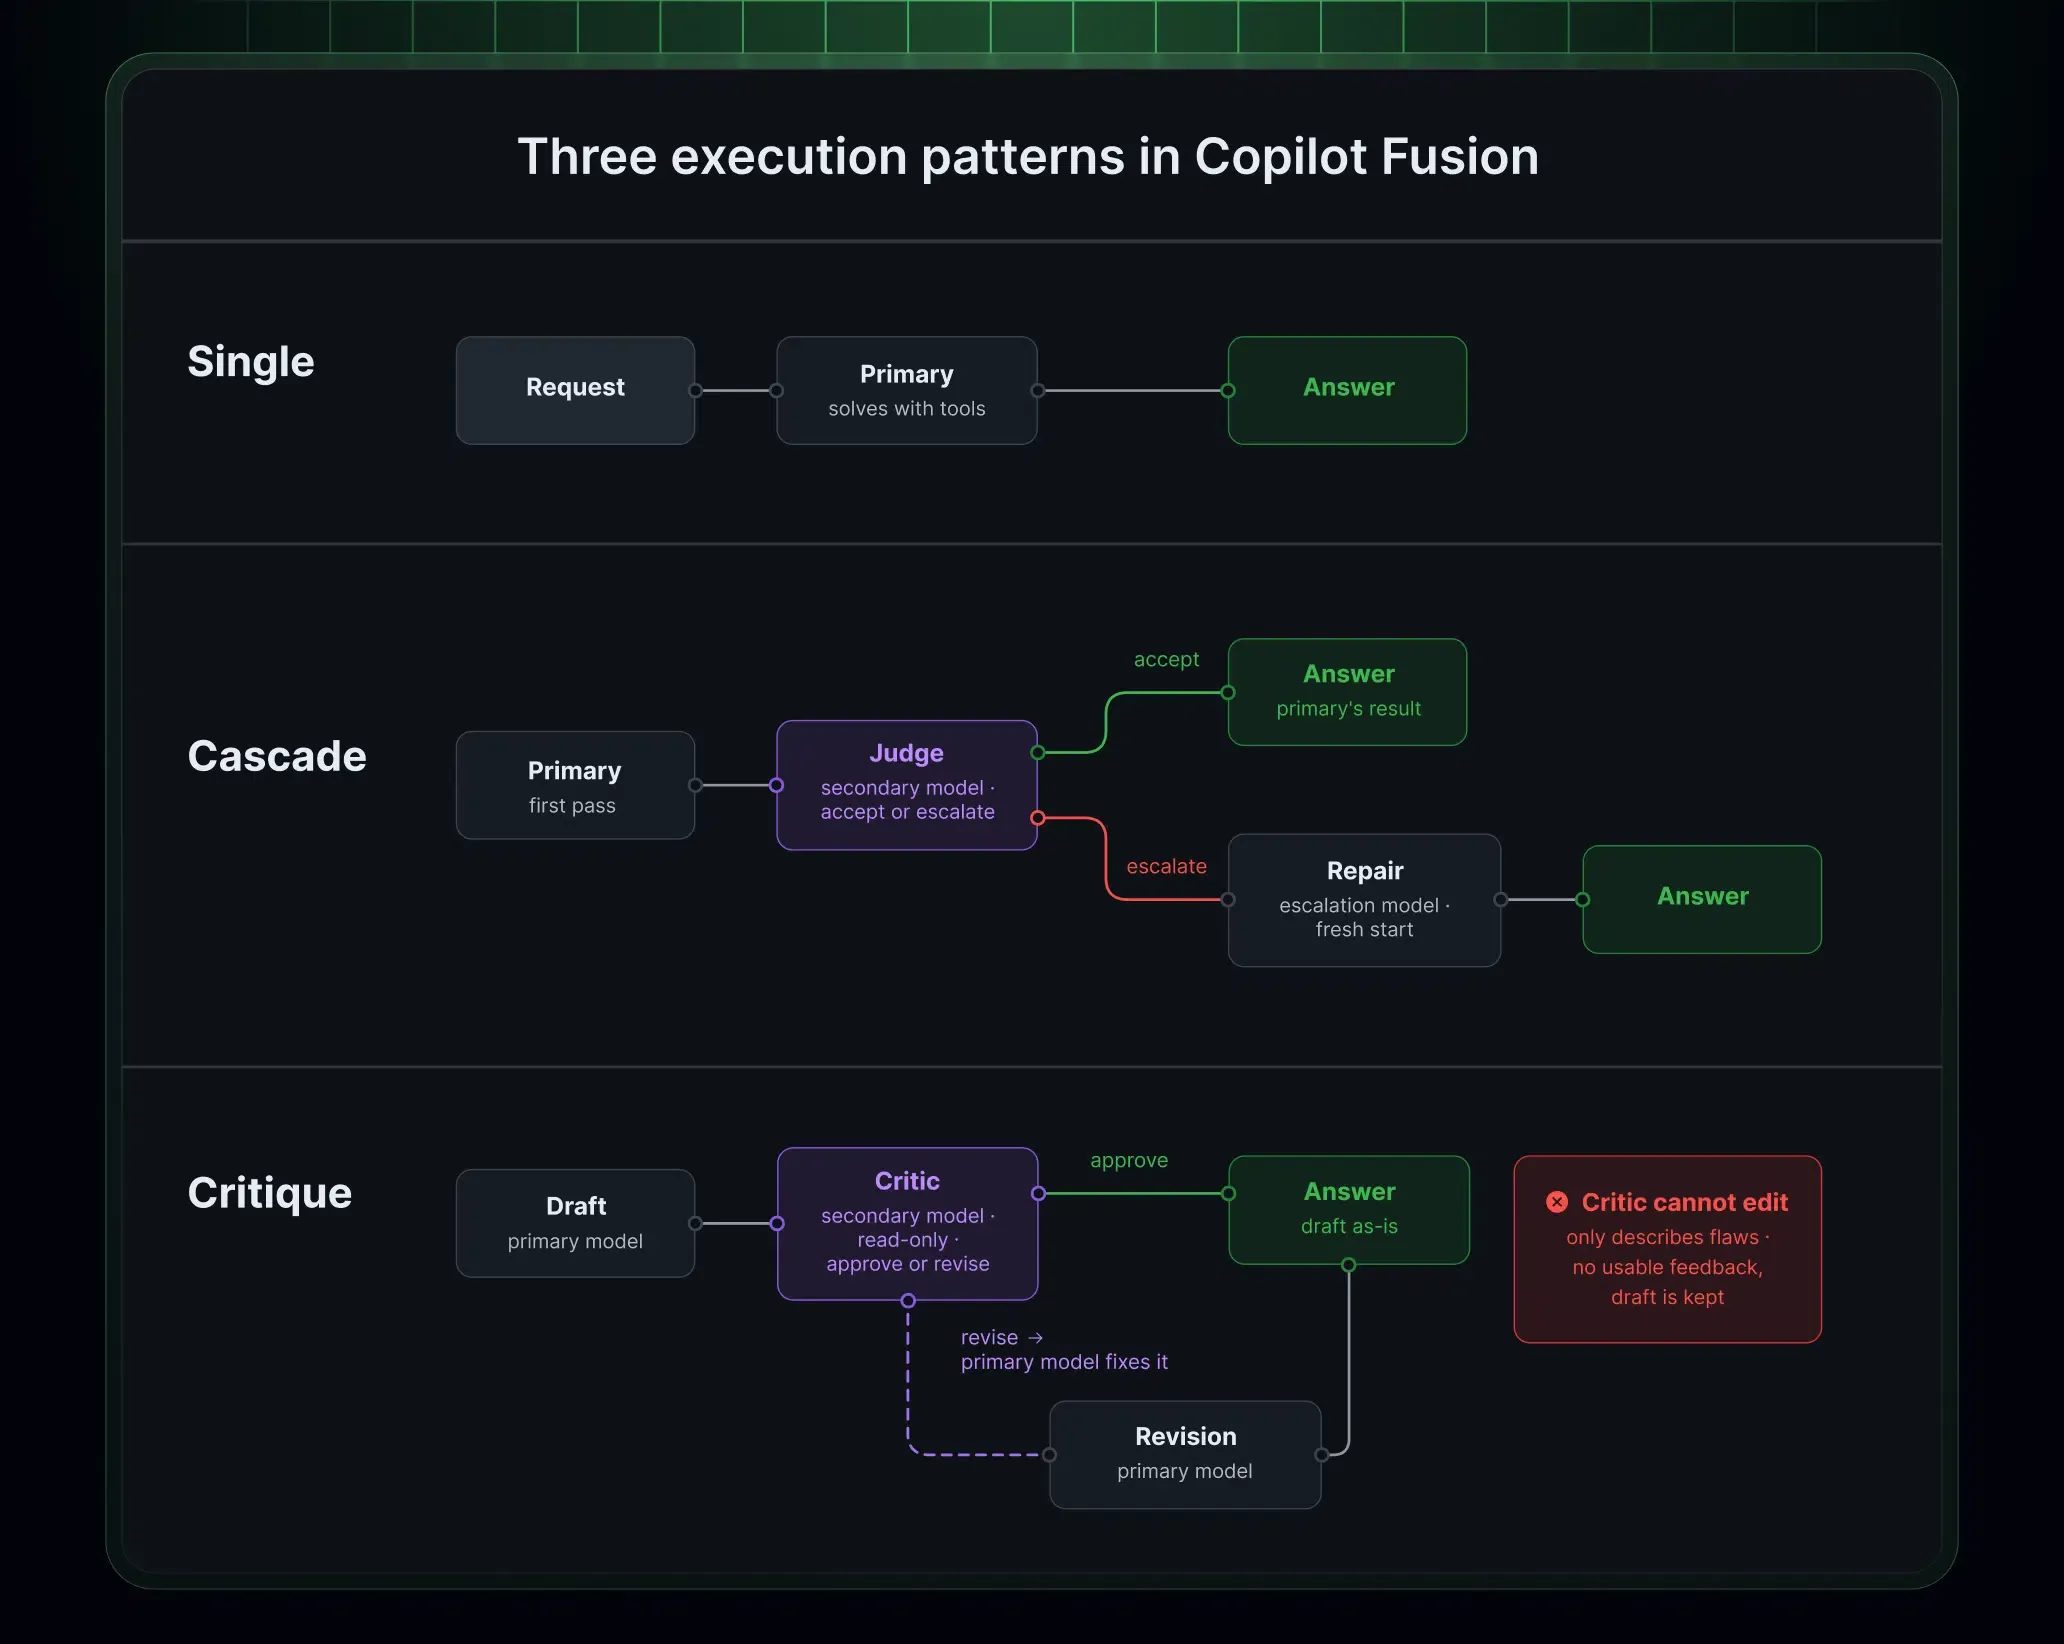
В зависимости от характеристик задачи и выбранного уровня усилий, система динамически выбирает один из трех паттернов выполнения:
- Одиночный паттерн (Single): одна модель получает промпт и выполняет задачу напрямую, не создавая дополнительных накладных расходов на проверку. Этот паттерн подходит для простой генерации кода, синтаксических запросов и базового рефакторинга.
- Каскадный паттерн (Cascade): легковесная модель создает предварительный проект решения. Вторичная модель-судья проверяет предложенный код и принимает решение о его принятии или эскалации задачи более мощной модели для доработки.
- Паттерн критики (Critique): основная модель создает первоначальный ответ, в то время как одна или несколько моделей-рецензентов независимо и параллельно оценивают код. Оркестратор агрегирует их отзывы, и основная модель соответствующим образом дорабатывает код перед возвратом финального результата пользователю.
[Single Pattern]
  Prompt ──> Primary Model ──> Single Execution ──> Final Code Output

[Cascade Pattern]
  Prompt ──> Lightweight Model ──> Initial Draft ──> Judge Model ──[Accept]──> Final Code Output
                                                         └──[Escalate]──> Stronger Model ──> Final Output

[Critique Pattern]
  Prompt ──> Drafting Model ──> Initial Draft ──┬─> Reviewer Model A ──┐
                                                └─> Reviewer Model B ──┴─> Feedback Aggregator ──> Final Revision
Эти топологии выполнения создают определенные компромиссы между скоростью работы, строгостью проверки и вычислительными затратами. Вместо жесткого сопоставления промптов с конкретными паттернами, GitHub распределяет эти рабочие процессы по выбираемым уровням усилий:
- Fusion Standard: балансирует стоимость, качество и задержку для повседневного написания кода. Текущая реализация обычно выбирает одну модель на задачу.
- Fusion High: отдает приоритет более широким возможностям и глубоким рассуждениям для масштабных кодинговых задач с учетом эффективности использования токенов. При необходимости может применяться мультимодельная оркестрация.
- Fusion Max: обеспечивает возможности передового уровня для самых сложных задач с дополнительными шагами проверки или эскалации, динамически выбираемыми там, где это полезно.
- Fusion Fast: специализированный уровень усилий, который недоступен для самостоятельного выбора пользователем и используется в поддерживаемых сценариях встроенного чата Visual Studio Code, чувствительных к задержкам.
Управление границами контекста в динамических рабочих процессах требует специальной обработки памяти. Copilot Fusion не имеет собственного единого окна контекста. Вместо этого каждый шаг выполнения строго работает в пределах лимитов контекста конкретной модели, выполняющей эту подзадачу. Емкость контекста, отображаемая в среде разработки, отражает наиболее консервативный лимит среди участвующих моделей. Кроме того, для максимизации эффективности кэширования промптов Fusion сохраняет основной диалоговый поток на одной первичной модели везде, где это возможно, передавая помогающим моделям-рецензентам только необходимые изолированные окна контекста.
Корпоративное управление и интеграция локальных моделей в парках разработчиков
Внедрение автономной оркестрации моделей в крупных инженерных структурах компаний затрагивает вопросы управления, комплаенса и бюджетирования. Когда ИИ-система динамически выбирает между моделями от Anthropic, OpenAI и других провайдеров, администраторы должны гарантировать соблюдение правил безопасности и локализации данных организации.
Корпоративные администраторы могут управлять моделями, подходящими для Copilot Fusion, с помощью поддерживаемых политик моделей GitHub Copilot и настроек корпоративного управления, как описано в административном руководстве по Copilot Fusion. Администраторы могут просматривать список моделей, доступных для Fusion, задавать уровни усилий по умолчанию для рабочих мест разработчиков и отключать конкретные модели для Fusion без отключения их в масштабах всей компании. Fusion соблюдает применимые ограничения подписок, организаций, локализации данных, требования FedRAMP и ограничения моделей оценки. Эти элементы управления регулируют доступность моделей в системе, но они не заменяют собственные процессы проверки комплаенса, управления данными или проверки безопасности компании.
В таблице ниже показано, как различные архитектуры выполнения балансируют поверхности выполнения, механизмы проверки и профили затрат на токены:
| Паттерн выполнения | Основной вызов | Механизм проверки | Профиль стоимости токенов | Лучше всего подходит для |
|---|---|---|---|---|
| Single Mode | Одна выделенная модель | Отсутствует | Базовые стандартные тарифы модели | Простые правки кода и вопросы по синтаксису |
| Cascade Mode | Эффективная модель черновой генерации | Проверка моделью-судьей и эскалация | Низкая или умеренная (условная эскалация) | Четко ограниченные исправления багов и структурные изменения |
| Critique Mode | Первичный генератор | Параллельные независимые модели-рецензенты | Более высокая (несколько одновременных вызовов моделей) | Сложная архитектурная логика и критичный к безопасности код |
| Local Model Hybrid | Поддерживаемая локальная модель на устройстве | Координируемый в облаке выбор моделей | Сокращение потребления облачных токенов на локальных этапах | Доступный локальный вывод с облачной координацией маршрутизации |
Компания GitHub внедрила маршрутизацию с учетом локальных моделей в качестве экспериментального превью по подписке, о чем сообщается в журнале изменений GitHub, посвященном выбору локальных моделей. При настройке поддерживаемой локальной модели Copilot Fusion Standard может выбирать локальный вывод на устройстве для соответствующих задач, снижая использование облачных моделей на этих этапах. На системах под управлением Windows с совместимым аппаратным обеспечением разработчики могут устанавливать и запускать MAI Code 1.1 Flash через инструменты управления Windows ML в приложении Copilot, Copilot CLI или Visual Studio Code. Кроссплатформенные пользователи Windows, macOS и Linux могут настраивать локальные модели, такие как Qwen3.8 Flash Next, в Copilot CLI с использованием локальных провайдеров моделей вроде Ollama, запуская CLI с флагом --experimental.
Тем не менее, Copilot Fusion по-прежнему опирается на облачные решения маршрутизации, и для задач могут использоваться облачные модели, когда это необходимо. Таким образом, поддержка локальных моделей не делает из Copilot Fusion полностью автономную среду программирования; разработчикам, которым требуется изолированная безопасность (air-gapped), следует вместо этого рассмотреть специализированные офлайн-инструменты.
Чек-лист инженера: внедрение мультимодельной оркестрации в продакшн
Интеграция мультимодельной оркестрации времени выполнения в рабочие процессы разработки программного обеспечения требует корректировки привычек разработчиков, конфигураций сред разработки и финансовых операций предприятия. Руководство инженерных команд должно установить четкие операционные протоколы, чтобы извлечь выгоду из эффективности использования токенов и избежать подводных камней в рабочих процессах.
Чек-лист реализации для разработчиков
- Проверяйте диффы рабочей среды перед коммитами: отказ от черновика ИИ не приводит к автоматическому откату изменений файлов в рабочей среде; разработчики должны просматривать все незакоммиченные изменения перед отправкой кода.
- Сопоставляйте уровни усилий со сложностью задач: оставляйте Fusion Max для сложной алгоритмической логики и аудита безопасности, используя Fusion Standard для повседневного написания кода, чтобы предотвратить ненужный расход кредитов ИИ.
- Следите за потоками выполнения мультимодельного прогресса: наблюдайте за индикаторами выполнения в среде разработки, чтобы проверять, какие именно модели вносят вклад в сгенерированные блоки кода, обеспечивая прозрачность на всех этапах выполнения.
- Настраивайте поддерживаемые локальные модели: для подходящих задач на Fusion Standard настройте поддерживаемые локальные модели, такие как MAI Code 1.1 Flash на Windows или Qwen3.8 Flash Next через Ollama, включив экспериментальные настройки при необходимости.
Чек-лист корпоративного управления и FinOps
- Настройте политики корпоративных моделей: укажите, какие модели подходят для маршрутизации Fusion в корпоративной панели управления, приведя список моделей в соответствие с корпоративными требованиями комплаенса и локализации данных.
- Проводите аудит кредитов ИИ на основе использования: отслеживайте потребление кредитов на уровне команды по уровням усилий, учитывая тот факт, что мультимодельное выполнение в Fusion High и Max может потреблять больше кредитов на задачу, чем выполнение с одной моделью.
- Учитывайте промопериоды выставления счетов: при оценке операционных расходов учитывайте 30% скидку GitHub на стоимость моделей для платных подписчиков Copilot, действющую до 30 ноября 2026 года.
- Установите этапы ручной проверки кода: сохраняйте обязательное экспертное ревью кода для всех пулл-реквестов, созданных агентами, гарантируя, что автоматизированные циклы критики дополняют, а не заменяют человеческий инженерный надзор.
Часто задаваемые вопросы (FAQ)
Как GitHub рассчитывает выставление счетов, когда Copilot Fusion обращается к нескольким моделям?
Что происходит, если Copilot Fusion отбрасывает промежуточный проект кода?
Могут ли корпоративные администраторы ограничивать выбор моделей для Copilot Fusion?
Основные выводы для инженерных команд
Запуск GitHub Copilot Fusion подтверждает, что опора на единственную монолитную ИИ-модель для решения сложных инженерных задач влечет за собой ненужные операционные компромиссы. Современные рабочие процессы разработки охватывают самые разные когнитивные требования: от мгновенного завершения синтаксиса до сложнейшего кросс-репозиторного анализа. Попытки заставить архитектуру одной модели справляться со всем этим спектром могут привести к эскалации расходов на модели или снижению качества выполнения.
Результаты независимых бенчмарков показывают, что мультимодельная оркестрация способна обеспечивать конкурентоспособную производительность кодирования при более низких затратах на модели для определенных рабочих нагрузок. Фактические результаты будут зависеть от сложности задач, поведения оркестрации, выбранных моделей и паттернов использования в организации. Отделив распределение задач от ручного выбора разработчика, оркестрация моделей во время выполнения формирует прагматичный операционный путь. По мере того как инженерные компании масштабируют автоматизированных агентов кодирования, главным конкурентным преимуществом станет не доступ к какой-либо отдельной базовой модели, а управляемость, надежность и архитектурная строгость связывающего их уровня оркестрации.
Ссылки
-
GitHub: Маршрутизация и оркестрация моделей с помощью GitHub Copilot Fusion — официальные примечания к релизу и обзор функций с конференции GitHub Universe 2026.
-
GitHub: Copilot Fusion теперь поддерживает выбор локальных моделей — официальный анонс, описывающий вывод на устройстве для подходящих задач с маршрутизацией локальных моделей.
-
Документация GitHub: О концепциях и конфигурации GitHub Copilot Fusion — официальная техническая документация, подробно описывающая паттерны выполнения, уровни усилий и правила выставления счетов.
-
Документация GitHub: Настройка моделей, доступных для Copilot Fusion — административные рекомендации по управлению корпоративными политиками моделей и настройками по умолчанию.
-
Artificial Analysis: Оценка бенчмарка GitHub Copilot Fusion — независимый анализ, измеряющий затраты на задачи, эффективность токенов и оценки индекса Coding Agent Index.
-
The New Stack: GitHub представляет мультимодельную систему Copilot Fusion — технический репортаж об интеграции Project HydraFusion и внедрении корпоративными клиентами.
-
VentureBeat: GitHub Copilot Fusion смешивает модели ради экономической эффективности — техническое интервью с руководством по продуктам GitHub, посвященное архитектурам маршрутизации времени выполнения.
Share this article