OpenAI และ Google สนับสนุนการเลือกไม่เข้าร่วมฝึก AI ร่วมกัน? OpenAI, Google และ Microsoft ได้ประกาศแผนเมื่อวันที่ 30 ตุลาคม 2026 เพื่อเคารพโทเค็นนโยบายเดี่ยวที่ใช้ร่วมกันใน robots.txt ซึ่งช่วยให้ผู้ดูแลเว็บไซต์สามารถแสดงความต้องการเกี่ยวกับการฝึกโมเดล Generative AI กับผู้ให้บริการหลายรายพร้อมกันได้ กลไกที่เสนอนี้มีที่มาจากร่างอินเทอร์เน็ตส่วนบุคคล (Internet-Draft) ที่ส่งไปยังกลุ่มทำงาน IETF AI Preferences โดย Kevin Kelley วิศวกรของ Anthropic แม้ว่าความคิดริเริ่มนี้จะมอบวิธีที่คล่องตัวให้กับสำนักพิมพ์ในการประกาศการเลือกไม่เข้าร่วมฝึกด้วยไวยากรณ์ Allow และ Disallow แบบมาตรฐาน แต่กำหนดการใช้งานยังคงมีความเหลื่อมล้ำไปจนถึงปี 2027 และแพลตฟอร์มหลักแต่ละแห่งวางแผนที่จะตีความและใช้สัญญาณดังกล่าวแตกต่างกันในการฝึกโมเดลและการเชื่อมโยงข้อมูลบทสนทนาสด
การปรับโครงสร้างอุตสาหกรรมครั้งสำคัญ: ห้องปฏิบัติการ AI รายใหญ่ประสานมาตรฐาน Robots.txt
สรุปสาระสำคัญ
- OpenAI, Google และ Microsoft ประกาศแผนงานที่ประสานกันเมื่อวันที่ 30 ตุลาคม 2026 เพื่อยอมรับโทเค็นนโยบาย robots.txt ที่ใช้ร่วมกัน นั่นคือ
__usage_ai-trainingสำหรับจัดการความต้องการในการฝึกโมเดลเชิงสร้างสรรค์ - สัญญาณดังกล่าวถูกกำหนดไว้ในร่างอินเทอร์เน็ต IETF ส่วนบุคคลซึ่งจัดทำโดย Kevin Kelley วิศวกรของ Anthropic โดยสร้างไวยากรณ์ที่เป็นมาตรฐานโดยยังไม่ได้เป็นมาตรฐาน IETF RFC อย่างเป็นทางการหรือสมบูรณ์
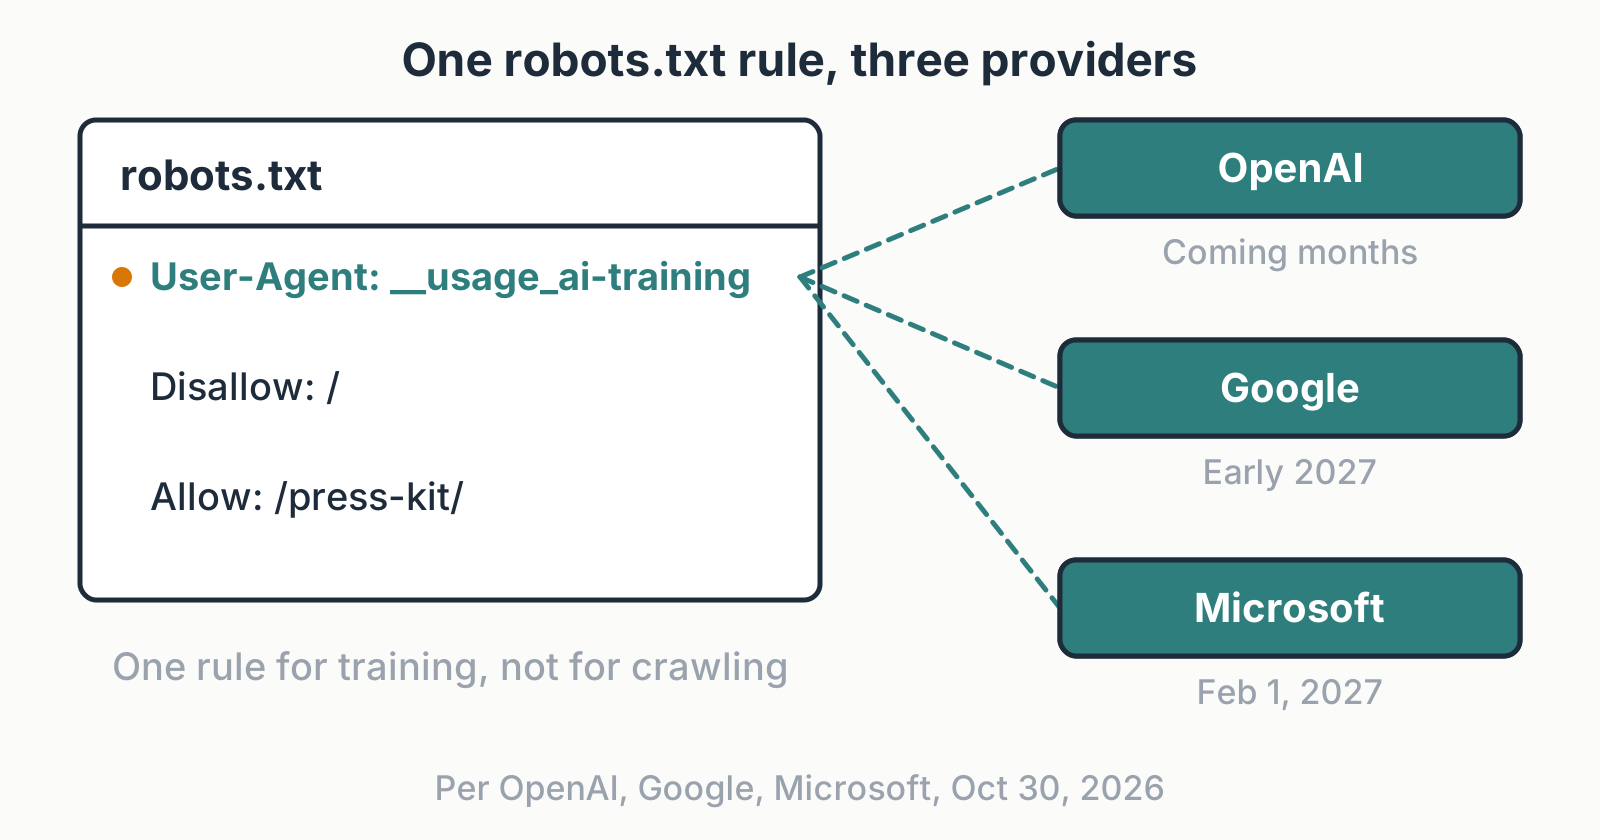
- กำหนดการนำไปใช้ของแพลตฟอร์มมีความแตกต่างกันอย่างมาก: Anthropic ได้เริ่มงานวิศวกรรมภายในแล้ว, OpenAI ตั้งเป้าเปิดตัวในอีกไม่กี่เดือนข้างหน้า, Microsoft เริ่มต้นในวันที่ 1 กุมภาพันธ์ 2027 และ Google คาดว่าจะรองรับในปี 2027
เกือบสามสิบปีที่ผ่านมา โปรโตคอลการยกเว้นหุ่นยนต์ (Robots Exclusion Protocol) ได้ควบคุมวิธีที่เว็บครอว์เลอร์อัตโนมัติโต้ตอบกับเนื้อหาออนไลน์สาธารณะ ผู้ดูแลระบบเว็บไซต์จะวางไฟล์ข้อความธรรมดา robots.txt ไว้ในไดเรกทอรีหลักเพื่อกำหนดว่ายูสเซอร์แอนตี้ของเครื่องมือค้นหาใดได้รับอนุญาตให้นำทางไปยังเส้นทาง URL เฉพาะ โปรโตคอลนี้ดำเนินการบนพื้นฐานข้อตกลงทางการค้า: ผู้เผยแพร่เว็บไซต์อนุญาตให้ครอว์เลอร์จัดทำดัชนีเนื้อหาของตนเพื่อแลกกับการมองเห็น การเข้าชมจากลิงก์อ้างอิง และการสร้างการรับรู้แบรนด์บนหน้าผลลัพธ์ของเครื่องมือค้นหา
การเติบโตอย่างรวดเร็วของปัญญาประดิษฐ์เชิงสร้างสรรค์ได้ส่งผลกระทบต่อโมเดลทางเศรษฐกิจดังกล่าว โปรแกรมคัดลอกข้อมูลอัตโนมัติที่ปรับใช้โดยห้องปฏิบัติการ AI ชั้นนำเริ่มดึงข้อมูลโดเมนเว็บเพื่อฝึกโมเดลรากฐาน ซึ่งบ่อยครั้งมักสรุปเนื้อหาต้นฉบับภายในอินเทอร์เฟซคำตอบโดยตรงโดยไม่ส่งต่อการคลิกอ้างอิงไปยังผู้เผยแพร่ เจ้าของเนื้อหาที่ต้องการป้องกันไม่ให้ทรัพย์สินทางปัญญาของตนถูกนำไปใช้ จำเป็นต้องบำรุงรักษาชุดข้อมูลยูสเซอร์แอนตี้ที่เป็นกรรมสิทธิ์ซึ่งมีความกระจัดกระจายและซับซ้อน รวมถึง GPTBot, ClaudeBot และ Google-Extended ค่าใช้จ่ายในการดูแลระบบนี้ทำให้ความเสี่ยงเชิงปฏิบัติการในการกำหนดค่าผิดพลาดหรือการถอดดัชนีการค้นหาโดยไม่ได้ตั้งใจเพิ่มสูงขึ้นเมื่อต้องจัดการคำสั่งครอว์เลอร์หลายรายการพร้อมกัน

การปรากฏตัวของการเลือกไม่เข้าร่วมการฝึก AI แบบใช้ร่วมกันถือเป็นการเปลี่ยนแปลงครั้งสำคัญจากการบล็อกผู้ให้บริการแบบกระจัดกระจายไปสู่การกำกับดูแลโปรโตคอลแบบร่วมมือกัน ด้วยการประสานงานสนับสนุนรอบโทเค็นนโยบายที่ใช้ร่วมกัน ผู้ให้บริการ AI รายใหญ่จึงมุ่งลดอุปสรรคทางเทคนิคสำหรับผู้สร้างเนื้อหาที่ต้องการกำหนดขอบเขตที่ชัดเจนเกี่ยวกับการฝึกโมเดล Generative AI อ้างอิงจากประกาศอย่างเป็นทางการของ Google Search Central กฎเดียวนี้นโยบายช่วยให้ผู้ดูแลระบบเว็บไซต์สามารถประกาศจุดยืนการฝึก Generative AI ได้ในขั้นตอนเดียว แทนที่จะต้องติดตามและกำหนดค่าคำสั่งที่แตกต่างกันสำหรับครอว์เลอร์ AI เชิงพาณิชย์แต่ละรายที่เข้าสู่ตลาด
กลไกสถาปัตยกรรมเบื้องหลัง: โทเค็น __usage_ai-training ทำงานอย่างไร
สถาปัตยกรรมทางเทคนิคเบื้องหลังสัญญาณความต้องการที่ใช้ร่วมกันนี้ได้รับการระบุไว้ในร่างอินเทอร์เน็ต IETF ว่าด้วยสัญญาณความต้องการการฝึกที่เครื่องอ่านได้ สิ่งสำคัญคือ ร่างดังกล่าวไม่ได้แนะนำคำสั่งใหม่หรือเปลี่ยนแปลงไวยากรณ์พื้นฐานของโปรโตคอลการยกเว้นหุ่นยนต์ที่กำหนดไว้ใน RFC 9309 แต่เป็นการนำเรคคอร์ด User-Agent มาใช้ใหม่โดยกำหนดโทเค็นนโยบายที่สงวนไว้: __usage_ai-training
ในการกำหนดค่าการเลือกไม่เข้าร่วม เว็บมาสเตอร์จะสร้างบล็อกกฎปกติที่กำหนดโทเค็นนโยบายนี้เป็นยูสเซอร์แอนตี้ ตามด้วยกฎ Disallow และ Allow แบบมาตรฐาน ตัวอย่างด้านล่างแสดงวิธีที่เจ้าของเว็บไซต์แสดงการเลือกไม่เข้าร่วมในไดเรกทอรีเว็บไซต์ทั้งหมด ขณะที่ยังคงข้อยกเว้นสำหรับสื่อประชาสัมพันธ์สาธารณะ:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
คำจำกัดความทางความหมายของสิ่งที่ถือเป็นการ “ฝึก AI” นั้นยึดโยงอยู่กับข้อกำหนดคำศัพท์พื้นฐานของกลุ่มทำงาน IETF ภายใต้กรอบนี้ การฝึกถูกกำหนดไว้อย่างเคร่งครัดว่าเป็นการใช้เนื้อหาเว็บที่ดึงมาเพื่อปรับเปลี่ยนหรือปรับแต่งน้ำหนักและพารามิเตอร์ที่เรียนรู้ของโมเดลปัญญาประดิษฐ์เชิงสร้างสรรค์ การดำเนินการคำนวณที่ไม่ใช่เชิงสร้างสรรค์ เช่น การจำแนกประเภทเอกสารมาตรฐาน การจัดอันดับดัชนีการค้นหา การแก้ไขการสะกดคำ และการกรองสแปม จะถูกยกเว้นอย่างชัดเจนจากคำจำกัดความนี้
ขอบเขตโปรโตคอล: การครอว์ล เทียบกับการฝึก เทียบกับการเชื่อมโยงบริบท
การทำความเข้าใจขีดจำกัดการทำงานของโทเค็นที่เสนอนี้กำหนดให้ต้องแยกแยะขั้นตอนต่างๆ ของการดึงข้อมูลอัตโนมัติออกจากกัน:
[เนื้อหาเว็บสาธารณะ]
       │
       ▼
[1. การครอว์ล/ดึงข้อมูล HTTP] ──> ควบคุมโดยยูสเซอร์แอนตี้ของครอว์เลอร์เฉพาะ (เช่น GPTBot, Bingbot)
       │                    *__usage_ai-training ไม่ได้ควบคุมพฤติกรรมการดึงข้อมูล HTTP*
       ├────────────────────────────────────────┐
       ▼                                        ▼
[2. การใช้เพื่อฝึกโมเดล]                  [3. การเชื่อมโยงข้อมูลสด / RAG]
   *__usage_ai-training: Disallow*          *ควบคุมโดยแท็กหน้าเว็บ & การตั้งค่าผู้ให้บริการ*
   แสดงความต้องการปฏิเสธการฝึก             จัดเตรียมบริบทเว็บแบบเรียลไทม์ให้กับโมเดล AI
       │                                        │
       ▼                                        ▼
   การบังคับใช้ขึ้นอยู่กับ                   เกณฑ์คุณสมบัติกำหนดโดย
   ผู้ให้บริการ AI ที่เข้าร่วม                นโยบายแพลตฟอร์มแต่ละราย
ทีมเทคนิคต้องประเมินขอบเขตโครงสร้างสี่ประการที่มีอยู่ในข้อกำหนดร่างนี้:
- สัญญาณควบคุมการฝึก ไม่ใช่การครอว์ล: โทเค็นนโยบายไม่ใช่คำสั่งสำหรับพฤติกรรมการครอว์ลเครือข่าย ครอว์เลอร์ AI ที่พบ
Disallow: /ภายใต้__usage_ai-trainingยังคงได้รับอนุญาตให้นำเอกสาร HTML ผ่าน HTTP แต่ได้รับคำสั่งเพียงว่าไม่ให้นำข้อความที่ดึงมานั้นไปป้อนเข้าสู่ไปป์ไลน์การฝึกโมเดล เพื่อป้องกันไม่ให้บอทขอ URL ทั้งหมด ผู้ดูแลระบบต้องบล็อกชื่อเฉพาะของครอว์เลอร์นั้นต่อไป - กฎ Wildcard ไม่มีผลใช้บังคับ: บล็อก Wildcard ทั่วไป เช่น
User-Agent: *ตามด้วยDisallow: /จะไม่ตรงกับโทเค็นนโยบาย ร่างข้อกำหนดกำหนดว่าผู้ให้บริการ AI ที่เข้าร่วมจะต้องไม่ตีความกลุ่ม Wildcard สากลเป็นการแสดงความต้องการฝึก AI หากไฟล์ละเว้นโทเค็น__usage_ai-trainingที่ชัดเจน ระบบมาตรฐานจะตีความว่าเว็บไซต์ดังกล่าวไม่ได้แสดงความต้องการฝึกใดๆ - ไม่มีการลบการเรียนรู้ของโมเดลย้อนหลัง: การอัปเดตไฟล์
robots.txtของเว็บไซต์จะมีผลไปข้างหน้า โดยทำหน้าที่เป็นสัญญาณสำหรับวงจรการครอว์ลและการฝึกในอนาคต แต่ไม่ได้บังคับให้ห้องปฏิบัติการ AI ต้องลบข้อมูลที่รวมอยู่ในชุดข้อมูลการฝึกในอดีตแล้ว หรือลบน้ำหนักจากโมเดลรากฐานที่มีอยู่เดิม - การประสานงานด้วยความสมัครใจเหนือการบังคับใช้ทางเทคนิค: สัญญาณดังกล่าวแสดงถึงความต้องการของผู้เผยแพร่เนื้อหา โดยไม่ได้ให้การบังคับใช้ทางเทคนิคกับผู้บริโภคข้อมูลที่ไม่เข้าร่วมหรือไม่ปฏิบัติตาม ภายใต้หลักการ RFC 9309 ไฟล์ robots.txt ยังคงเป็นกลไกคำแนะนำแบบร่วมมือกันมากกว่าไฟร์วอลล์ควบคุมการเข้าถึง
ความแตกต่างในการใช้งานของผู้ให้บริการและกำหนดการย้ายข้อมูล
แม้ว่า Google, Microsoft และ OpenAI จะประกาศแผนการสนับสนุนสัญญาณที่ใช้ร่วมกันแล้ว แต่การใช้งานทางเทคนิคและกำหนดการเปิดตัวของพวกเขามีความแตกต่างกันอย่างมาก ผู้ให้บริการแต่ละรายเข้าถึงความสมดุลระหว่างการจัดทำดัชนีของเครื่องมือค้นหา การฝึกโมเดลเชิงสร้างสรรค์ และการเรียกคืนข้อมูลเพื่อเสริมการสร้างคำตอบ (RAG) ผ่านโครงสร้างพื้นฐานผลิตภัณฑ์ของตนเอง
ตารางด้านล่างเปรียบเทียบข้อผูกพันของแพลตฟอร์มที่ได้รับการยืนยัน กฎการตีความ และกำหนดการย้ายข้อมูล:
| แพลตฟอร์ม | สถานะที่ยืนยัน & ไทม์ไลน์ | การตีความโทเค็นนโยบาย | การจัดการการเชื่อมโยงข้อมูล & การเรียกคืน | การย้ายแท็กเดิม & ข้อยกเว้น |
|---|---|---|---|---|
| ประกาศการสนับสนุน; วางแผนสำหรับปี 2027 (วันที่แน่นอนจะประกาศภายหลัง) | ตีความว่าเป็น Google-Extended: Disallow เมื่อไม่มีกฎ Google-Extended ที่ชัดเจน |
การแมปเริ่มต้นส่งผลต่อการเชื่อมโยงข้อมูลใน Gemini Apps; กฎที่ชัดเจนจะมีผลเหนือกว่า | คำสั่ง Google-Extended ที่มีอยู่ยังคงใช้งานได้เต็มรูปแบบ การจัดทำดัชนีการค้นหาไม่ได้รับผลกระทบ |
|
| Microsoft | ยืนยันความมุ่งมั่น เริ่มเคารพตั้งแต่วันที่ 1 กุมภาพันธ์ 2027 | ได้รับการยอมรับว่าเป็นตัวเลือกไม่เข้าร่วมการฝึกในระหว่างการครอว์ลเว็บ | แยกออกจากการฝึก จัดการแยกต่างหากผ่านแท็กระดับหน้าเว็บ | ยกเลิกการใช้ NoArchive/NoCache สำหรับ AI ในวันที่ 1 มีนาคม 2027; การตั้งค่าชั่วคราวใน Bing Webmaster Tools เปิดให้ใช้งานตั้งแต่วันที่ 15 ธันวาคม |
| OpenAI | มุ่งมั่นที่จะนำไปใช้ในอีกไม่กี่เดือนข้างหน้า | รองรับโดยตรงในไปป์ไลน์การนำเข้าข้อมูล | ประเมินร่วมกับคำสั่ง GPTBot |
การกำหนดค่า GPTBot ที่มีอยู่ยังคงทำงานและสามารถบังคับใช้ได้ |
| Anthropic | ร่างจัดทำโดยพนักงาน มีรายงานการพัฒนาบนรายการกลุ่มทำงาน | ตั้งใจรองรับทั่วทั้งบริการ; ไทม์ไลน์ข่าวอย่างเป็นทางการจะแจ้งให้ทราบภายหลัง | ประเมินร่วมกับคำสั่ง ClaudeBot |
การควบคุมครอว์เลอร์ ClaudeBot ที่มีอยู่ยังคงทำงานต่อไป |
Google วางแผนที่จะตีความการเลือกไม่เข้าร่วมการฝึก AI ร่วมกันว่าเป็นคำสั่งไม่อนุญาตของ Google-Extended (Google-Extended disallow) เมื่อไม่มีกฎ Google-Extended ที่ชัดเจน เนื่องจาก Google-Extended ควบคุมสิทธิ์ในการเชื่อมโยงข้อมูลใน Gemini Apps ด้วย การแมปเริ่มต้นนี้จึงอาจส่งผลต่อความพร้อมใช้งานของเนื้อหาของผู้เผยแพร่สำหรับประสบการณ์เหล่านั้น กฎ Google-Extended ที่ชัดเจนจะมีผลเหนือกว่าสัญญาณที่ใช้ร่วมกันในการใช้งานของ Google แต่ผู้เผยแพร่ไม่ควรคาดคิดว่าการควบคุมปัจจุบันของ Google จะเสนอการเลือกไม่เข้าร่วมที่แยกอิสระสำหรับการฝึกโมเดลและการเชื่อมโยงข้อมูลใน Gemini Apps เนื้อหาที่ได้รับอนุญาตภายใต้ Google-Extended อาจมีสิทธิ์สำหรับการเชื่อมโยงข้อมูลใน Gemini โดยไม่มีการรับประกันใดๆ เกี่ยวกับการรวมหรือการอ้างอิง
ในทางตรงกันข้าม Microsoft Bing มองว่าการฝึกโมเดลและการเชื่อมโยงข้อมูลแบบเรียลไทม์เป็นแนวคิดทางสถาปัตยกรรมที่แตกต่างกัน ตามรายละเอียดในการอัปเดต Bing Webmaster อย่างเป็นทางการ Microsoft อนุญาตให้ผู้เผยแพร่เลือกไม่เข้าร่วมการฝึกโมเดล Generative AI ในขณะที่ยังคงอนุญาตให้มีการเชื่อมโยงข้อมูลสดในคำตอบของ Copilot ได้ เว็บไซต์ที่จัดการความต้องการเหล่านี้สามารถประกาศข้อจำกัดการฝึกได้ใน robots.txt หรือผ่านแท็ก meta HTML ระดับหน้าเว็บและส่วนหัว HTTP ซึ่งจะมีผลเหนือกว่า robots.txt สำหรับ URL เฉพาะ การเชื่อมโยงข้อมูลถูกควบคุมผ่านความต้องการระดับหน้าเว็บ รวมถึงตัวเลือก DisallowExtended ที่อนุญาตการเชื่อมโยงข้อมูลในเครื่องมือของ Microsoft เอง (เช่น Copilot) แต่ยกเว้นบริการของบุคคลที่สามที่ขับเคลื่อนด้วย API การเชื่อมโยงข้อมูลของ Microsoft นอกจากนี้ Microsoft กำลังทยอยเลิกพึ่งพาแท็ก NoArchive และ NoCache แบบเดิมสำหรับการควบคุม AI โดยเว็บไซต์ที่พึ่งพาแท็กดังกล่าวจะต้องย้ายไปใช้ตัวเลือกใหม่ก่อนวันที่ 1 มีนาคม 2027 การตั้งค่าการเชื่อมโยงข้อมูลชั่วคราวของ Bing Webmaster Tools จะใช้งานได้เฉพาะกับเว็บไซต์ที่ใช้ NoArchive หรือ NoCache ณ วันที่ 15 ธันวาคม 2026 เท่านั้น และจะมีผลจนกว่า Microsoft จะทำการครอว์ลหน้าเว็บนั้นใหม่และพบความต้องการใหม่ หรือจนถึงวันที่ 30 กันยายน 2027 แล้วแต่เหตุการณ์ใดจะเกิดขึ้นก่อน
รายการตรวจสอบทางวิศวกรรม: การตรวจสอบความต้องการของเว็บสำหรับยุคเว็บตัวแทน (Agentic Web)
การปรับใช้สัญญาณความต้องการการฝึก AI แบบใช้ร่วมกันจำเป็นต้องมีการประสานงานระหว่างสถาปัตยกรรมระบบ การดำเนินงานด้านเนื้อหา และทีมกำกับดูแลทางกฎหมาย ผู้นำทางวิศวกรรมต้องมั่นใจว่าการกำหนดค่าเซิร์ฟเวอร์สะท้อนถึงนโยบายขององค์กรได้อย่างแม่นยำ โดยไม่รบกวนการค้นพบของเครื่องมือค้นหาโดยไม่ได้ตั้งใจ
รายการตรวจสอบสำหรับเว็บมาสเตอร์และการใช้งานระบบ
- ตรวจสอบรายการ Manifest ของ Robots ปัจจุบัน: ตรวจสอบไฟล์
robots.txtที่มีอยู่เพื่อจัดทำแคตตาล็อกคำสั่งเฉพาะของผู้ให้บริการ โดยตรวจสอบว่ากฎสำหรับGPTBot,ClaudeBotหรือGoogle-Extendedขัดแย้งกับนโยบายการฝึกขององค์กรหรือไม่ - ปรับใช้โทเค็นนโยบายที่สงวนไว้: ดำเนินการบล็อก
User-Agent: __usage_ai-trainingเพื่อแสดงขอบเขตการฝึกทั่วโลกข้ามผู้ให้บริการ AI ที่เข้าร่วมในรูปแบบที่เป็นหนึ่งเดียว - รักษาระบบเส้นทางข้อยกเว้นแบบละเอียด: หากเนื้อหา publiques เช่น ข่าวประชาสัมพันธ์ ชุดข้อมูลสื่อ หรือเอกสารสำหรับนักพัฒนาแบบเปิด มีไว้เพื่อให้โมเดลนำไปใช้ ให้ประกาศข้อยกเว้น
Allow:ที่ชัดเจนไว้ใต้คำสั่งห้าม - แยกการบล็อกการดึงข้อมูลออกจากธรรมาภิบาลการฝึก: หากวัตถุประสงค์หลักคือการลดภาระของเซิร์ฟเวอร์ต้นทางหรือป้องกันการคัดลอกข้อมูลโดยไม่ได้รับอนุญาต ให้กำหนดค่าการจำกัดอัตราตาม IP การท้าทายบอทของ CDN และบล็อกยูสเซอร์แอนตี้ของครอว์เลอร์ที่ชัดเจน
รายการตรวจสอบด้านการกำกับดูแลและการปฏิบัติตามข้อกำหนด
- ตรวจสอบกำหนดการย้ายข้อมูลการเชื่อมโยงข้อมูลของ Microsoft: สำหรับเว็บไซต์ที่ใช้
NoArchiveหรือNoCacheเพื่อควบคุมผลลัพธ์ของ Bing Copilot ให้เตรียมพร้อมสำหรับการเปลี่ยนไปใช้แท็กระดับหน้าเว็บใหม่ก่อนกำหนดเส้นตายการบังคับใช้ของ Microsoft ในวันที่ 1 มีนาคม 2027 - ประเมินความสมดุลของการค้นหาและการค้นพบ: สำหรับแพลตฟอร์มที่ประเมินการมองเห็นในเครื่องมือตอบคำถามแบบสนทนา ให้ตระหนักว่าการแมปเริ่มต้นเฉพาะผู้ให้บริการ (เช่น การสำรองข้อมูลของ Google ไปยัง
Google-Extended) ส่งผลต่อสิทธิ์ในการเรียกคืนข้อมูลแบบเรียลไทม์อย่างไร - ติดตามการอัปเดตของกลุ่มทำงาน IETF: ติดตามความคืบหน้าของ
draft-kelley-aipref-training-preference-signalภายในกลุ่มทำงาน IETF AIPREF เพื่อรองรับการอัปเดตไวยากรณ์ที่เป็นไปได้ก่อนที่จะหมดอายุตามกำหนดในเดือนพฤษภาคม 2027
Share this article