Anthropic Sonnet 5.5 : 30 % plus rapide ? Anthropic a officiellement lancé Claude Sonnet 5.5, le laboratoire annonçant une génération de sortie plus rapide de plus de 30 % et une réduction des coûts par tâche pouvant atteindre 30 %. Alors que les plateformes d'intelligence artificielle générative passent du stade de prototypes expérimentaux à celui de systèmes de production à haut volume, les équipes d'ingénierie logicielle sont confrontées à une pression croissante pour maîtriser la consommation de jetons et la latence d'exécution. Historiquement, les architectes d'entreprise supposaient que l'obtention de performances de codage de pointe nécessitait le déploiement des modèles les plus grands et les plus coûteux. Aujourd'hui, comme des architectures intermédiaires optimisées peuvent résoudre des défis d'ingénierie logicielle complexes avec moins d'étapes opérationnelles et d'appels d'outils, l'économie fondamentale des outils de développement automatisés s'oriente vers l'efficacité d'exécution.
Économie de production : pourquoi le coût de réalisation d'une tâche importe plus que le prix du jeton
En un coup d'œil
- Anthropic a lancé Claude Sonnet 5.5 le 28 septembre 2026, offrant une génération plus rapide de 30 % et un coût par tâche accomplie réduit jusqu'à 30 %.
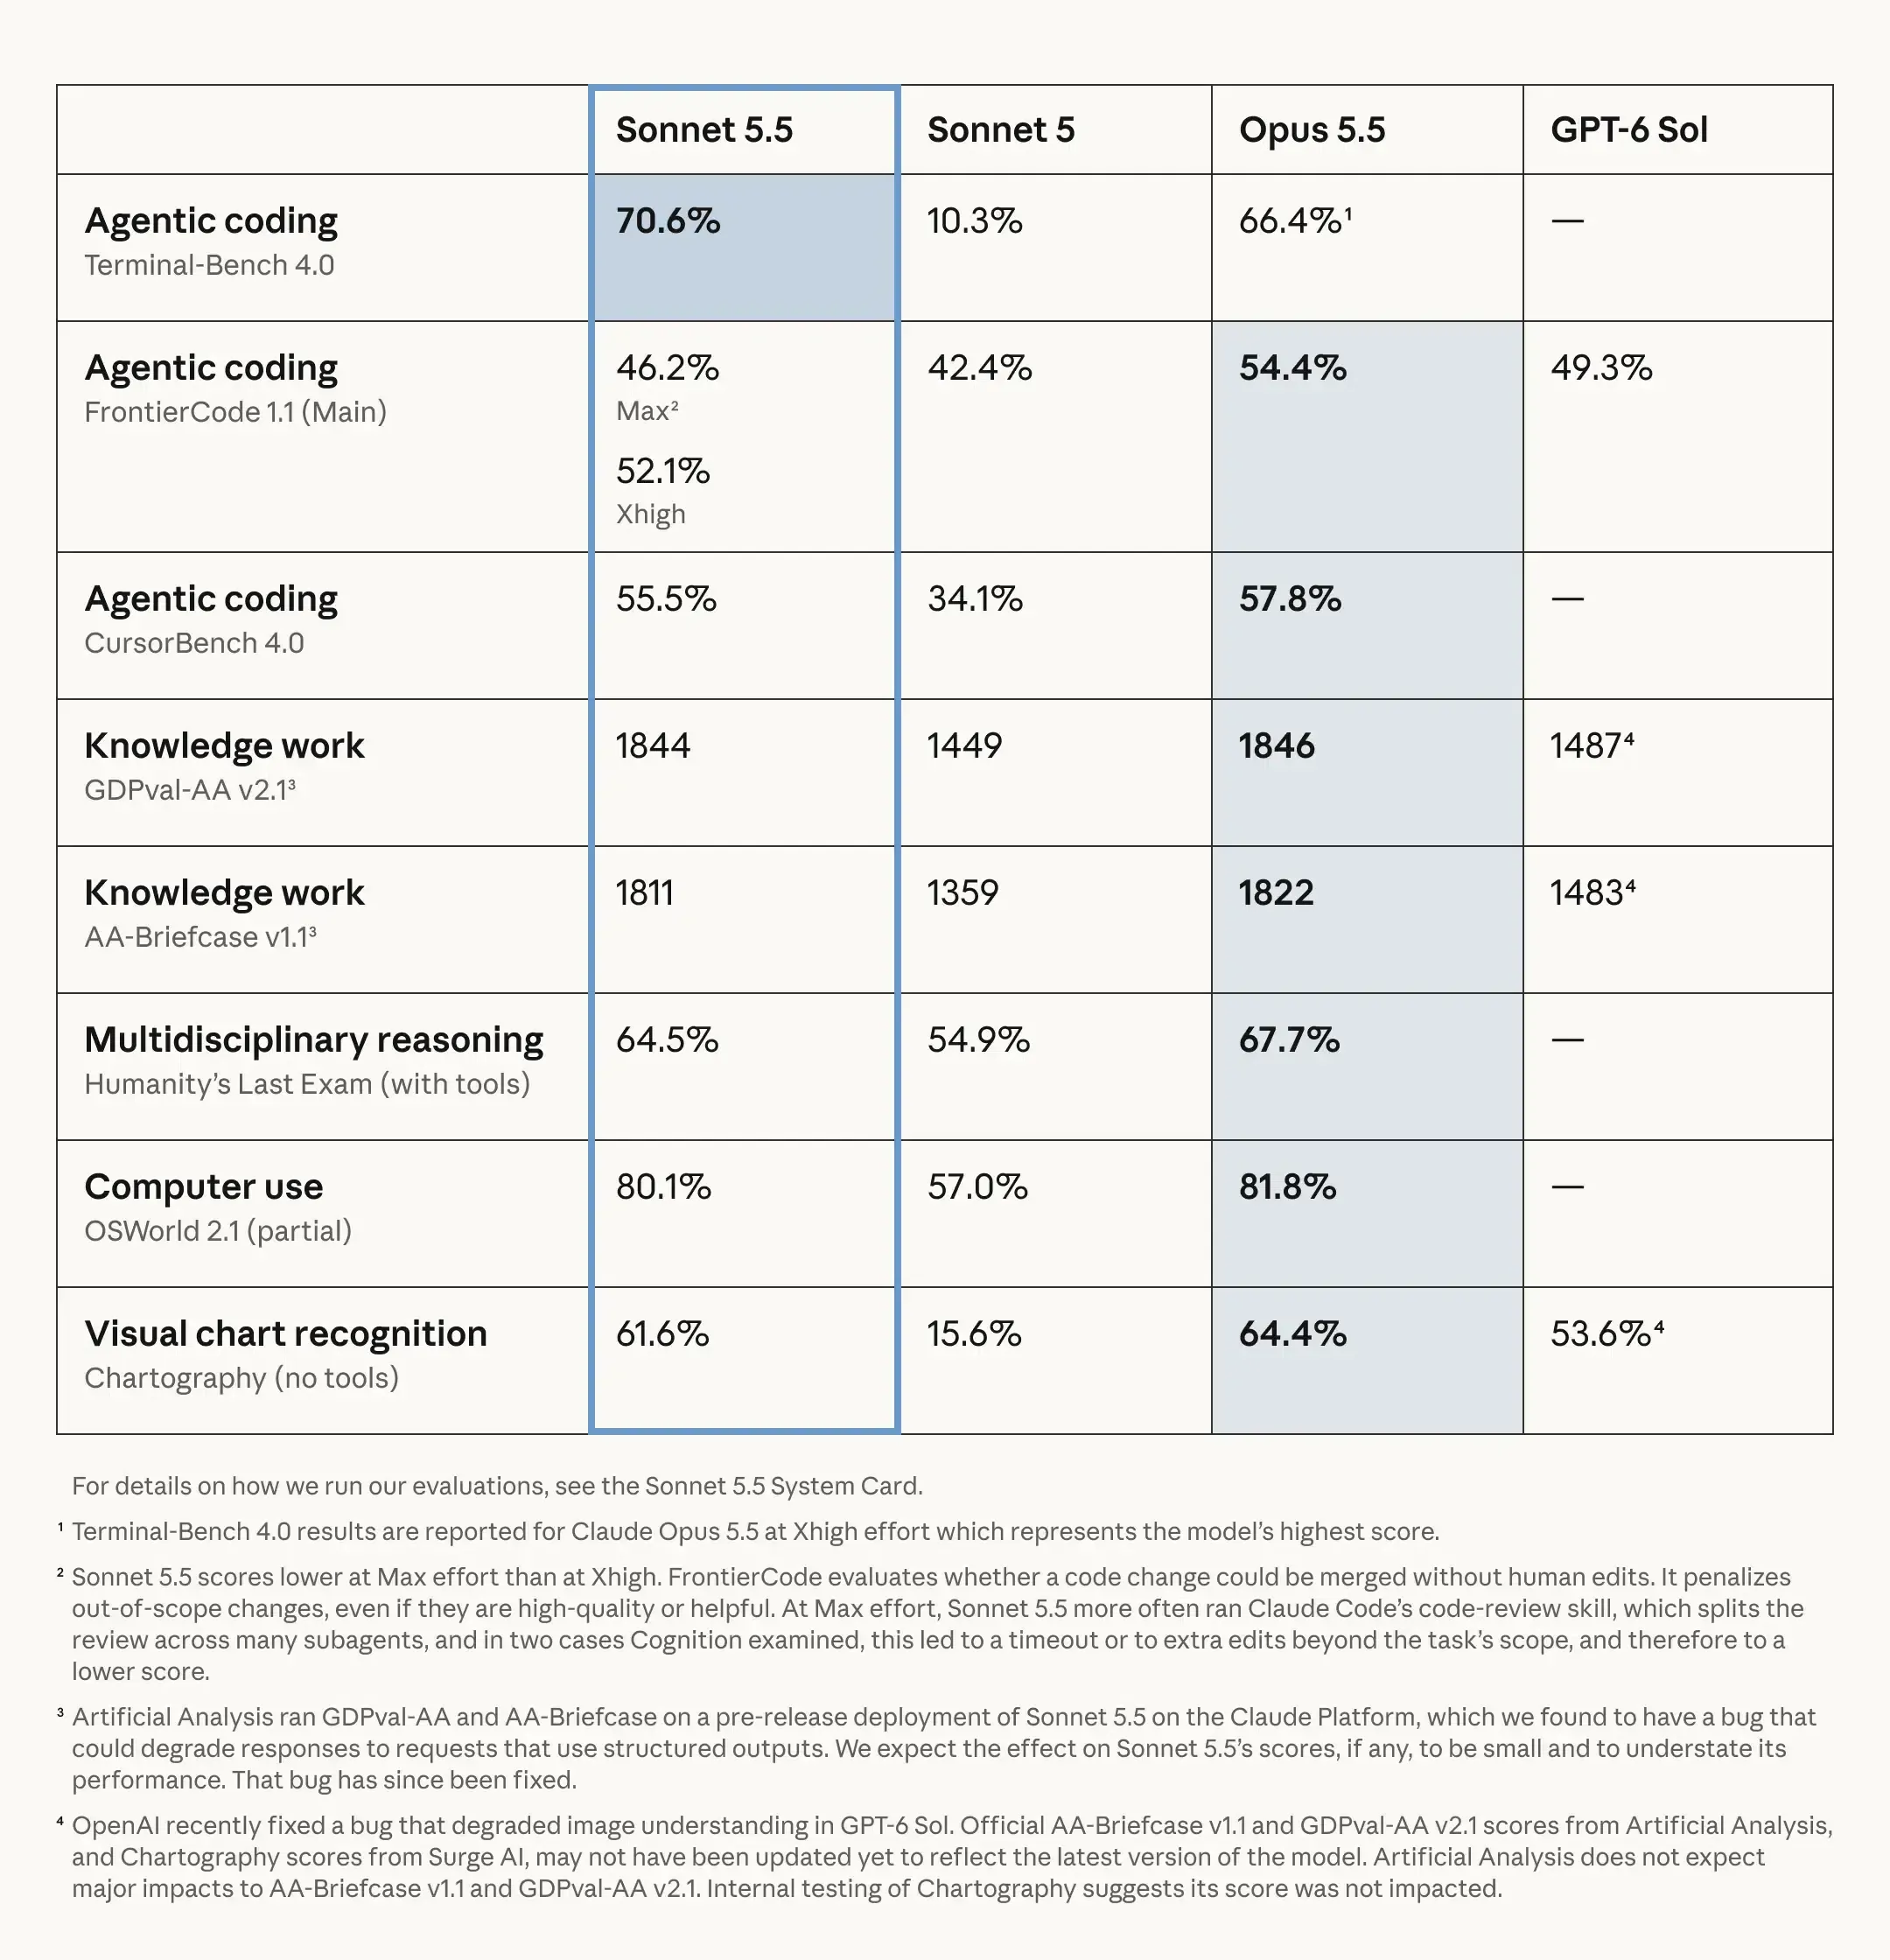
- Dans l'évaluation de codage agentique Terminal-Bench 4.0, Sonnet 5.5 a obtenu un score de 70,6 %, surpassant le modèle phare Claude Opus 5.5 (66,4 %) et Sonnet 5 (10,3 %).
- La tarification des jetons API reste fixée à 2 $ par million de jetons en entrée et 10 $ par million de jetons en sortie, la réduction des coûts étant obtenue grâce à un nombre réduit d'étapes d'exécution et à des appels d'outils par lots.
La viabilité commerciale du déploiement d'agents d'ingénierie logicielle autonomes s'est historiquement heurtée à des contraintes économiques sévères. L'exécution d'outils de développement multi-étapes qui inspectent les bases de code, exécutent des commandes shell et corrigent les tests unitaires de manière itérative consomme des volumes massifs de jetons. Bien que les modèles de pointe démontrent une profondeur de raisonnement remarquable, leurs coûts élevés en jetons et leurs latences de génération accrues rendent l'exécution continue sans surveillance coûteuse pour les entreprises de logiciels en phase de croissance.
Lors de l'évaluation de l'infrastructure de développement, la tarification API affichée occulte souvent le coût réel de réalisation d'un travail. Un modèle avec une tarification par jeton basse qui boucle sur des dizaines d'appels d'outils répétitifs et de tentatives finit par coûter beaucoup plus cher qu'un modèle qui résout les problèmes en moins d'étapes d'exécution. Cette dynamique est explorée dans les rapports de l'industrie sur Sonnet 5.5, soulignant comment les coûts de réalisation des tâches se découplent des prix catalogue des jetons.
Anthropic a structuré Claude Sonnet 5.5 pour traiter directement ces goulots d'étranglement opérationnels. Tout en maintenant les tarifs API de base à 2 $ par million de jetons en entrée et 10 $ par million de jetons en sortie, le modèle atteint jusqu'à 30 % de réduction des coûts nets par tâche en nécessitant beaucoup moins d'étapes de raisonnement. Les rapports de tests clients publiés par Anthropic mettent en lumière des gains d'efficacité notables sur les charges de travail en production :
- Box a rapporté que Sonnet 5.5 fonctionnait 2,4 fois plus vite tout en utilisant 12 % de jetons en moins pour revérifier les documents sources et identifier les régressions de code.
- Zendesk a observé que les tickets de support étaient traités 20 % plus rapidement avec moins d'erreurs de décision automatisées que les modèles en production existants.
- Slack a démontré que le modèle surpassait Sonnet 5 lors des évaluations de bots hors ligne sans modification des invites, consommant environ 14 % de jetons de sortie en moins.
- Lovable a constaté que Sonnet 5.5 nécessitait environ un tiers d'appels d'outils en moins et moitié moins d'exécutions shell lors des builds d'applications automatisés.
- Base44 a vérifié que le modèle terminait les builds d'applications complets en une moyenne de 3,6 itérations, contre 7,7 itérations pour Opus 5.
Ces résultats illustrent comment l'efficacité d'exécution modifie fondamentalement la productivité des développeurs. En réduisant les échecs d'appels d'outils et en éliminant les itérations redondantes, les modèles intermédiaires fournissent une base durable pour l'automatisation continue en entreprise.
Analyse technique : évaluation des benchmarks de codage et mise à l'échelle des sous-agents
L'émergence de modèles intermédiaires surpassant les fleurons sur des benchmarks techniques spécifiques reflète un changement dans le post-entraînement des modèles de fondation. Les lois de mise à l'échelle initiales suggéraient que le nombre brut de paramètres était le déterminant principal de l'intelligence d'un modèle. Cependant, les tâches agentiques complexes — telles que la navigation dans les environnements de terminal et l'édition de référentiels tentaculaires — dépendent fortement de la gestion du contexte, de la discipline dans l'utilisation des outils et du contrôle du périmètre.
Les modèles phares comme Opus 5.5 possèdent une capacité de raisonnement immense, excellant dans les décisions architecturales ambiguës et ouvertes. Pourtant, une profondeur de raisonnement étendue peut occasionnellement introduire une surcharge opérationnelle sur des tâches strictement définies. Dans les évaluations du benchmark FrontierCode, par exemple, Anthropic a noté que Sonnet 5.5 en effort "Max" obtenait un score inférieur à l'effort "Xhigh" car il invoquait plus fréquemment la compétence de révision de code de Claude Code. Cette compétence divisait les révisions entre plusieurs sous-agents, ce qui, dans les cas examinés, a conduit à des délais d'attente ou à des modifications hors périmètre pénalisées par le système de benchmark. À l'inverse, Sonnet 5.5 fonctionnant à un effort standard est particulièrement bien adapté à une exécution contrainte et bien cadrée : il analyse rapidement les structures de référentiel, évalue les modifications proposées et opère dans des limites de fichiers définies.
Parité des benchmarks : Terminal-Bench, CursorBench et GDPval-AA
Les évaluations publiées par Anthropic montrent que Sonnet 5.5 égale ou dépasse les benchmarks de haut niveau dans les domaines techniques courants. Sur Terminal-Bench 4.0, qui évalue la résolution de problèmes en ligne de commande multi-étapes, Sonnet 5.5 a obtenu un score de 70,6 %, surpassant Opus 5.5 (66,4 %) et Sonnet 5 (10,3 %). Sur CursorBench 4.0, dérivé de sessions réelles de développeurs Cursor, Sonnet 5.5 a atteint 55,5 %, ne devançant Opus 5.5 (57,8 %) que de deux points de pourcentage. De plus, sur GDPval-AA v2.1, mesurant les tâches professionnelles réelles à travers 44 métiers, Sonnet 5.5 a obtenu un score Elo de 1844, suivant de près Opus 5.5 à 1846.
Pour examiner comment les modèles rationalisés optimisent l'exécution autonome, considérons les différences de flux de travail :
[Boucle d'agent phare monolithique]
  Invite utilisateur ──> Chaîne de raisonnement lourde ──> Appels d'outils tentaculaires (consommation élevée de jetons) ──> Risque de sur-édition & délais d'attente

[Boucle d'agent intermédiaire rationalisée]
  Invite utilisateur ──> Mappage d'intention cadré ──> Appels d'outils par lots ──> Moins d'étapes d'exécution ──> Correctif concis livré
Cette boucle d'exécution rationalisée peut réduire les opportunités de dérive contextuelle et les allers-retours inutiles. Anthropic signale une génération de sortie plus rapide de 30 %+ ainsi qu'une réduction du nombre d'étapes par rapport à Sonnet 5. Le modèle regroupe les appels d'outils, minimisant la latence réseau des allers-retours entre l'exécution de l'agent et les environnements hôtes.
Sonnet 5.5 introduit également une infrastructure de sécurité de premier ordre dans la catégorie intermédiaire. Il s'agit de la première variante Sonnet à être déployée avec des protections de cybersécurité similaires à Opus 5.5. Les tâches de découverte de vulnérabilités à haut risque reviennent automatiquement aux architectures antérieures, tandis que les défenseurs approuvés reçoivent des autorisations par paliers via le Cyber Verification Program. De plus, le système intègre des classificateurs de sécurité conçus pour réduire l'extraction de raisonnement à l'échelle industrielle et maintenir la pensée préservée liée au compte d'origine.
Stratégie architecturale : allocation des charges de travail entre les modèles de pointe et intermédiaires
Alors que les modèles de fondation d'IA se bifurquent entre moteurs de raisonnement ultra-profonds et modèles d'exécution agiles, les leaders en ingénierie doivent réévaluer la manière dont ils allouent les niveaux de modèles tout au long du cycle de développement logiciel. Le déploiement d'un seul modèle phare sur l'ensemble d'un pipeline d'ingénierie introduit une latence et un coût inutiles. Au lieu de cela, l'infrastructure de développement moderne repose de plus en plus sur le routage dynamique des modèles, en assignant les tâches en fonction de la complexité structurelle.
Lors de l'architecture des flux de travail de production, les équipes doivent peser les compromis entre raisonnement conceptuel profond et résolution de tâches à haut débit. Bien que les modèles phares restent indispensables pour la planification architecturale large, les modèles intermédiaires gèrent la grande majorité de l'exécution de code au quotidien avec une réactivité supérieure.
La matrice de décision suivante présente l'alignement technique à travers les niveaux de modèles :
| Catégorie de charge de travail | Choix de modèle principal | Profil de coût | Profil de latence | Idéal pour |
|---|---|---|---|---|
| Corrections de bugs routiniers & révisions de PR | Claude Sonnet 5.5 | Bas (2 $ / 10 $ par 1M de jetons) | Rapide (30 %+ plus rapide en génération) | Tâches logicielles quotidiennes bien cadrées et vérifications CI/CD à haut volume |
| Architecture de codebase complète & migrations | Claude Opus 5.5 | Haut (4 $ / 20 $ par 1M de jetons) | Cycles de réflexion adaptatifs et profonds | Refactorisation complexe et ambiguë à travers des référentiels tentaculaires |
| Prototypage interactif & design UI | Claude Sonnet 5.5 | Bas (2 $ / 10 $ par 1M de jetons) | Itération rapide et réactive | Conception de flux utilisateurs, génération de diagrammes et échafaudage frontend |
| Recherche en cybersécurité avancée | Modèles Claude à accès vérifié | Dépend du modèle et du niveau d'accès | Vérification multi-étapes approfondie | Recherche en sécurité à haut risque autorisée sous les programmes de vérification Anthropic |
Anthropic structure les capacités de cybersécurité par le biais de protections par paliers. Alors que la remédiation de vulnérabilités routinière se déroule normalement sur Sonnet 5.5, les tâches de sécurité à risque plus élevé reviennent automatiquement aux architectures antérieures. Pour les défenseurs autorisés menant des recherches en sécurité avancées, l'accès à des capacités étendues via Sonnet 5.5, Opus 5.5 et les modèles Mythos est géré par le Cyber Verification Program multi-niveaux.
En établissant des règles de routage dynamiques, les organisations d'ingénierie peuvent diriger les révisions de pull requests routinières, la génération de tests unitaires et la localisation de bugs vers Sonnet 5.5. Cela préserve la capacité de haut niveau d'Opus pour la refactorisation architecturale complexe, maintenant ainsi les budgets d'ingénierie prévisibles sans compromettre la fiabilité des logiciels.
Listes de contrôle d'intégration : opérationnaliser Sonnet 5.5 dans le CI/CD d'entreprise
À mesure que les organisations logicielles intègrent des modèles rapides et rentables comme Sonnet 5.5 dans leurs pipelines de production, les équipes d'ingénierie doivent établir des calendriers de gouvernance robustes. Maximiser les économies nécessite d'aligner les paramètres de l'API avec la complexité de la tâche tout en empêchant la dérive non surveillée des agents.
Liste de contrôle pour l'implémentation par les développeurs
- Configurer les niveaux d'effort dynamiques : Utilisez les paramètres d'effort natifs du modèle — par défaut sur Medium dans les applications Claude et Claude Code, et High sur la plateforme Claude — pour équilibrer la profondeur de raisonnement avec la dépense en jetons.
- Tirer parti de la mise en cache des invites (Prompt Caching) : Implémentez la mise en cache sur les invites système statiques et les cartes de référentiel pour garantir une remise de 90 % sur les jetons de lecture en cache (0,20 $ par million de jetons).
- Déployer le traitement par lots asynchrone : Routez les évaluations hors temps réel, les audits de code automatisés et les migrations par lots via les API batch pour obtenir une réduction de 50 % sur les coûts standard des jetons.
- Intégrer des systèmes de secours (Fail-Safe) : Établissez des disjoncteurs programmatiques qui terminent ou redirigent gracieusement les demandes si les boucles d'outils automatisées dépassent les budgets d'itération prédéfinis.
Liste de contrôle pour la gouvernance & l'infrastructure
- Réévaluer l'économie des unités d'abonnement : Calculez les coûts de calcul marginaux par développeur actif pour déterminer si les modèles intermédiaires à haute vitesse permettent d'offrir des quotas d'utilisation plus élevés ou des tarifs réduits.
- Surveiller les ratios d'itération : Mesurez le nombre moyen d'exécutions d'outils nécessaires pour résoudre les tâches des utilisateurs ; la réduction du nombre d'itérations améliore directement la satisfaction des développeurs.
- Configurer le traitement uniquement aux États-Unis si nécessaire : Pour les clients entreprises réglementés avec des exigences de résidence des données nationales, configurez des points de terminaison d'inférence uniquement aux États-Unis (disponibles à 1,1x le tarif selon les conditions entreprises qualifiantes).
- Vérifier l'éligibilité à la rétention zéro des données : Confirmez le statut de non-rétention des données avec le fournisseur d'API, assurant la conformité de l'entreprise tout en notant que les fonctionnalités spécialisées comme les caches d'invites persistants peuvent fonctionner sous des conditions de rétention distinctes.
En adoptant ces pratiques opérationnelles structurées, les organisations logicielles peuvent convertir la vitesse algorithmique et l'efficacité des jetons en gains de développement prévisibles.
Questions fréquentes (FAQ)
Pourquoi Sonnet 5.5 coûte-t-il moins cher par tâche si la tarification par jeton est identique à celle de Sonnet 5 ?
Claude Sonnet 5.5 peut-il remplacer Opus 5.5 pour l'ingénierie logicielle ?
Comment la mise en cache des invites (prompt caching) impacte-t-elle les coûts d'exploitation des agents de codage ?
Points clés pour les équipes d'ingénierie
Le lancement de Claude Sonnet 5.5 reflète une évolution de l'industrie, passant d'une mise à l'échelle non contrainte des paramètres vers l'efficacité des tâches opérationnelles. Les plateformes d'ingénierie logicielle à haut débit ne nécessitent pas nécessairement la surcharge de calcul des modèles phares pour chaque phase opérationnelle. Lorsqu'un modèle intermédiaire résout de manière fiable les tâches de codebase cadrées en moins d'itérations, le développement logiciel automatisé devient nettement plus rentable à déployer à grande échelle.
Capitaliser sur ces gains d'efficacité nécessite d'établir une architecture disciplinée : routage dynamique des tâches basé sur la complexité, application des limites d'utilisation des outils et application systématique de la mise en cache des invites. À mesure que les fournisseurs de modèles de fondation continuent d'optimiser l'efficacité des jetons parallèlement au raisonnement brut, les équipes d'ingénierie qui conçoivent des pipelines modulaires et surveillés en termes de coûts maintiendront les flux de travail de production les plus durables et évolutifs.
Références
-
Anthropic. Présentation de Claude Sonnet 5.5.
-
Anthropic. Fiche système de Claude Sonnet 5.5.
-
Anthropic. Tarification de l'API Claude et résidence des données.
-
Anthropic. Conditions commerciales de service et politique de rétention des données.
-
VentureBeat. Anthropic lance Claude Sonnet 5.5 avec une réduction de 30 % des coûts par tâche.
-
TechCrunch. Anthropic publie Sonnet 5.5 en tant que partenaire de travail nettement moins cher et plus rapide.
-
9to5Mac. Anthropic améliore Claude avec le nouveau modèle Sonnet 5.5.
Share this article



